Saltar para o conteúdo
Comece grátis

Perfil do autor

Suciu Dan

Co-fundador25 artigos

Suciu Dan é cofundador da WebScrapingAPI e escreve guias práticos, voltados para programadores, sobre web scraping em Python, web scraping em Ruby e infraestruturas de proxy.

Suciu Dan, Co-fundador @ WebScrapingAPI

Artigos publicados

25 artigos

Python web scrapingRuby web scrapingproxy infrastructureanti-bot resilienceGuidesScience of Web ScrapingUse Cases

Artigos publicados

Web Scraping com AWS Lambda: Guia para Python e Java 2026
Guias

Web Scraping com AWS Lambda: Guia para Python e Java 2026

TL;DR: Resumo: A extração de dados da Web com o AWS Lambda funciona melhor quando cada invocação é curta, delimitada e pode ser repetida de forma independente. Comece com HTTP direto, AWS SAM e S3 e, só depois, adicione SQS, contentores, renderização no navegador, proxies ou uma camada de recuperação gerida, apenas quando a carga de trabalho demonstrar que precisa deles.

Suciu Dan32 min read
Ler artigo

Como utilizar o GoSpider: rastrear, limpar URLs e extrair dados
Guias

Como utilizar o GoSpider: rastrear, limpar URLs e extrair dados

TL;DR: Resumo: O GoSpider é um rastreador de linha de comandos destinado a descobrir URLs, não um extrator completo de dados estruturados. Este guia sobre como utilizar o GoSpider mostra como realizar um rastreio limitado, gerir resultados de forma organizada, fazer a transferência de dados do Colly para CSV e seguir um percurso de diagnóstico para respostas 403 ou páginas que exijam renderização em JavaScript.

Suciu Dan23 min read
Ler artigo
Como fazer o Scrape Redfin: Guia Python para Dados de Propriedade
Guias

Como fazer o Scrape Redfin: Guia Python para Dados de Propriedade

TL;DR: A Redfin expõe pontos de extremidade de API ocultos que retornam JSON estruturado para listagens de propriedades, tornando possível ignorar totalmente a análise HTML frágil. Este guia orienta-o na construção de um scraper Python que extrai dados de aluguer e venda, pesquisa por localização, monitoriza novas listagens através de sitemaps XML e exporta resultados limpos para CSV ou JSON.

Suciu Dan14 min read
Ler artigo
Como analisar JSON em Python: desde respostas de API até JSON oculto em páginas web
Guias

Como analisar JSON em Python: desde respostas de API até JSON oculto em páginas web

TL;DR: Analise JSON em Python com json.loads e json.load, corrija erros de descodificação, valide dados aninhados, processe ficheiros de grande dimensão e extraia JSON-LD ou __NEXT_DATA__ ocultos em páginas web — além dos envelopes da WebScrapingAPI.

Suciu Dan13 min read
Ler artigo
Tutorial de Python do Nodriver: Extração discreta de dados da Web — Do primeiro script à produção
A ciência da extração de dados da Web

Tutorial de Python do Nodriver: Extração discreta de dados da Web — Do primeiro script à produção

TL;DR: Resumo: O Nodriver é uma biblioteca Python assíncrona que controla o Chromium através do Chrome DevTools Protocol, sem Selenium nem o binário chromedriver. Utilize-o quando um navegador furtivo auto-hospedado, mais próximo de uma sessão real do Chrome, é melhor do que uma stack WebDriver, mas saiba que, por si só, não elimina riscos de IP, TLS ou comportamento. Este tutorial vai de um primeiro script à produção em contentores e a uma Browser API alojada.

Suciu Dan15 min read
Ler artigo
Como lidar com URLs de redirecionamento do Google /goto e tokens CAES num scraper de SERP
A ciência da extração de dados da Web

Como lidar com URLs de redirecionamento do Google /goto e tokens CAES num scraper de SERP

TL;DR: Resumo: Os URLs /goto do Google com um token CAES, e os wrappers /url mais antigos, são camadas de redirecionamento, não destinos, por isso um scraper de SERP que trata cada href como final estraga o acompanhamento de posições e as bases de links. Prefira uma API de SERP estruturada quando devolve os links de destino. Quando tiver de analisar HTML, classifique cada href, elimine redirecionamentos duplicados e resolva-os com um GET simples. Não desencripte o CAES.

Suciu Dan13 min read
Ler artigo
As 10 melhores ferramentas de web scraping com IA para 2026
Guias

As 10 melhores ferramentas de web scraping com IA para 2026

TL;DR: Não existe um único scraper de IA que seja ideal para todas as tarefas. Compare 10 ferramentas com base no método de extração, tipo de utilizador, operações e custo e, em seguida, recorra a um plano de teste prático para escolher a opção mais adequada.

Suciu Dan24 min read
Ler artigo
XPath Web Scraping: Um guia prático com exemplos em Python
Guias

XPath Web Scraping: Um guia prático com exemplos em Python

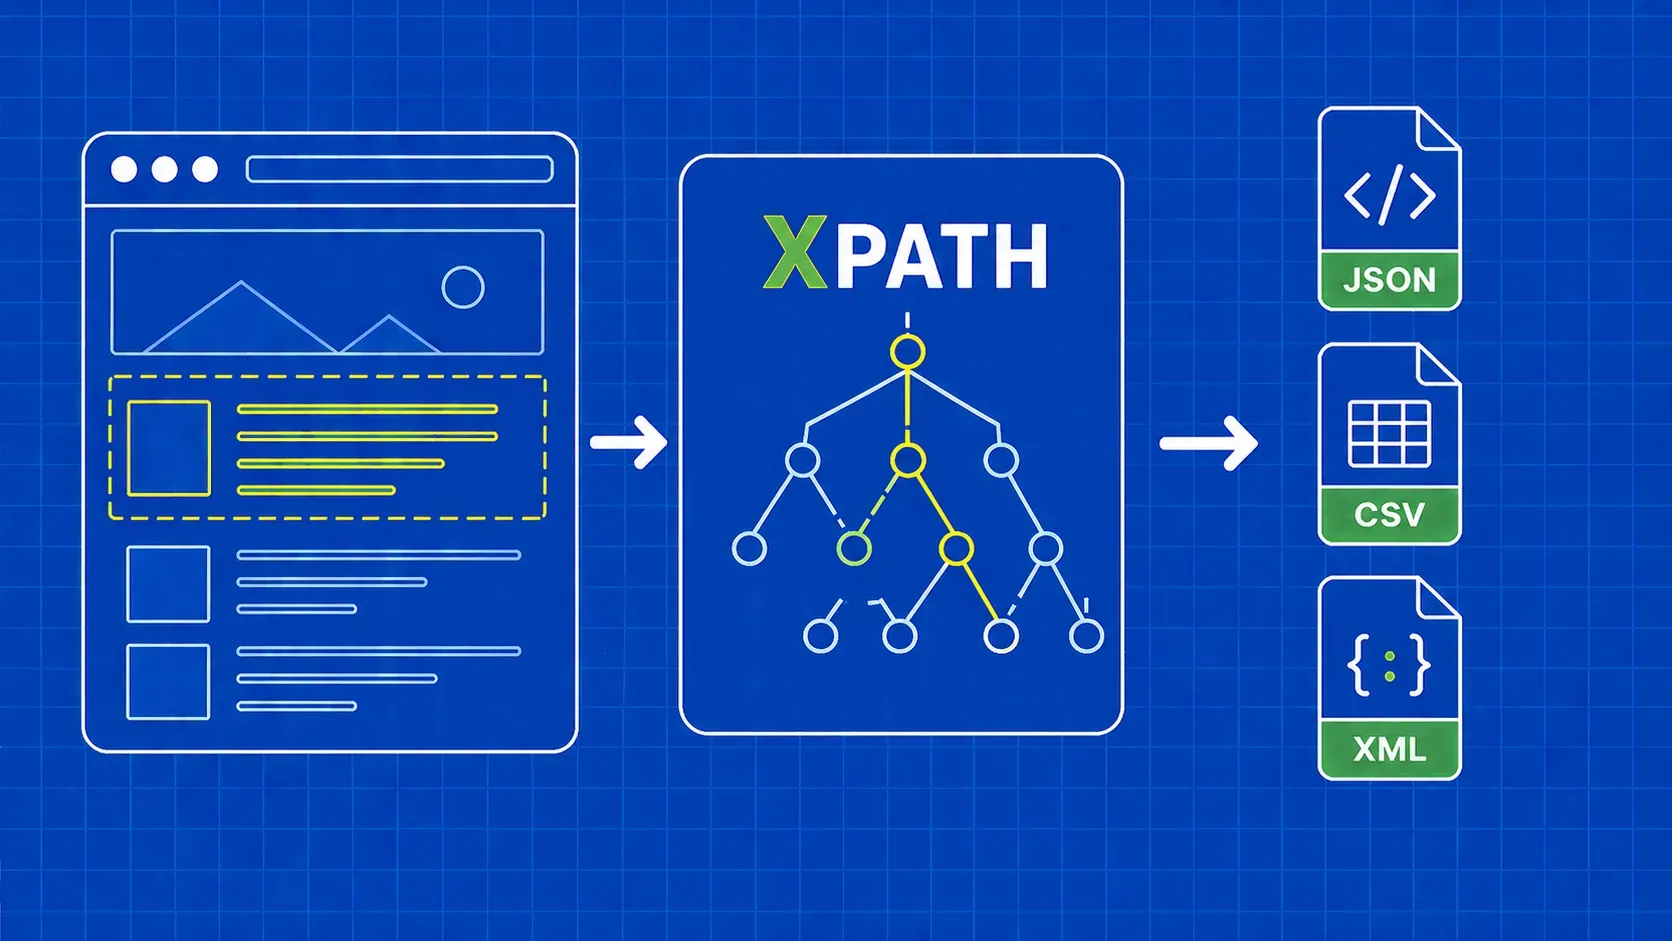
TL;DR: XPath é uma linguagem de consulta para navegar em árvores HTML/XML por caminho, atributo ou conteúdo de texto. Este guia aborda a sintaxe, os eixos e as funções XPath e, em seguida, mostra scrapers Python funcionais com lxml e Selenium. Você também terá uma folha de dicas consolidada e uma seção de solução de problemas para os erros mais comuns do XPath.

Suciu Dan11 min read
Ler artigo
Cabeçalhos de resposta HTTP no cURL: Cada flag, técnica e receita de scripting
A ciência da extração de dados da Web

Cabeçalhos de resposta HTTP no cURL: Cada flag, técnica e receita de scripting

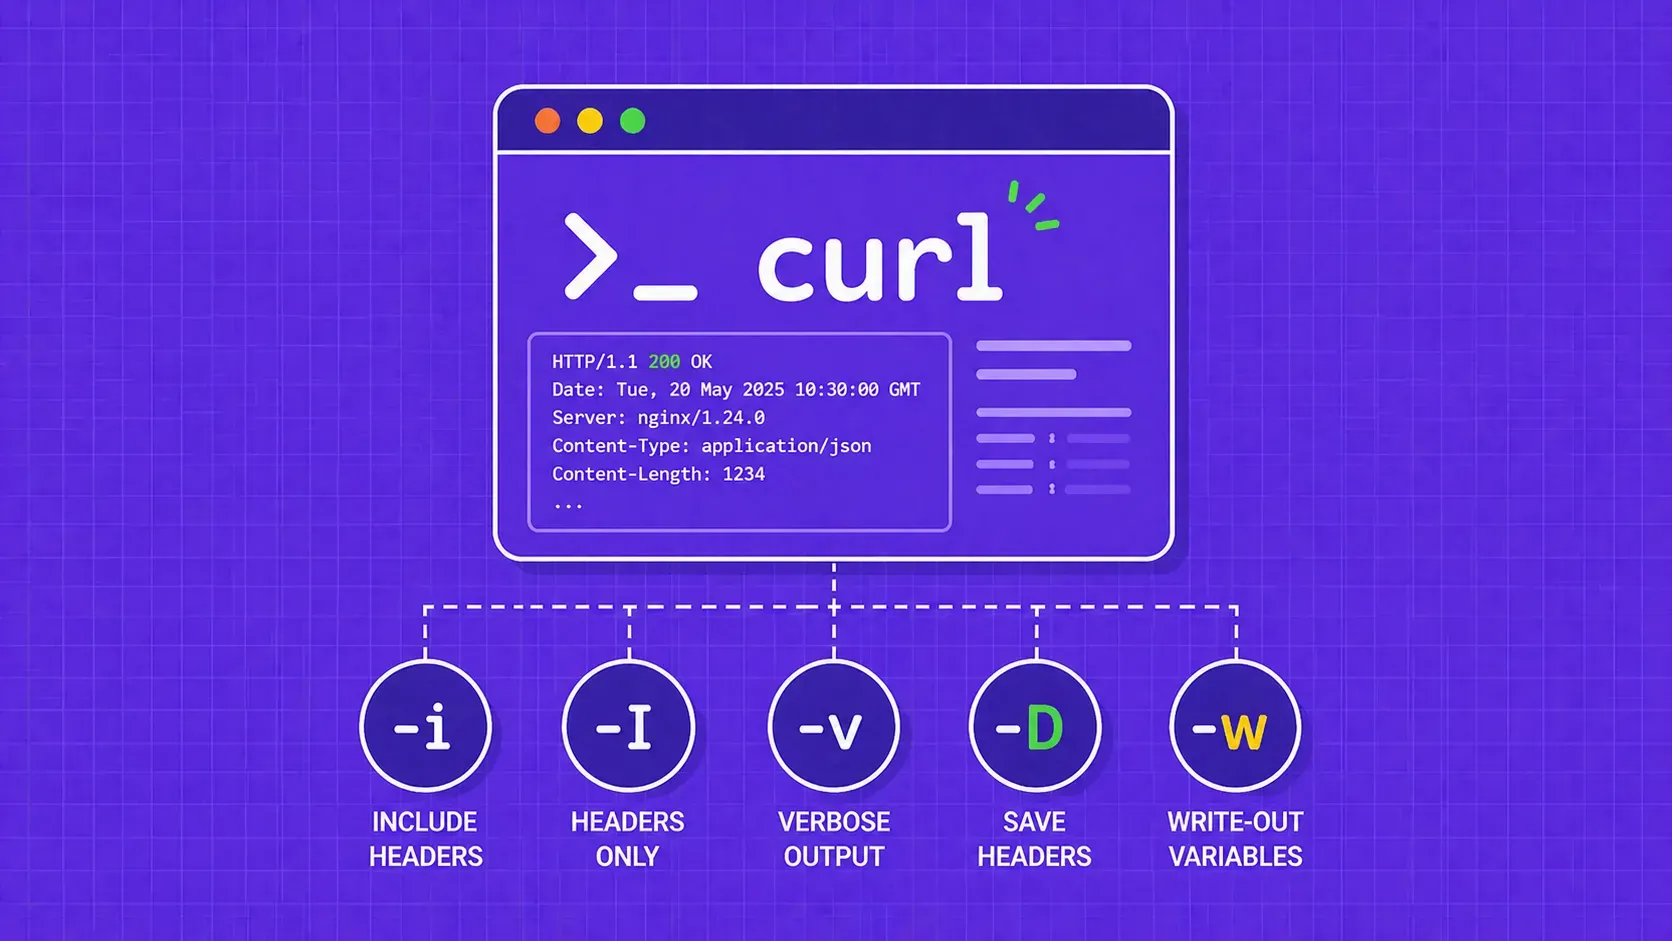
TL;DR: O cURL esconde os cabeçalhos de resposta por padrão. Use -i para ver os cabeçalhos junto com o corpo, -I para uma solicitação HEAD que retorna apenas cabeçalhos, -v para depuração completa de solicitação/resposta e -D para salvar cabeçalhos em um arquivo. Para scripts modernos, o cURL 7.83+ permite extrair cabeçalhos individuais ou despejar todos eles como JSON com a opção -w write-out.

Suciu Dan12 min read
Ler artigo
O que é um navegador sem cabeça? Arquitetura, casos de utilização e principais ferramentas
A ciência da extração de dados da Web

O que é um navegador sem cabeça? Arquitetura, casos de utilização e principais ferramentas

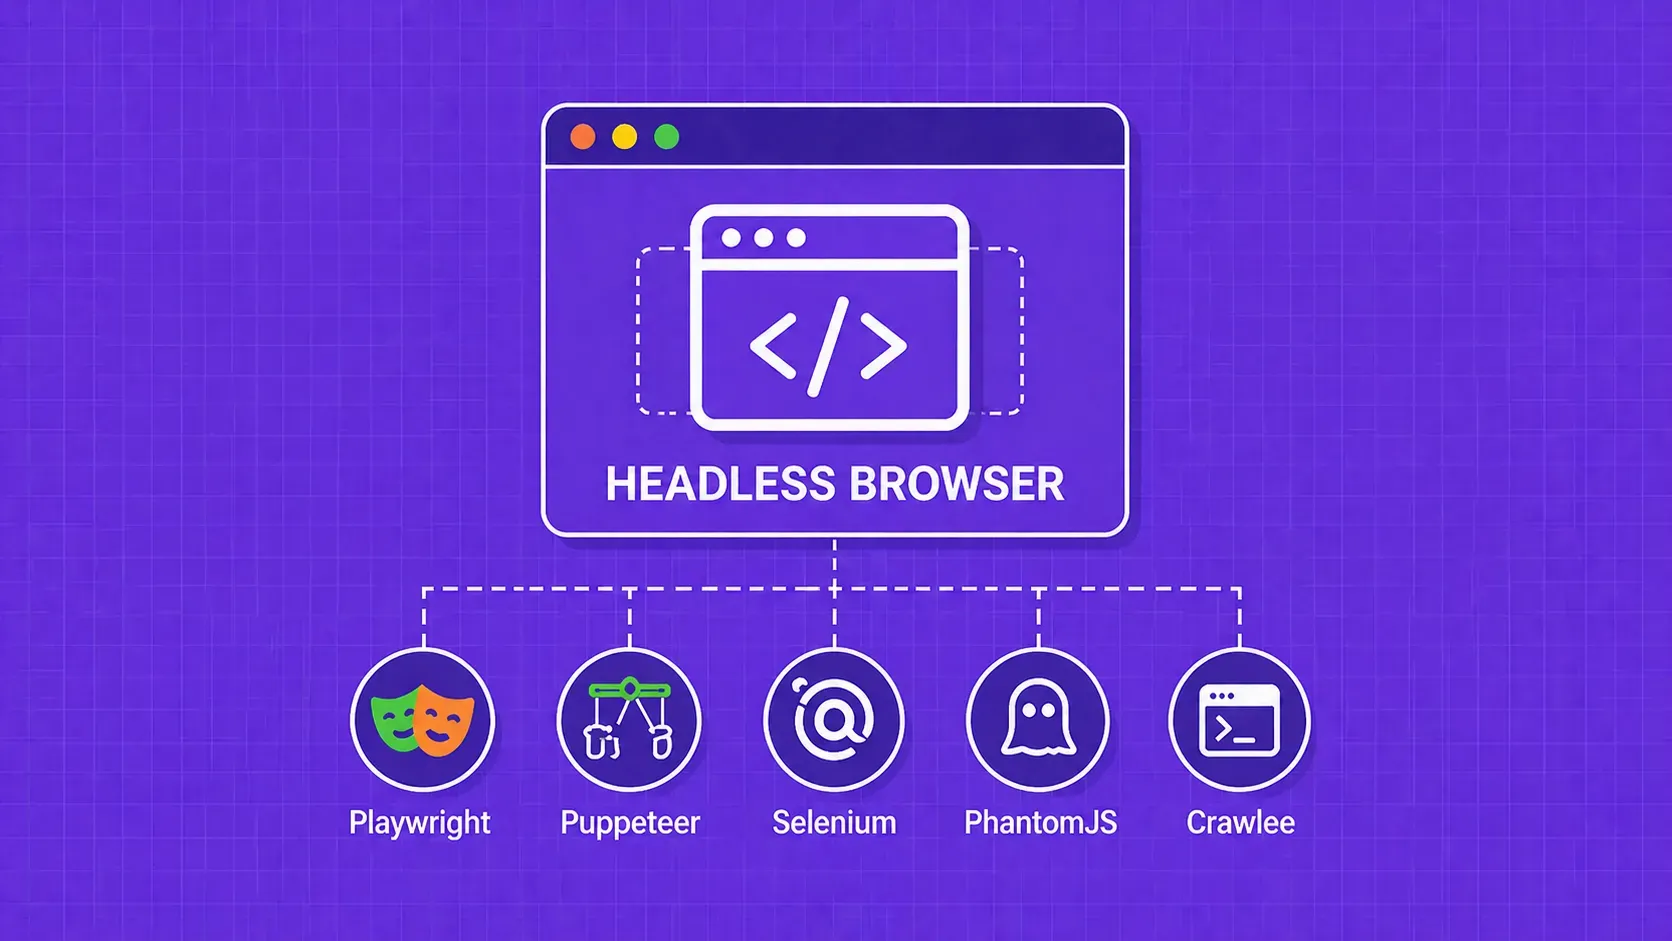
TL;DR: Um navegador sem cabeça é um navegador web que funciona sem uma interface gráfica visível, controlado inteiramente através de código ou instruções de linha de comando. Os desenvolvedores usam navegadores headless para testes automatizados, raspagem da Web, monitoramento de desempenho e, cada vez mais, para alimentar agentes de IA. Este guia aborda como eles funcionam internamente, quando escolher um em vez de um navegador normal e quais estruturas valem o seu tempo.

Suciu Dan15 min read
Ler artigo
Guia da API de extração de resultados de pesquisa (SERP): Google, Bing, DuckDuckGo, Yandex
Guias

Guia da API de extração de resultados de pesquisa (SERP): Google, Bing, DuckDuckGo, Yandex

TL;DR: Envie o seu primeiro pedido à API SERP da WebScrapingAPI com a chave definida numa variável de ambiente; em seguida, filtre os resultados do Google por país, idioma e dispositivo; leia os ficheiros JSON do Google e do Bing de forma defensiva; extraia você mesmo o HTML do DuckDuckGo e do Yandex; execute tarefas assíncronas do Google; repita a tentativa de acordo com os códigos de erro documentados e defina um plano com base nos preços do Google a partir de outubro de 2026.

Suciu Dan25 min read
Ler artigo
O que são dados financeiros? Tipos, métodos de recolha e ferramentas de análise
Casos de utilização

O que são dados financeiros? Tipos, métodos de recolha e ferramentas de análise

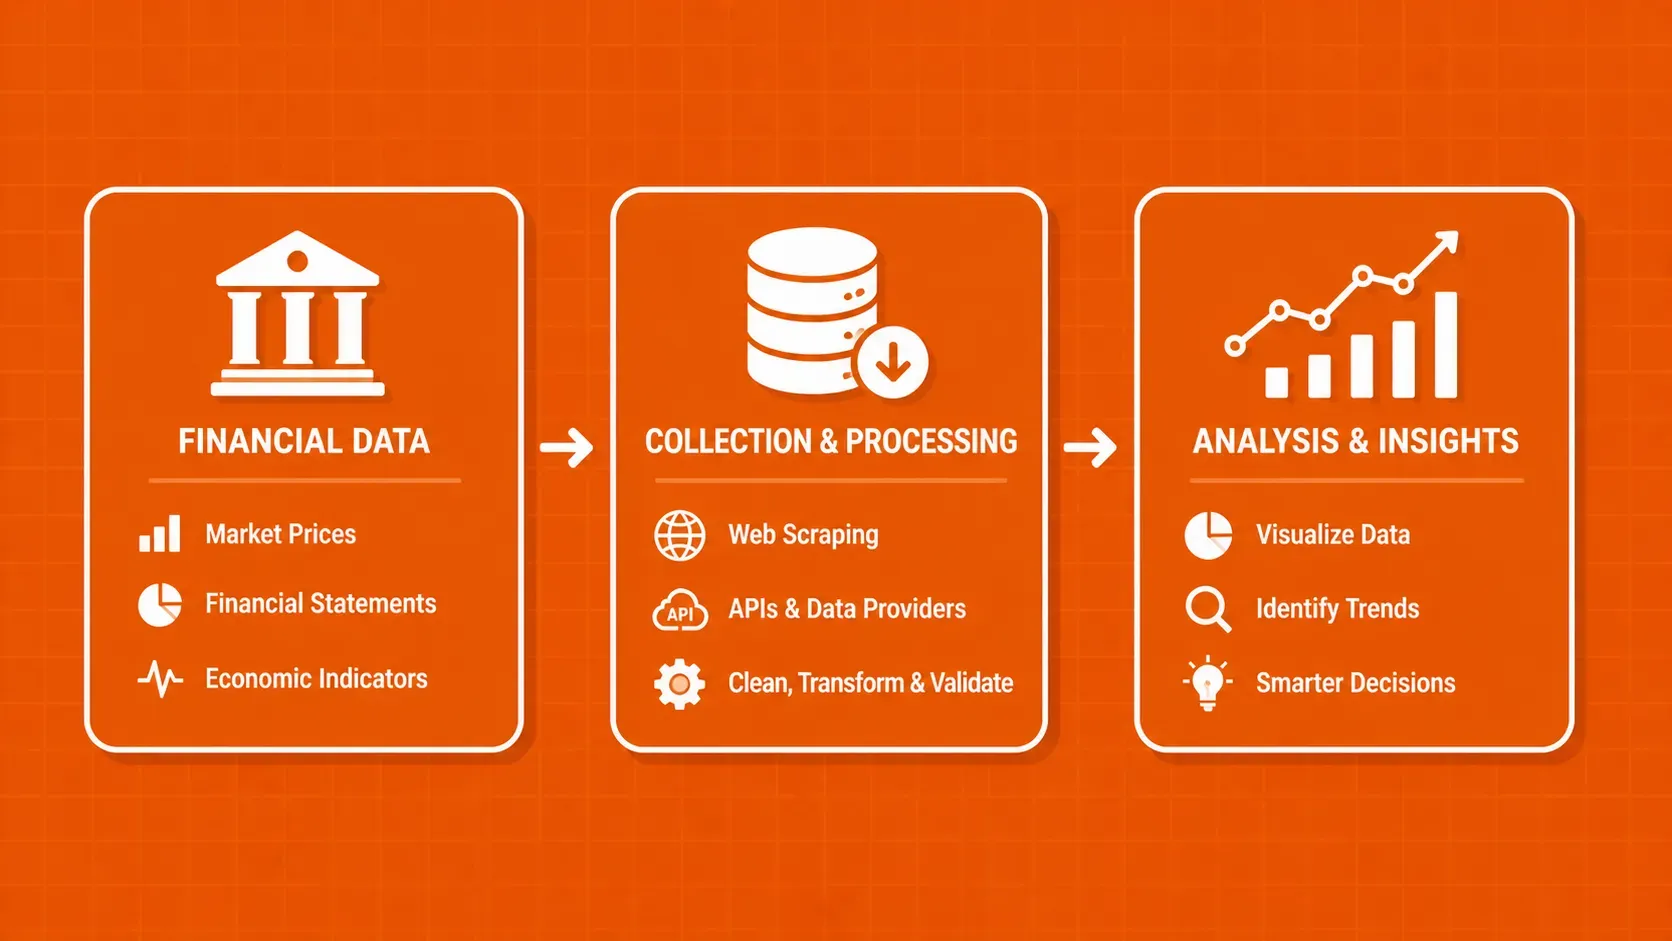
TL;DR: Os dados financeiros são a coleção de registos quantitativos (receitas, despesas, activos, passivos, fluxo de caixa) que as organizações e os indivíduos utilizam para tomar decisões económicas informadas. Este guia analisa as quatro principais demonstrações financeiras, compara as fontes de dados tradicionais e alternativas, apresenta métodos de recolha modernos e abrange as ferramentas em que os profissionais confiam para a análise.

Suciu Dan15 min read
Ler artigo
Explicação da análise de dados: Ferramentas, técnicas e código (2026)
A ciência da extração de dados da Web

Explicação da análise de dados: Ferramentas, técnicas e código (2026)

TL;DR: A análise de dados converte conteúdo bruto (HTML, JSON, XML, PDFs) em campos estruturados que seu código pode realmente usar. Este guia mostra como a análise de dados funciona passo a passo, compara as principais técnicas e bibliotecas e fornece uma estrutura prática para decidir se deve criar ou comprar sua camada de análise.

Suciu Dan16 min read
Ler artigo
Como configurar o proxy Axios no Node.js: Autenticação, rotação, SOCKS5
Guias

Como configurar o proxy Axios no Node.js: Autenticação, rotação, SOCKS5

TL;DR: O Axios encaminha pedidos através de um proxy, aceitando um objeto proxy com anfitrião, porta e campos de autenticação opcionais. Este guia aborda como definir a configuração de proxy do Axios a partir do zero: cabeamento básico, proxies autenticados, tunelamento HTTPS, um sistema de rotação usando interceptores, SOCKS5 via socks-proxy-agent e diagnóstico de erros comuns. Cada snippet é um código Node.js que pode ser copiado e colado.

Suciu Dan11 min read
Ler artigo
Como usar um proxy com HttpClient em C#
Guias

Como usar um proxy com HttpClient em C#

TL;DR: Para usar um proxy com HttpClient em C#, construa um WebProxy, anexe-o a um HttpClientHandler (ou SocketsHttpHandler), e passe esse handler para o construtor do HttpClient. Para produção, troque os loops manuais por IHttpClientFactory, adicione NetworkCredential para proxies autenticados e envolva as chamadas em tentativas com Polly para que IPs mortos não derrubem seu trabalhador.

Suciu Dan18 min read
Ler artigo
Como construir um rastreador da Web em Python: Do início à escala
A ciência da extração de dados da Web

Como construir um rastreador da Web em Python: Do início à escala

TL;DR: Um web crawler python automatiza o trabalho tedioso de seguir links em um site para descobrir e coletar conteúdo. Este guia orienta-o na construção de um de raiz com pedidos e BeautifulSoup, passando depois para Scrapy para rastreio concorrente, pipelines de itens e exportações de dados estruturados. Você também aprenderá como rastrear de forma responsável, girar proxies para evitar bloqueios e lidar com páginas renderizadas em JavaScript.

Suciu Dan31 min read
Ler artigo
Como fazer scraping do LinkedIn em 2026: um guia Python
Guias

Como fazer scraping do LinkedIn em 2026: um guia Python

TL;DR: Raspar o LinkedIn significa trabalhar em torno de uma parede de autenticação agressiva, rastreamento comportamental e impressão digital TLS. Este guia fornece uma árvore de decisão método por página, padrões Python de trabalho para trabalhos, perfis e empresas (API oculta, JSON-LD, Selenium quando necessário) e uma lista de verificação anti-bloqueio consolidada para 2026.

Suciu Dan14 min read
Ler artigo
12 melhores ferramentas de raspagem da Web gratuitas em 2026: comparadas
Guias

12 melhores ferramentas de raspagem da Web gratuitas em 2026: comparadas

TL;DR: As 12 melhores ferramentas gratuitas de raspagem da web em 2026 divididas em quatro grupos: APIs gerenciadas com créditos gratuitos, estruturas de código aberto, extensões de navegador sem código e extratores de IA. Escolha primeiro por caso de uso (raspagem única vs. pipeline programado) e, em seguida, por nível de habilidade. A maioria dos níveis gratuitos cobre a avaliação, não a produção; no momento em que sua taxa de sucesso cai abaixo de ~90% ou você gasta mais horas em blocos do que em dados, é hora de passar para uma API paga.

Suciu Dan29 min read
Ler artigo
A raspagem da Web é legal em 2026? Quadro de conformidade
Guias

A raspagem da Web é legal em 2026? Quadro de conformidade

TL;DR: A raspagem da Web é legal? Normalmente sim, com algumas ressalvas. A legalidade depende do tipo de dados, do caminho de acesso, das jurisdições envolvidas e do que se faz com o resultado. Este guia dá-lhe um veredito direto, uma estrutura de cinco minutos antes da recolha de dados, os casos que interessam e uma lista de verificação que pode executar antes de enviar.

Suciu Dan15 min read
Ler artigo
As melhores APIs de web scraping em 2026: comparação de 12, por funcionalidade e custo
Guias

As melhores APIs de web scraping em 2026: comparação de 12, por funcionalidade e custo

TL;DR: Resumo: A melhor API de web scraping depende da tarefa: uma API de páginas barata ganha em HTML estático, uma opção de renderização ou um navegador alojado em aplicações com muito JavaScript, um endpoint de SERP ou de e-commerce para registos já analisados, e uma API focada em Markdown para pipelines de LLM. Selecione dois ou três fornecedores e compare o custo por página utilizável nos seus URLs: os multiplicadores de créditos e a faturação de falhas decidem o custo real.

Suciu Dan30 min read
Ler artigo
Análise do webscraper.io: Preços, limites e quando mudar de serviço
Guias

Análise do webscraper.io: Preços, limites e quando mudar de serviço

TL;DR: Resumo: O Web Scraper da webscraper.io é uma extensão gratuita para Chrome e Firefox, com uma versão paga, o Web Scraper Cloud, e é uma boa escolha para tarefas recorrentes pequenas e médias em sites públicos comuns. Mantenha-o quando poucas pessoas atualizam alguns sites diária ou semanalmente e alguém mantém os seletores. Mude quando precisar de muitos sites, alvos protegidos ou com muito JavaScript, ou controlo ao nível do código.

Suciu Dan19 min read
Ler artigo
Alternativas ao Puppeteer: Principais ferramentas para raspagem e testes 2026
Guias

Alternativas ao Puppeteer: Principais ferramentas para raspagem e testes 2026

TL;DR: O Puppeteer é ótimo para automação rápida do Chromium, mas seu bloqueio de navegador único, escala pesada de recursos e nenhum suporte anti-bot embutido empurram muitas equipes para alternativas. Este guia divide as alternativas mais fortes do Puppeteer por caso de uso (raspagem, teste E2E, QA entre navegadores, celular), fornece uma tabela de comparação lado a lado e termina com uma estrutura de decisão para que você possa escolher a ferramenta certa sem tentativa e erro.

Suciu Dan17 min read
Ler artigo
Alternativa ao Web Scraper: Adapte primeiro o fluxo de trabalho
Guias

Alternativa ao Web Scraper: Adapte primeiro o fluxo de trabalho

TL;DR: Compare o Octoparse, o Browse AI, o Apify e o Playwright em termos de modelo de criação. Preserve a navegação, registe a identidade e o comportamento de entrega ao substituir o Web Scraper.

Suciu Dan15 min read
Ler artigo
Alternativa ao WebHarvy: Comparar fluxos de trabalho de dados de produtos
Guias

Alternativa ao WebHarvy: Comparar fluxos de trabalho de dados de produtos

TL;DR: Compare o Octoparse, o ParseHub, o Web Scraper e o Apify para a extração de produtos. Verifique as variantes, as ofertas, os artigos em falta e as exportações antes de substituir o WebHarvy.

Suciu Dan16 min read
Ler artigo
Os melhores raspadores da Web do Node.js em 2026: 6 bibliotecas comparadas
Guias

Os melhores raspadores da Web do Node.js em 2026: 6 bibliotecas comparadas

TL;DR: Os melhores raspadores da web Node.js em 2026 se dividem em dois campos: clientes HTTP como Axios e Superagent para páginas estáticas e navegadores sem cabeça como Puppeteer e Playwright para sites com muito JavaScript. Escolha por fluxo de trabalho, não por popularidade, e transfira a renderização para uma API de raspagem gerenciada quando as defesas anti-bot ou a escala começarem a consumir seu tempo de engenharia.

Suciu Dan12 min read
Ler artigo

Comece a construir

Pronto para expandir a sua recolha de dados?

Junte-se a mais de 2.000 empresas que utilizam a WebScrapingAPI para extrair dados da Web à escala empresarial, sem quaisquer custos de infraestrutura.