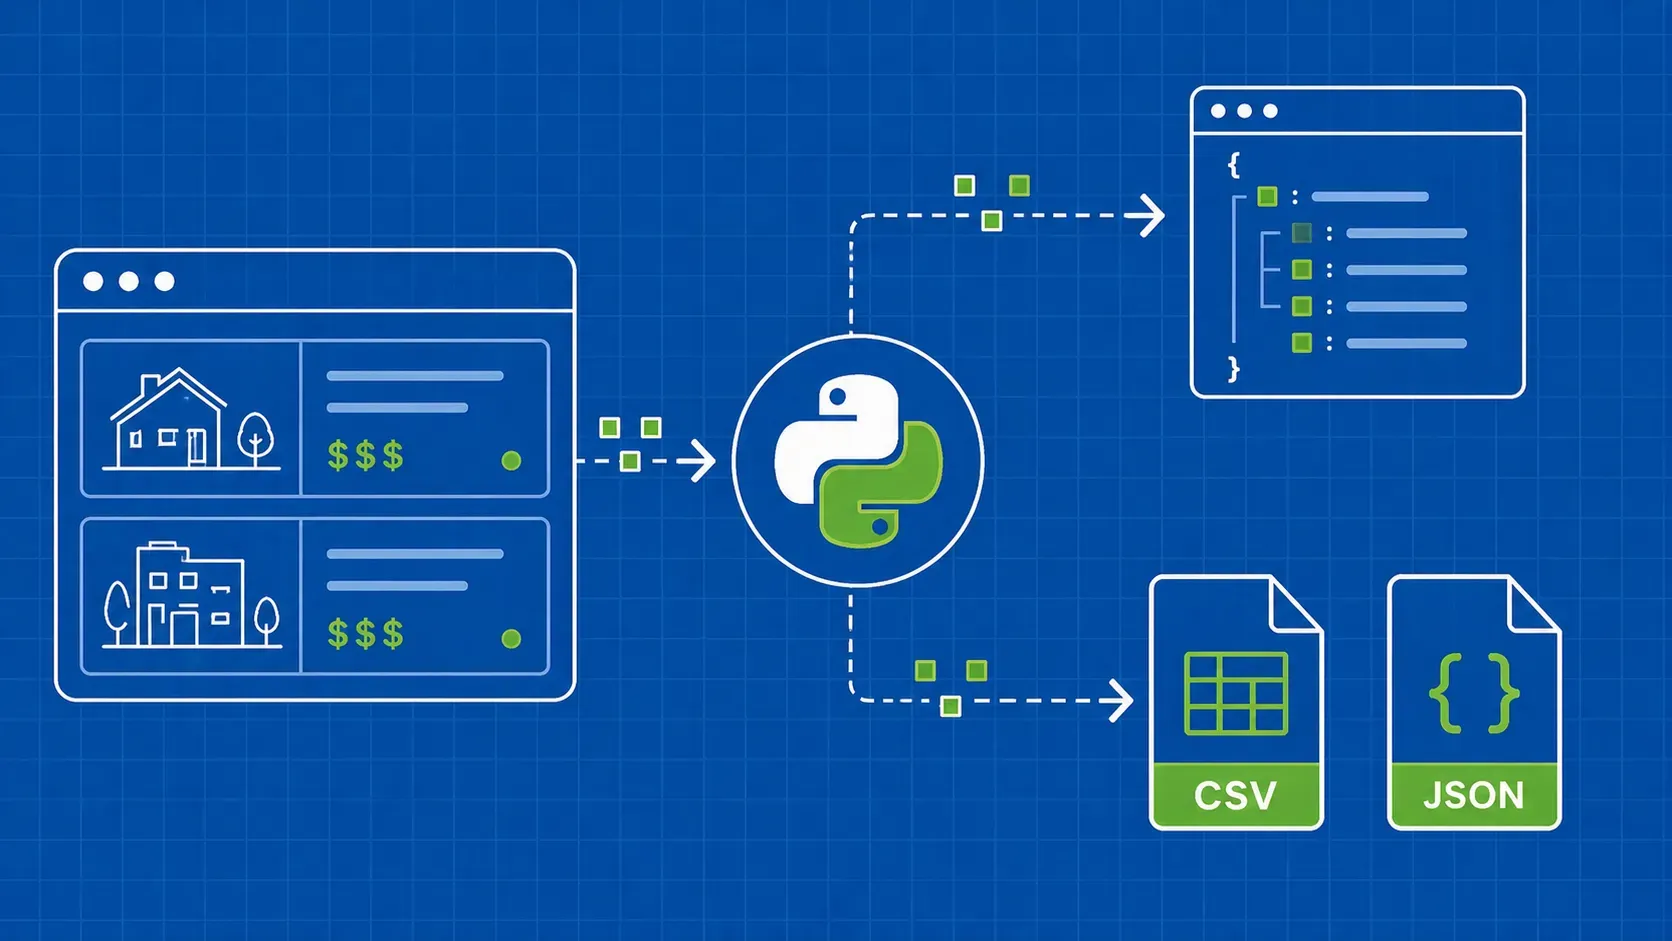
Resumo: O Ruby faz a extração de dados da Web utilizando o Faraday para HTTP, o Nokogiri para a análise de CSS e XPath e um pequeno conjunto de threads para garantir a concorrência. Este guia mostra como criar um scraper que rastreia um catálogo de exercícios com 1 000 livros, convertendo-o para CSV e JSON, faz novas tentativas de forma educada, lida com uma página em JavaScript com o Ferrum e chama uma API de scraping a partir do mesmo código.
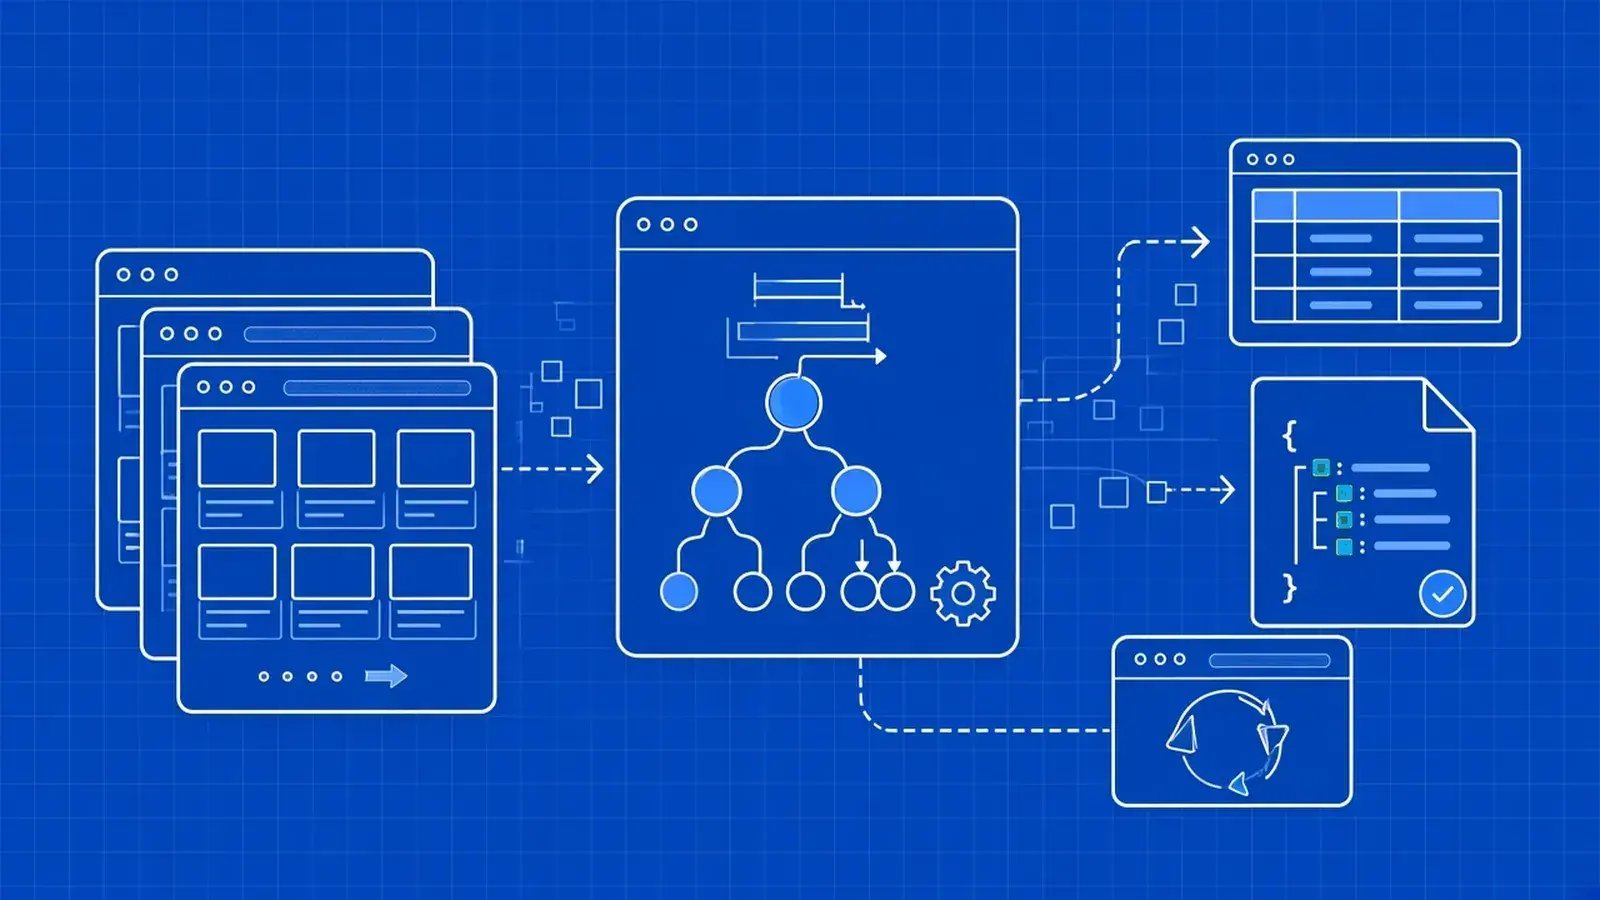
A extração de dados da Web com Ruby requer três componentes: o Faraday obtém a página, o Nokogiri analisa o HTML com seletores CSS ou XPath e um conjunto fixo de threads obtém várias páginas de uma só vez sem sobrecarregar o site. Irá criar um scraper do início ao fim. Este recolhe todos os livros de books.toscrape.com, um catálogo de treino público, segue a paginação, processa páginas em simultâneo, repete as solicitações com limitação de taxa da forma correta e grava os resultados em CSV e JSON. Em seguida, irá lidar com uma página renderizada em JavaScript (quotes.toscrape.com/js/) de três formas diferentes, iniciar sessão num formulário de prática com o Mechanize e chamar uma API de scraping a partir do mesmo código do Faraday.
O código destina-se ao Ruby 3.4 ou mais recente e às versões das gems indicadas na tabela abaixo.