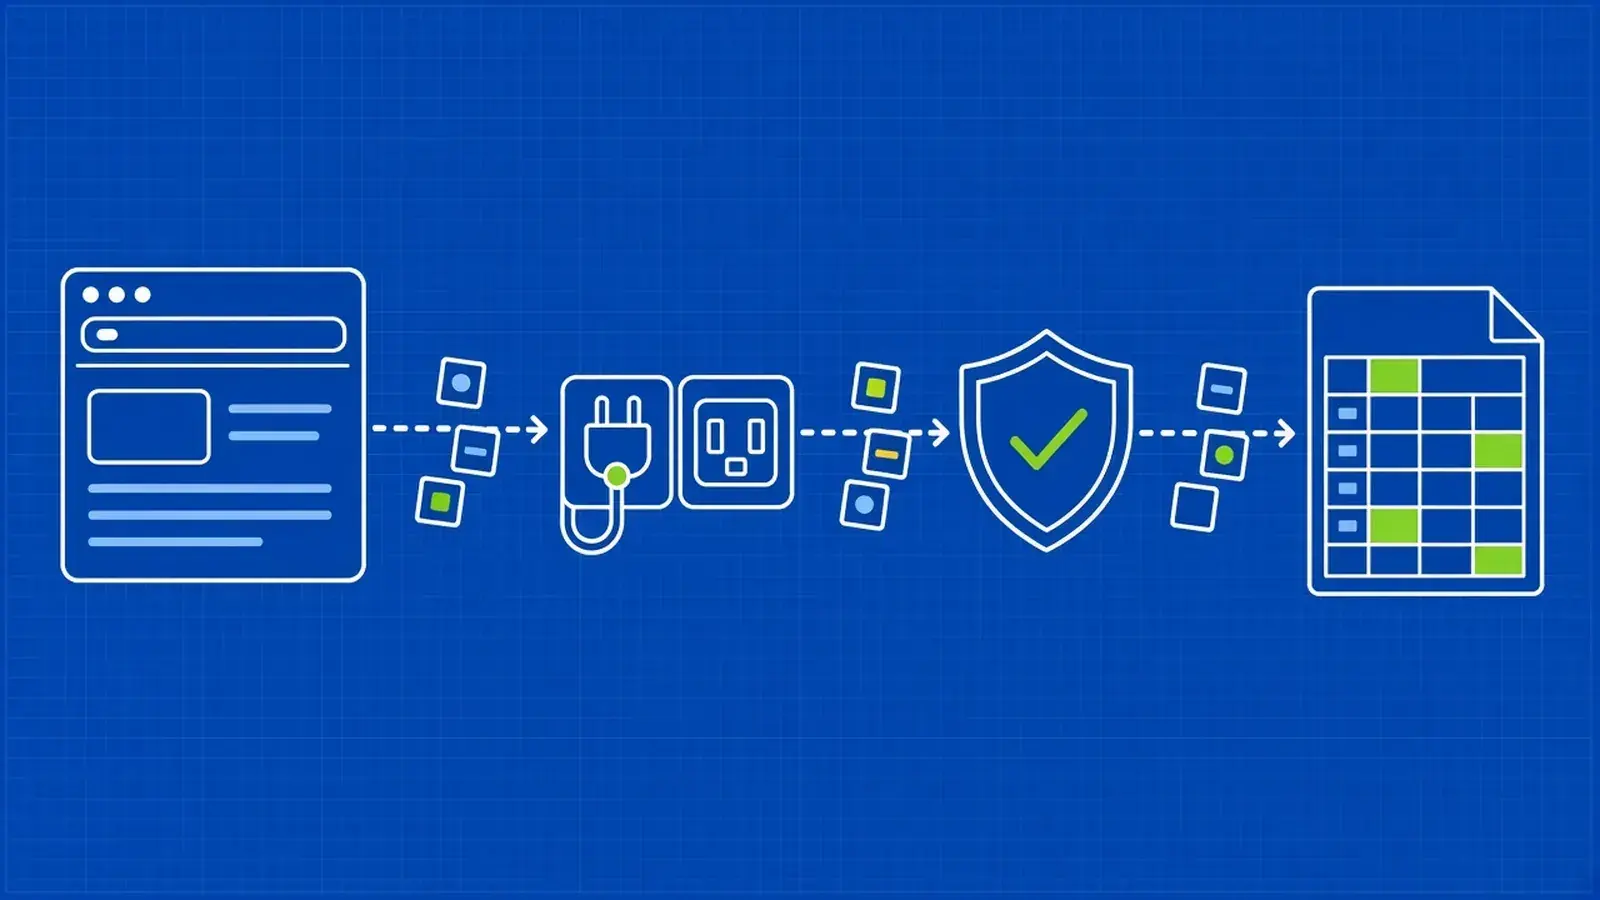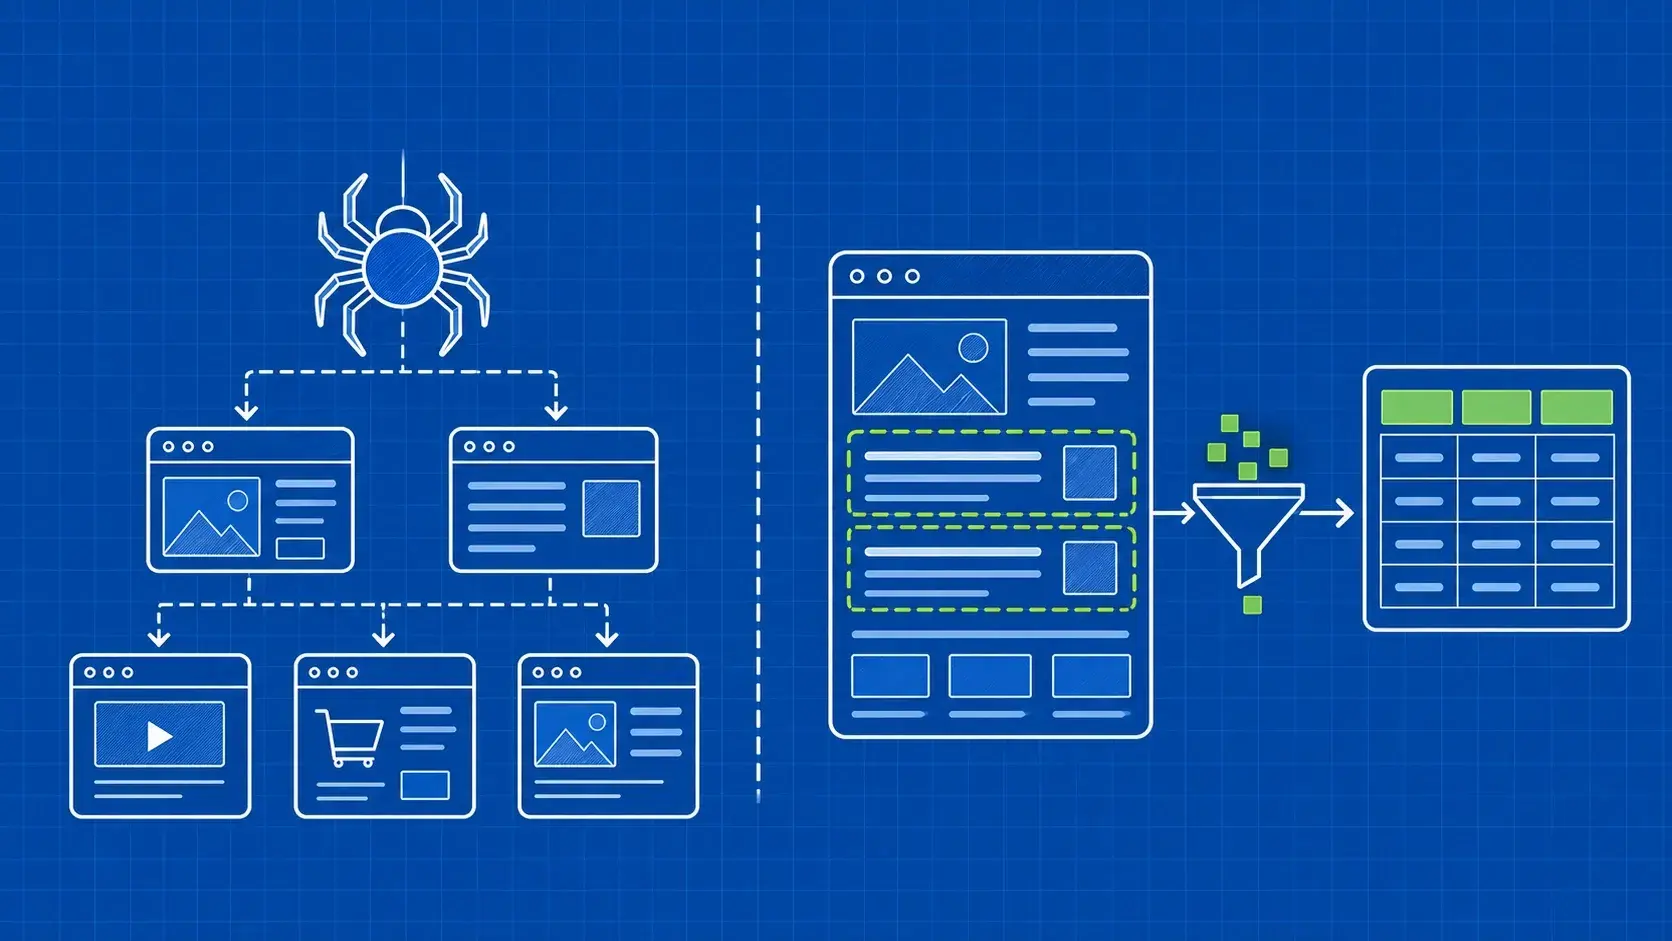
Resumo: O rastreamento da Web descobre e visita páginas relevantes; a extração de dados da Web extrai informações úteis do seu conteúdo. Se já tiver os URLs, pode começar pela extração. Se precisar de encontrar páginas e recolher os seus dados, combine ambas as tarefas e verifique os resultados separadamente.
A diferença entre o «web scraping» e o «web crawling» reside na distinção entre extrair informação de páginas web e descobrir quais as páginas a visitar. Utiliza-se o «scraping» para recolher valores como títulos e preços de livros; utiliza-se o «crawling» para encontrar as páginas que os contêm.
Imagine que precisa de uma folha de cálculo com livros de programação vendidos por uma loja online. A página da categoria dá-lhe um ponto de partida, mas pode conter ligações para várias páginas de resultados. Encontrar os endereços dos livros é uma tarefa. Ler o autor e o preço corretos em cada página de livro é outra.
Conhecer a diferença ajuda-o a evitar dois resultados frustrantes: uma longa lista de links sem dados úteis, ou dados precisos de algumas páginas enquanto o resto do catálogo passa despercebido. Também o ajuda a compreender o que uma ferramenta faz realmente quando se descreve como um «scraper», «crawler», «spider» ou serviço de extração de dados.
Este guia compara os resultados, explica o funcionamento e acompanha uma livraria fictícia desde a descoberta até aos registos validados. Terá assim uma forma prática de escolher um fluxo de trabalho e testá-lo num pequeno lote antes de o expandir.