Saltar para o conteúdo
Comece grátis
Voltar ao blogue

Extrair dados de APIs: um primeiro pipeline fiável

Gabriel CiociÚltima atualização em 13 min read
Extrair dados de APIs: um primeiro pipeline fiável
TL;DR: A extração de API é um fluxo de trabalho que vai desde pedidos documentados até registos validados. Comece com um contrato de saída reduzido, teste a paginação e os casos de falha localmente e, em seguida, adicione um cliente real, pontos de verificação duradouros e um relatório explícito indicando se a recolha foi concluída.

Uma solicitação devolve uma lista de produtos, o seu script analisa o JSON e o terminal apresenta uma linha. Essa é uma primeira verificação útil, mas extrair dados de APIs significa mais do que receber uma resposta. Um extrator fiável deve decidir quais os registos que são válidos, como prosseguir e o que relatar quando apenas parte da recolha pretendida chega.

Este guia desenvolve essas decisões com base num catálogo de produtos fictício. O exercício utiliza um fixture local em Python em vez de um serviço de rede, para que possa testar a continuação, o tratamento de duplicados e os registos rejeitados sem credenciais nem tráfego externo. Assim que essas regras estiverem a funcionar, um cliente HTTP real pode fornecer páginas através da mesma interface.

O foco está na implementação, e não na terminologia. Se os métodos, cabeçalhos e estados de resposta ainda lhe forem desconhecidos, o guia de APIs para principiantes explica esses conceitos básicos. Aqui, o resultado é um pequeno projeto de extração com condições de sucesso e falha observáveis. Poderá determinar o que foi aceite, o que foi rejeitado e se a condição final documentada pela fonte foi atingida.
Planeie a extração de dados de APIs com base num contrato de saída

Defina a linha que pretende entregar antes de criar um ciclo. Para o catálogo fictício, cada linha aceite necessita de um ID de produto estável, um nome não vazio, um preço inteiro não negativo em cêntimos e a moeda EUR. Estas são regras específicas do exercício, não pressupostos a aplicar a todos os fornecedores.

Separe o contrato de origem do esquema de destino. A fonte pode representar dinheiro como texto decimal, um número inteiro ou um valor de exibição formatado. Preserve esse significado explicitamente ao mapear para o destino. Um campo denominado price não indica, por si só, a sua unidade, tratamento fiscal ou moeda.

Decisão

Exemplo de regra

O que não se deve fazer

Identidade

Preservar o ID do produto de origem

Tratar a posição na matriz como uma chave do produto

Texto obrigatório

O nome deve conter texto que não seja espaço em branco

Publicar um campo em branco como um registo completo

Significado numérico

Centavos inteiros ao abrigo deste contrato de instalação

Determinar a unidade a partir do valor

Política de duplicados

Manter a primeira ocorrência para este exercício

Combinar silenciosamente observações contraditórias

Conclusão

Parar no cursor nulo documentado

Considerar concluída uma paragem do orçamento de páginas

Proveniência

Manter o âmbito do pedido e a hora da recolha

Perda do contexto que selecionou estes registos

A política de deduplicação merece uma escolha explícita. O exercício mantém a primeira ocorrência válida porque a sua configuração repete um produto idêntico. Um catálogo em constante mudança pode, em vez disso, exigir uma comparação de carimbos de data/hora ou um registo de conflito. A deduplicação deve implementar a política escolhida, não ocultar divergências entre observações.

Ao extrair dados de APIs, distinga um registo rejeitado de uma página com falha. Um item inválido pode ser colocado em quarentena, enquanto outros itens permanecem utilizáveis de acordo com a sua política. Um envelope de página não reconhecido pode impedir que confie tanto nos itens como no valor de continuação; por isso, continuar às cegas representaria um risco diferente.

Por fim, defina o âmbito da recolha. Registe a conta, os filtros, o período e a versão do ponto final, quando relevante. Um registo preciso fora desse âmbito continua a ser o resultado errado para a tarefa.

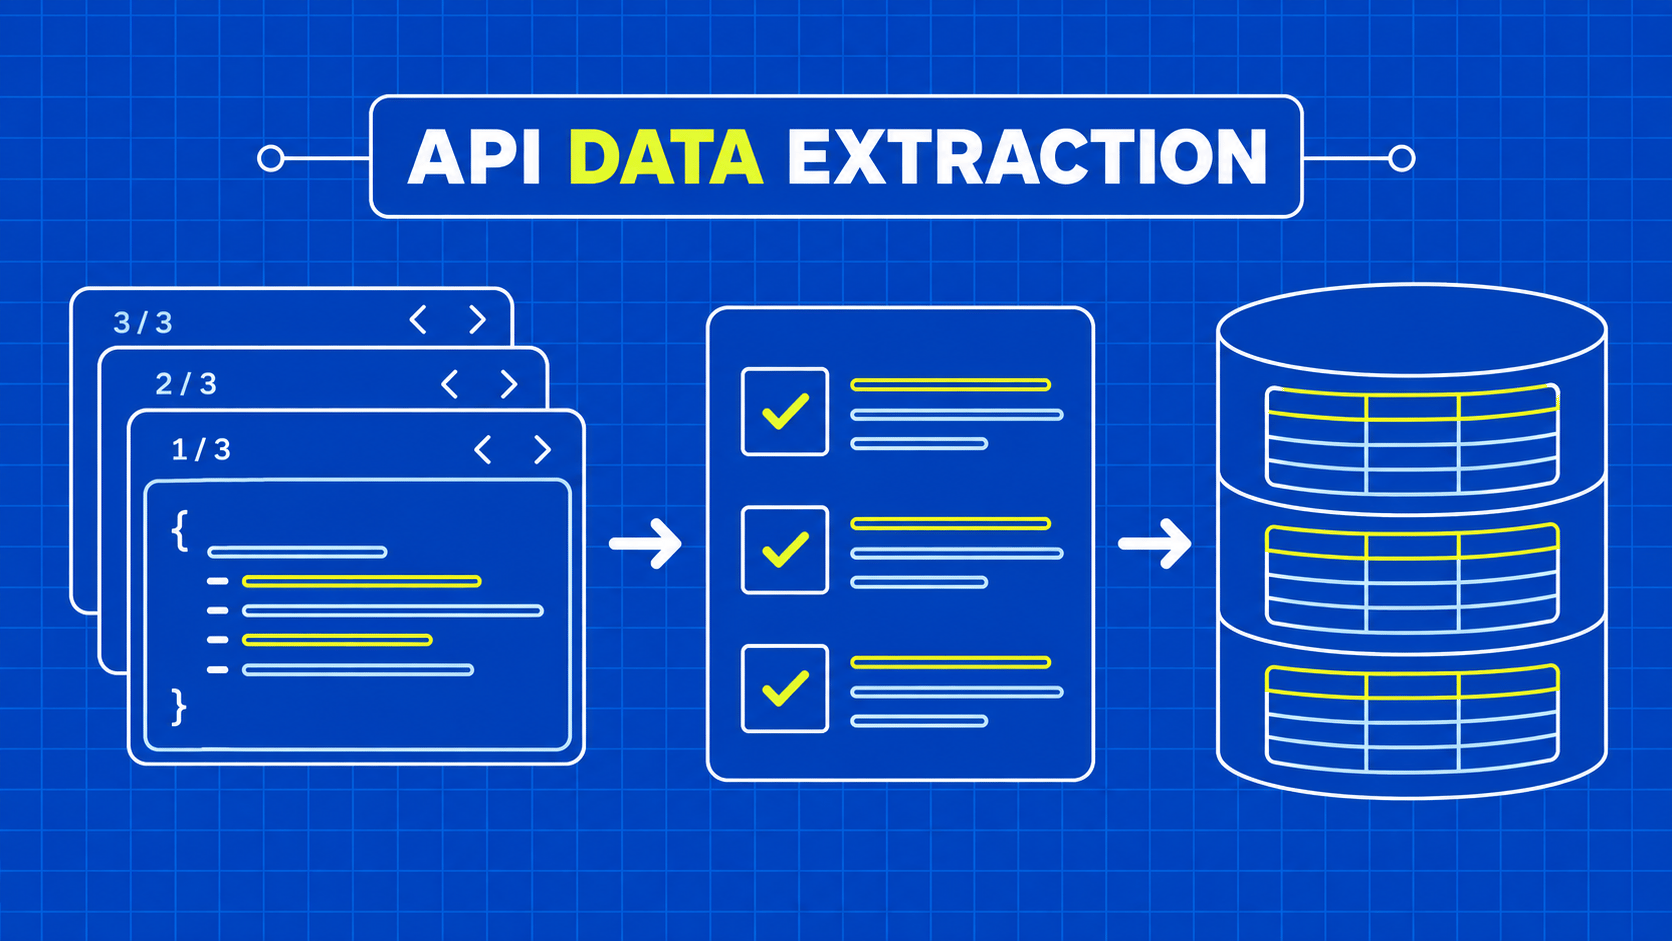
Separe a recuperação, a descodificação e a aceitação do registo

Utilize três limites na implementação. A recuperação obtém uma resposta do fornecedor. A descodificação interpreta a representação. A aceitação valida e mapeia os registos empresariais. Cada limite deve devolver um resultado útil ou uma falha classificada, em vez de substituir silenciosamente um problema por uma recolha vazia.

A camada de recuperação lida com o pedido documentado, as credenciais, os tempos de espera de transporte e o estado da resposta HTTP. Deve expor evidências suficientemente sanitizadas para diagnosticar uma falha. Não torne o validador de registos responsável por adivinhar se uma página de erro HTML foi causada por um tempo de espera ou por um requisito de início de sessão.

A camada de descodificação verifica o formato e o envelope esperados. A análise de JSON determina se o texto segue a sintaxe JSON; não prova que o resultado seja uma página de produto. A especificação JSON define valores e estrutura, deixando o significado dos campos a cargo do contrato da aplicação.

Para este exercício, uma página tem uma items lista e um next valor que pode ser nulo ou uma cadeia de caracteres não vazia. Um envelope inesperado constitui uma falha da página. Cada item é então verificado de forma independente em relação às regras do produto antes de chegar à saída aceite.

Estes limites tornam a extração de dados das APIs mais fácil de testar. Um fixture local pode substituir a recuperação, enquanto a lógica de descodificação e aceitação em produção continua a ser exercida. É possível reproduzir uma linha malformada ou um cursor repetido sem depender de um fornecedor para gerar essa condição a pedido.

Ao adicionar um cliente real, mantenha as suas responsabilidades restritas. A comparação de clientes HTTP em Python é útil para avaliar os controlos de pedidos, mas nenhuma biblioteca de cliente pode inferir a sua definição de um produto válido. Mantenha essa definição numa função separada e passível de revisão.

Evite também capturar todas as exceções e devolver []. Esse padrão torna a infraestrutura indisponível indistinguível de um catálogo vazio válido. Um chamador deve ser capaz de distinguir se o fornecedor não devolveu registos correspondentes ou se o extrator não conseguiu estabelecer um resultado válido.

Execute um exercício local de paginação e validação

Guarde o seguinte como extract_fixture.py e execute-o com Python 3. Utiliza apenas a biblioteca padrão e não faz pedidos de rede. As páginas falsas incluem dois produtos válidos, um preço inválido e uma duplicata idêntica. As asserções finais também verificam se um cursor de continuação repetido falha de forma visível.

from copy import deepcopy

PAGES = {
    None: {"items": [
        {"id": "p1", "name": "Lamp", "price_minor": 2400,
         "currency": "EUR"},
        {"id": "bad", "name": "Chair", "price_minor": True,
         "currency": "EUR"},
    ], "next": "page-b"},
    "page-b": {"items": [
        {"id": "p1", "name": "Lamp", "price_minor": 2400,
         "currency": "EUR"},
        {"id": "p2", "name": "Book", "price_minor": 650,
         "currency": "EUR"},
    ], "next": None},
}

def valid_record(row):
    return (
        isinstance(row, dict)
        and isinstance(row.get("id"), str) and bool(row["id"].strip())
        and isinstance(row.get("name"), str) and bool(row["name"].strip())
        and type(row.get("price_minor")) is int
        and row["price_minor"] >= 0
        and row.get("currency") == "EUR"
    )

def collect(fetch_page, max_pages=5):
    cursor, visited, accepted = None, set(), {}
    rejected = duplicates = 0
    for _ in range(max_pages):
        if cursor in visited:
            raise ValueError("pagination cursor repeated")
        visited = visited | {cursor}
        page = fetch_page(cursor)
        if not isinstance(page, dict) or not isinstance(page.get("items"), list):
            raise ValueError("invalid page envelope")
        if "next" not in page or not (
            page["next"] is None
            or isinstance(page["next"], str) and bool(page["next"])
        ):
            raise ValueError("invalid continuation")
        for row in page["items"]:
            if not valid_record(row):
                rejected += 1
            elif row["id"] in accepted:
                duplicates += 1
            else:
                accepted = {**accepted, row["id"]: dict(row)}
        cursor = page["next"]
        if cursor is None:
            return list(accepted.values()), rejected, duplicates
    raise ValueError("page budget exhausted before completion")

rows, rejected, duplicates = collect(lambda cursor: deepcopy(PAGES[cursor]))
assert [row["id"] for row in rows] == ["p1", "p2"]
assert (rejected, duplicates) == (1, 1)
assert not valid_record({"id": "x", "name": "X",
                         "price_minor": True, "currency": "EUR"})
try:
    collect(lambda cursor: {"items": [], "next": "same"})
except ValueError as error:
    assert str(error) == "pagination cursor repeated"
else:
    raise AssertionError("repeated cursor was accepted")
print("2 accepted, 1 rejected, 1 duplicate; cycle check passed")

O transporte falso devolve uma cópia, pelo que a extração não altera o fixture. O coletor valida o envelope antes de processar as linhas, rastreia os cursores separadamente das identidades dos produtos e aceita apenas registos que cumpram as regras declaradas. Uma página repetida e um produto repetido são observações diferentes.

Repare na verificação do tipo numérico. Em Python, os booleanos são uma subclasse dos inteiros, pelo que uma verificação ampla de instâncias inteiras aceitaria True como preço. Este fixture exclui-o deliberadamente com uma comparação de tipos exata. Outras linguagens e ferramentas de esquema requerem atenção equivalente à coerção e aos tipos aceites.

O limite de páginas é um limite de proteção, não uma garantia de exaustividade. Se expirar antes de aparecer a continuação nula, o exercício gera um erro. Nunca devolve um resultado normal de conclusão apenas porque o ciclo atingiu o seu máximo configurado.

Trata-se de um extrator de ensino, não de um sistema de armazenamento de produção. Acumula registos aceites na memória e gera um erro em caso de falha de página, em vez de reter de forma duradoura o progresso parcial. Antes de extrair dados de APIs em grande escala, substitua essas limitações por um «sink» e um registo de execução que preservem o trabalho já aceite.

Os próximos testes locais devem refletir o seu contrato: uma chave de continuação em falta, um campo que não seja de lista items e duplicados em conflito. Mantenha os resultados esperados explícitos. O objetivo é testar as decisões que a fonte real pode impor, não adicionar um grande conjunto de testes que se limite a repetir a implementação.

Torne explícita a conclusão da paginação e os pontos de verificação

O exercício utiliza valores de cursor, mas os fornecedores publicam contratos de paginação diferentes. Alguns devolvem ligações, outros utilizam deslocamentos e outros ainda exigem números de página ou tokens de continuação. A documentação de paginação do GitHub ilustra a continuação baseada em ligações para esse serviço; trata-se de um exemplo, não de um formato universal de API.

Preserve os valores de continuação opacos exatamente como o fornecedor indica. Mantenha os filtros relevantes e o contexto da conta associados ao item de trabalho. Um token gerado para o âmbito de um pedido não deve ser tratado como uma instrução independente que se aplica a qualquer consulta subsequente.

Valide a continuação baseada em URL antes de a seguir. Um link seguinte fornecido pela resposta deve permanecer dentro dos destinos que a sua integração está autorizada a contactar, e os redirecionamentos necessitam das mesmas verificações de limites. Não encaminhe uma credencial para um anfitrião não relacionado simplesmente porque uma resposta incluiu essa URL.

Ao extrair dados de APIs para um armazenamento duradouro, confirme os dados aceites antes de avançar o ponto de verificação. Se o ponto de verificação avançar primeiro e o armazenamento falhar, um reinício pode ignorar registos. Se os dados forem armazenados primeiro e a atualização do ponto de verificação falhar, a próxima tentativa pode reproduzir uma página, o que pode ser gerido por uma política de duplicação deliberada.

Uma transação atómica pode ajudar quando o destino e o ponto de verificação partilham um sistema de armazenamento. Caso contrário, documente como funcionam a repetição e a reconciliação. Evite alegar um processamento «exatamente uma vez» simplesmente porque o percurso normal armazena uma linha por identificador de origem.

Registe o motivo do término. Uma página final fornecida pela fonte, um limite de páginas, um prazo e uma resposta rejeitada são resultados distintos. Um relatório que contenha apenas a contagem de dados aceites não consegue explicar se a tarefa abrangeu o âmbito pretendido.

Teste também os pressupostos do fornecedor sobre a alteração de dados. Uma lista baseada em deslocamento pode deslocar-se enquanto a percorre, e um cursor pode expirar antes de um reinício posterior. Registe a janela de recolha e utilize um instantâneo documentado ou um mecanismo incremental quando a tarefa exigir uma consistência mais forte do que a oferecida por uma percorrida em tempo real.

Lide com as novas tentativas sem ocultar lacunas ou duplicados

Uma nova tentativa é mais uma tentativa de realizar uma operação, não uma correção das suas entradas. Repetir um pedido com credenciais inválidas ou parâmetros malformados geralmente repete o problema. Comece por classificar a falha e identificar o que, se for o caso, poderia mudar antes de uma nova tentativa.

Para HTTP, a semântica dos métodos na RFC 9110 ajuda a distinguir a recuperação segura de operações cuja repetição pode ter efeitos comerciais. Mesmo para leituras, mantenha as tentativas limitadas e respeite o comportamento documentado do fornecedor. Não ative uma funcionalidade geral de nova tentativa sem verificar quais os erros e operações que esta repete.

Os limites de taxa exigem atenção à carga agregada. Uma 429 resposta sinaliza uma condição de limitação; o âmbito de contagem é definido pelo serviço, e a resposta pode incluir orientações sobre o atraso. A RFC 6585 define o estado. Vários trabalhadores que partilham credenciais podem consumir a mesma cota.

Escolha um responsável pelas tentativas. Se o cliente, o intermediário e o executor de tarefas repetirem as tentativas de forma invisível, uma única solicitação pretendida pode gerar mais tráfego do que o registado pelo coletor. Torne as contagens de tentativas e o tempo decorrido da tarefa suficientemente visíveis para investigar essa multiplicação.

Ao extrair dados de APIs, mantenha um estado separado para a recolha parcial. Se três páginas foram aceites e a quarta falhou, preserve os dados aceites de acordo com a política e registe o âmbito em falta. Não crie um marcador de página final nem entregue um conjunto de dados «completo» sem qualificação.

Proteja o próprio relatório de falha. Armazene identificadores de pedidos sanitizados, categorias de resposta e erros de esquema. Evite descarregar credenciais, registos completos de contas ou corpos de mensagens sem restrições num registo geral simplesmente porque algo correu mal.

Por fim, separe a recuperação repetida da entrega repetida. Se a exportação a jusante falhar após a recolha ter sido bem-sucedida, repetir a exportação a partir dos registos armazenados preserva a observação original. Obter a fonte novamente cria uma execução diferente, cujos valores e integridade podem diferir.

Entregue registos com proveniência e verificações de alterações

Uma linha aceite deve conter contexto suficiente para explicar de onde provém. Dependendo da tarefa, isso inclui a identidade da fonte, a hora da recolha, o âmbito da solicitação, a versão do ponto de extremidade e a versão da transformação. Mantenha a hora de modificação da fonte separada da hora em que o seu coletor observou o registo.

Valide o limite de entrega, bem como a resposta da fonte. Um número inteiro correto pode transformar-se em texto numa exportação, um valor nulo pode tornar-se uma célula vazia, ou um consumidor pode interpretar um carimbo de data/hora num fuso horário diferente. Defina o esquema de saída e verifique um ficheiro ou mensagem representativo antes de publicar uma execução completa.

Para extrair dados de APIs de forma programada, adicione um monitor de pequenas alterações. Compare as contagens de rejeição, a presença de campos obrigatórios e o comportamento de conclusão com as expectativas para essa fonte. Uma queda repentina nos registos aceites merece investigação, mas não é automaticamente um erro de extração; os filtros ou o inventário da fonte podem ter mudado legitimamente.

Mantenha um conjunto de testes aprovado para manutenção. Quando um fornecedor alterar um campo opcional, um teste deve indicar se o seu mapeamento o ignora de forma segura ou se necessita de uma atualização. Quando um campo obrigatório mudar de significado, reveja o contrato em vez de adicionar uma alternativa genérica que produza resultados plausíveis.

O guia de scraping automatizado na Web relaciona estes limites de aceitação e entrega com o ciclo de vida mais amplo da tarefa. A mesma disciplina operacional aplica-se quer a entrada provenha de uma API documentada, quer de uma página Web analisada.

Conclua a primeira implementação com um relatório de execução que outra pessoa possa utilizar: contagens de itens aceites, rejeitados, duplicados e de páginas com falha; o motivo da rejeição; e a localização do resultado validado. Esse relatório transforma um script funcional num processo de recolha cujas limitações permanecem visíveis.

Pontos-chave

  • Defina o significado dos campos, a identidade, a política de duplicados e a conclusão antes de extrair dados de APIs num ciclo.
  • Mantenha a recuperação, a descodificação e a validação empresarial separadas, para que as falhas de transporte não se transformem em resultados de sucesso vazios.
  • Teste localmente cursores repetidos, linhas inválidas e limites de páginas antes de ligar o extrator a um fornecedor ativo.
  • Armazene os dados aceites antes de avançar para um ponto de verificação e torne o comportamento de reinício compatível com a reprodução deliberada.
  • Preserve as evidências da execução parcial e valide o formato de entrega final com o mesmo cuidado que a resposta de origem.

Perguntas frequentes

A recolha e a transformação devem utilizar o mesmo horário?

Não necessariamente. A recolha de uma observação de origem e a transformação de dados armazenados são tarefas diferentes. Separá-las permite-lhe corrigir um mapeamento sem ter de efetuar outro pedido à fonte. Decida durante quanto tempo as observações brutas devem ser retidas e de que versões de transformação os consumidores necessitam; em seguida, agende cada etapa de acordo com esses requisitos.

Como deve um coletor de API lidar com um novo campo opcional?

Siga a política de compatibilidade que escolheu para a fonte. Um coletor que ignore campos opcionais desconhecidos pode continuar inalterado, enquanto um que preserve um documento bruto completo pode retê-los para revisão posterior. Não exponha automaticamente todos os novos campos aos consumidores a jusante sem verificar o seu significado e as implicações de acesso.

Uma exportação CSV pode preservar todos os valores da API?

Não sem um mapeamento explícito. O CSV não retém, por si só, objetos aninhados, matrizes ou distinções como «nulo» versus «texto vazio». Simplifique ou codifique esses valores deliberadamente, documente a convenção e teste a interpretação do consumidor. Mantenha uma representação mais rica da fonte, caso o processamento posterior venha a necessitar de informações que a tabela omita.

Conclusão

Comece a extrair dados de APIs com um contrato reduzido e um ciclo que tenha em conta possíveis falhas. O exercício local demonstra as decisões-chave: aceite apenas registos definidos, trate produtos duplicados separadamente de cursores repetidos e exija uma condição de término real. Um cliente HTTP real acrescenta preocupações de transporte sem substituir essas regras.

Antes de agendar a tarefa, atribua aos dados aceites um destino duradouro, torne o ponto de verificação seguro para reprodução e produza um relatório que distinga execuções completas das parciais. Esses controlos permitem-lhe aumentar o âmbito sem tornar os dados em falta mais difíceis de reconhecer.

Se alguns campos obrigatórios estiverem disponíveis apenas através de páginas web, avalie a API Scraper da WebScrapingAPI como uma fonte de dados adicional. Mantenha o mesmo contrato de aceitação, proveniência e entrega em relação a esses dados, para que o pipeline se mantenha consistente mesmo quando os métodos de recolha diferirem.

Sobre o autor

Gabriel Cioci, Desenvolvedor Full-Stack @ WebScrapingAPI

Gabriel Cioci

Desenvolvedor Full-Stack

Gabriel Cioci é um programador Full Stack na WebScrapingAPI, responsável pela criação e manutenção dos sites, do painel do utilizador e das principais funcionalidades da plataforma destinadas aos utilizadores.

Comece a construir

Pronto para expandir a sua recolha de dados?

Junte-se a mais de 2.000 empresas que utilizam a WebScrapingAPI para extrair dados da Web à escala empresarial, sem quaisquer custos de infraestrutura.