
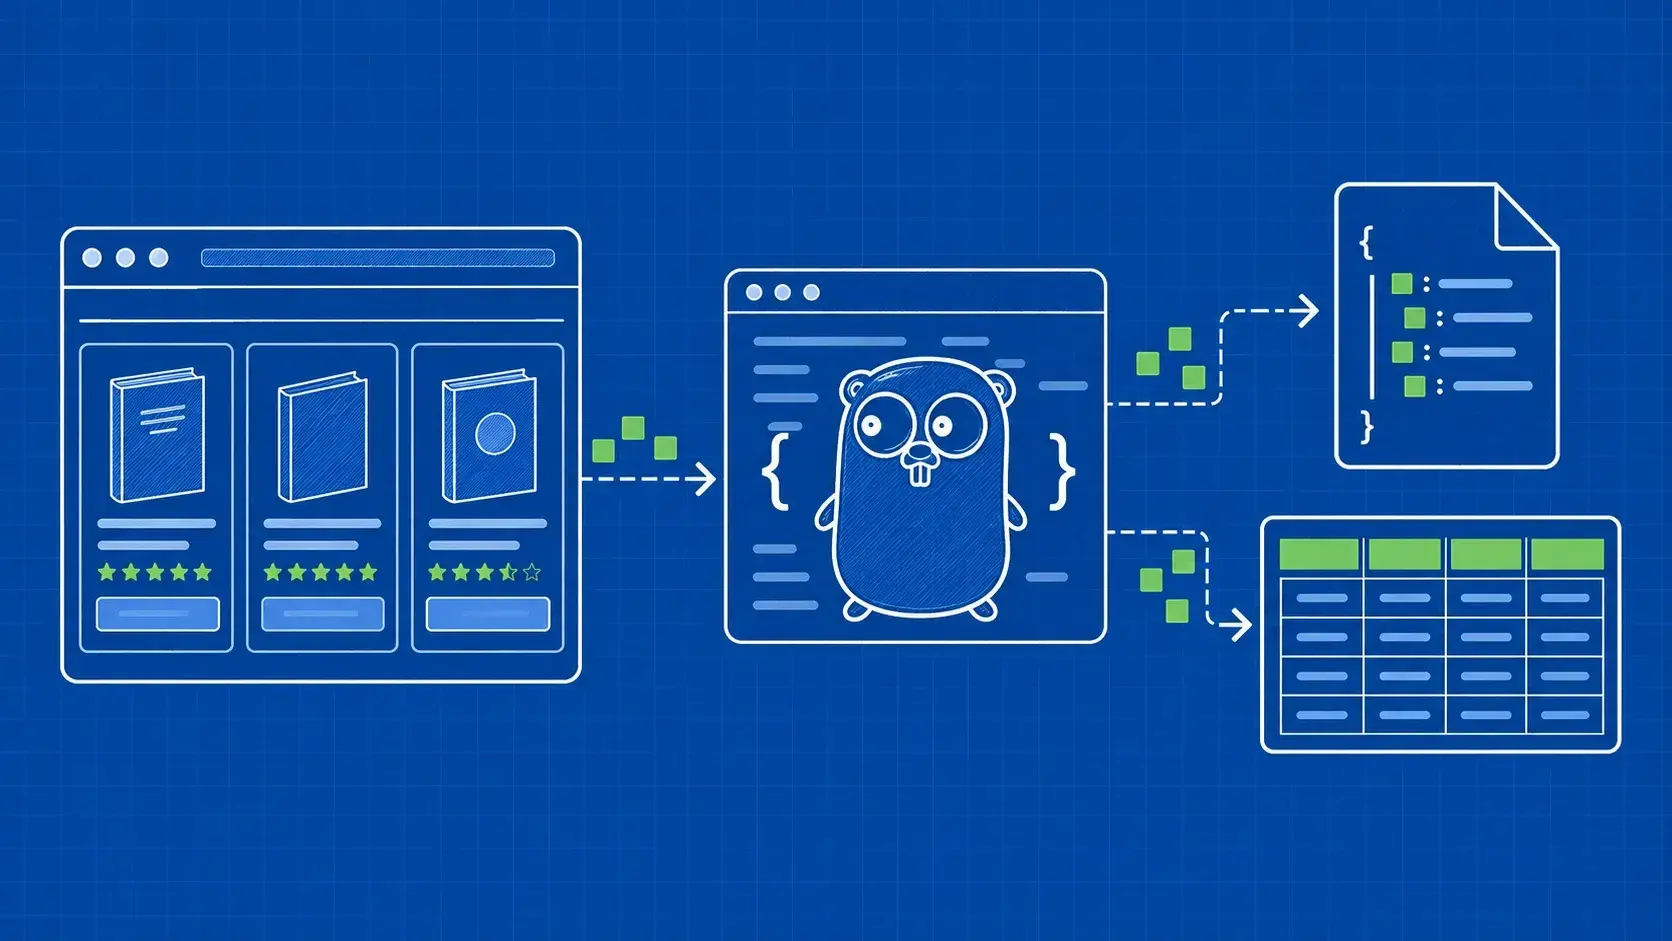
Resumo: Para fazer web scraping com Go, usa net/http para obter HTML estático e o `goquery` para extrair campos com seletores CSS. Comece com uma página, valide cada registo e exporte em JSON. Adicione o Colly para agendar o rastreamento ou um navegador para JavaScript apenas quando o seu alvo assim o exigir. O exemplo completo abaixo inclui tempos limite, limites de resposta, verificações de estado e erros de análise explícitos.Um scraper que imprime um título uma única vez é fácil de demonstrar. Um scraper que o avisa quando uma página muda, um pedido falha ou um campo desaparece é muito mais útil numa aplicação em Go. A diferença reside nos limites que estabelece em torno da obtenção, análise e exportação de dados.
Este guia apresenta o web scraping com Go utilizando uma livraria de exemplo. Irá criar um módulo, obter uma página do catálogo, extrair registos de livros e escrever um ficheiro JSON. O programa está completo, pelo que pode executá-lo antes de adaptar os seletores a outra fonte. Já deve estar familiarizado com funções, estruturas, retornos de erro e o trabalho básico na linha de comandos do Go.
A mesma abordagem aplica-se a muitos projetos de web scraping em Golang: definir primeiro os campos de saída, inspecionar o HTML de origem e tornar os dados em falta observáveis. Em seguida, abordaremos a paginação, o Colly, a renderização do navegador e os testes, para que possas ampliar a primeira versão sem perder o controlo do seu comportamento.
Mantenha o critério de sucesso inicial concreto: uma página solicitada produz um conjunto válido de registos de livros ou um erro que explique por que razão não foi possível. Isso dá-lhe algo útil para avaliar antes de adicionar mais páginas ou trabalhadores.


