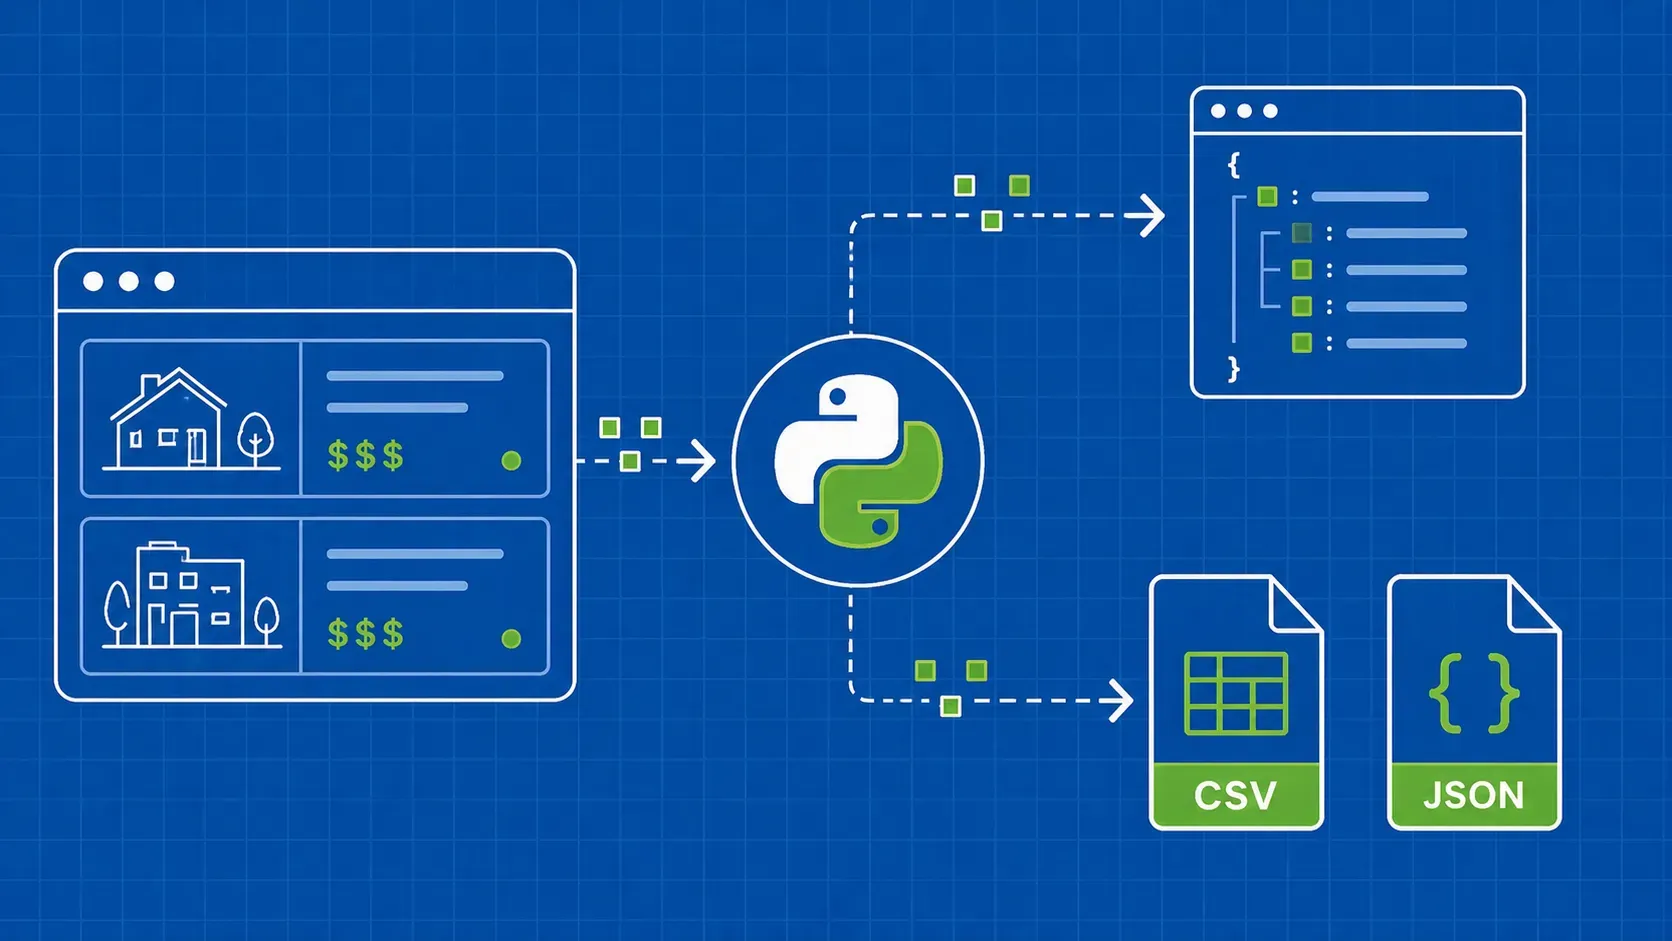

Resumo: este guia mostra como baixar arquivos com Python, de uma única linha de código até pipelines autenticados, retomáveis, paralelos e assíncronos. Você vai aprender quando usarurllib,requests,ThreadPoolExecutorouaiohttp, como fazer streaming de conteúdos grandes, adicionar uma barra de progressotqdmde verdade, repetir com backoff e verificar a integridade com checksums eContent-Length.
Se você já automatizou um backup, fez scraping de um conjunto de dados ou montou um pipeline de dados, sabe que baixar arquivos com Python é uma daquelas tarefas que parecem triviais até chegar à produção. Uma chamada urlretrieve de duas linhas funciona bem para um CSV de 100 KB no seu notebook. Ela desmorona no momento em que você precisa baixar um arquivo compactado de 5 GB por uma VPN instável, retomar uma transferência pela metade ou puxar mil imagens de produtos protegidas por login.
Este artigo é o guia que eu queria ter tido quando escrevi meu primeiro script de download que precisava rodar por uma semana. Vamos começar com o trecho de código mais simples possível e, depois, acrescentar streaming, barras de progresso, transferências retomáveis, threads, E/S assíncrona, autenticação, verificações de integridade e novas tentativas. Cada seção traz um exemplo executável que você pode colar em um virtualenv com Python 3.9 ou mais recente.
No fim, você deve conseguir olhar para uma URL, prever onde ela pode falhar, escolher a ferramenta certa e copiar um trecho de código que lide com essas falhas.