Saltar para o conteúdo
Comece grátis

Blog · Artigos

Guias

Tutoriais passo a passo, melhores práticas e guias práticos sobre web scraping, gestão de proxies e extração de dados.

Artigos publicados

104

Artigos

Guias

104 artigos

Web Scraping com AWS Lambda: Guia para Python e Java 2026
Guias

Web Scraping com AWS Lambda: Guia para Python e Java 2026

TL;DR: Resumo: A extração de dados da Web com o AWS Lambda funciona melhor quando cada invocação é curta, delimitada e pode ser repetida de forma independente. Comece com HTTP direto, AWS SAM e S3 e, só depois, adicione SQS, contentores, renderização no navegador, proxies ou uma camada de recuperação gerida, apenas quando a carga de trabalho demonstrar que precisa deles.

Suciu Dan32 min read
Ler artigo

Como utilizar o GoSpider: rastrear, limpar URLs e extrair dados
Guias

Como utilizar o GoSpider: rastrear, limpar URLs e extrair dados

TL;DR: Resumo: O GoSpider é um rastreador de linha de comandos destinado a descobrir URLs, não um extrator completo de dados estruturados. Este guia sobre como utilizar o GoSpider mostra como realizar um rastreio limitado, gerir resultados de forma organizada, fazer a transferência de dados do Colly para CSV e seguir um percurso de diagnóstico para respostas 403 ou páginas que exijam renderização em JavaScript.

Suciu Dan23 min read
Ler artigo
Como fazer o Scrape Redfin: Guia Python para Dados de Propriedade
Guias

Como fazer o Scrape Redfin: Guia Python para Dados de Propriedade

TL;DR: A Redfin expõe pontos de extremidade de API ocultos que retornam JSON estruturado para listagens de propriedades, tornando possível ignorar totalmente a análise HTML frágil. Este guia orienta-o na construção de um scraper Python que extrai dados de aluguer e venda, pesquisa por localização, monitoriza novas listagens através de sitemaps XML e exporta resultados limpos para CSV ou JSON.

Suciu Dan14 min read
Ler artigo
Como analisar JSON em Python: desde respostas de API até JSON oculto em páginas web
Guias

Como analisar JSON em Python: desde respostas de API até JSON oculto em páginas web

TL;DR: Analise JSON em Python com json.loads e json.load, corrija erros de descodificação, valide dados aninhados, processe ficheiros de grande dimensão e extraia JSON-LD ou __NEXT_DATA__ ocultos em páginas web — além dos envelopes da WebScrapingAPI.

Suciu Dan13 min read
Ler artigo
As 10 melhores ferramentas de web scraping com IA para 2026
Guias

As 10 melhores ferramentas de web scraping com IA para 2026

TL;DR: Não existe um único scraper de IA que seja ideal para todas as tarefas. Compare 10 ferramentas com base no método de extração, tipo de utilizador, operações e custo e, em seguida, recorra a um plano de teste prático para escolher a opção mais adequada.

Suciu Dan24 min read
Ler artigo
XPath Web Scraping: Um guia prático com exemplos em Python
Guias

XPath Web Scraping: Um guia prático com exemplos em Python

TL;DR: XPath é uma linguagem de consulta para navegar em árvores HTML/XML por caminho, atributo ou conteúdo de texto. Este guia aborda a sintaxe, os eixos e as funções XPath e, em seguida, mostra scrapers Python funcionais com lxml e Selenium. Você também terá uma folha de dicas consolidada e uma seção de solução de problemas para os erros mais comuns do XPath.

Suciu Dan11 min read
Ler artigo
Tutorial do Scrapy Playwright: Extrair sites com muito JavaScript em escala
Guias

Tutorial do Scrapy Playwright: Extrair sites com muito JavaScript em escala

TL;DR: O Scrapy-Playwright permite renderizar páginas pesadas em JavaScript diretamente dentro de spiders Scrapy, controlando navegadores reais Chromium, Firefox ou WebKit através do Playwright. Este tutorial guia-o através da instalação, configuração, interações de páginas, interceção AJAX, anti-deteção, e uma estrutura de projeto pronta a produzir para que possa fazer scraping de sites dinâmicos sem sair do ecossistema Scrapy.

Raluca Penciuc20 min read
Ler artigo
Extrair dados do Expedia com Python: hotéis e preços
Guias

Extrair dados do Expedia com Python: hotéis e preços

TL;DR: Extraia os anúncios de hotéis da Expedia com Python, utilizando renderização em JS, proxies, seletores CSS e paginação; em seguida, limpe e exporte os dados para CSV.

Mihai Maxim13 min read
Ler artigo
Guia da API de extração de resultados de pesquisa (SERP): Google, Bing, DuckDuckGo, Yandex
Guias

Guia da API de extração de resultados de pesquisa (SERP): Google, Bing, DuckDuckGo, Yandex

TL;DR: Envie o seu primeiro pedido à API SERP da WebScrapingAPI com a chave definida numa variável de ambiente; em seguida, filtre os resultados do Google por país, idioma e dispositivo; leia os ficheiros JSON do Google e do Bing de forma defensiva; extraia você mesmo o HTML do DuckDuckGo e do Yandex; execute tarefas assíncronas do Google; repita a tentativa de acordo com os códigos de erro documentados e defina um plano com base nos preços do Google a partir de outubro de 2026.

Suciu Dan25 min read
Ler artigo
Como utilizar a API do Amazon Scraper: Guia de início rápido
Guias

Como utilizar a API do Amazon Scraper: Guia de início rápido

TL;DR: Comece a utilizar a API Amazon Scraper da WebScrapingAPI: envie o seu primeiro pedido, escolha entre nove tipos de pedidos (produto, pesquisa, mais vendidos, promoções, avaliações de vendedores e muito mais), selecione 20 mercados da Amazon, analise todas as respostas JSON, lide com erros e novas tentativas e escolha um plano.

Robert Sfichi24 min read
Ler artigo
Scrapy vs Beautiful Soup: Que raspador Python escolher
Guias

Scrapy vs Beautiful Soup: Que raspador Python escolher

TL;DR: Scrapy é uma estrutura de rastreamento completa que lida com solicitações, análise e exportação de dados em um único pacote. Beautiful Soup é uma biblioteca de análise leve que pode ser emparelhada com um cliente HTTP, como os pedidos. Escolha o Scrapy quando precisar de rastreamento simultâneo em grande escala com pipelines integrados. Escolha Beautiful Soup quando quiser uma configuração rápida e mínima para analisar um punhado de páginas.

Mihnea-Octavian Manolache12 min read
Ler artigo
Tutorial do Scrapy Splash: Renderizar páginas JavaScript
Guias

Tutorial do Scrapy Splash: Renderizar páginas JavaScript

TL;DR: O Scrapy Splash emparelha o mecanismo de rastreamento rápido do Scrapy com o navegador sem cabeça Splash para renderizar páginas pesadas em JavaScript. Este tutorial do Scrapy Splash guia você através da configuração do Docker, configuração do projeto Scrapy, noções básicas do SplashRequest, scripts Lua para rolagem e clique, integração de proxy e correção dos erros mais comuns que você encontrará.

Ștefan Răcilă13 min read
Ler artigo
Extrair dados de produtos da Amazon com Python: Guia Prático
Guias

Extrair dados de produtos da Amazon com Python: Guia Prático

TL;DR: As páginas de produtos da Amazon estão repletas de dados valiosos (preços, classificações, avaliações, ASINs), mas extraí-los de forma confiável requer mais do que uma solicitação HTTP básica. Este guia o orienta na construção de um scraper Python com Requests e BeautifulSoup, lidando com paginação e defesas anti-bot, exportando para CSV ou JSON e alimentando os resultados em fluxos de trabalho LLM. Você também aprenderá quando usar uma API de raspagem em vez de desenvolver sua própria solução.

Raluca Penciuc18 min read
Ler artigo
Melhores ferramentas de raspagem de trabalho em 2026: comparação e guia
Guias

Melhores ferramentas de raspagem de trabalho em 2026: comparação e guia

TL;DR: As ferramentas de recolha de dados de emprego vão desde serviços API leves e automatização de browser de código aberto a extractores alimentados por IA e plataformas visuais sem código. Este guia compara as melhores ferramentas de raspagem de empregos no Google Jobs, Indeed, Monster, Upwork e mercados freelance e, em seguida, orienta você na construção de um pipeline confiável com desduplicação, agendamento e tratamento anti-bot para que você possa começar a coletar dados de trabalho limpos em escala.

Gabriel Cioci18 min read
Ler artigo
Contornar o Cloudflare com Selenium: 5 métodos Python (2026)
Guias

Contornar o Cloudflare com Selenium: 5 métodos Python (2026)

TL;DR: O Cloudflare bloqueia o Selenium baunilha ao identificar o navegador, inspecionar cabeçalhos e analisar sinais comportamentais. Este guia percorre cinco métodos práticos de bypass (Undetected ChromeDriver, Selenium Stealth, SeleniumBase UC mode, integração do solucionador CAPTCHA e APIs de raspagem), completo com código Python, uma tabela de comparação e um runbook de solução de problemas para que você possa escolher a abordagem certa para sua escala e orçamento.

Mihnea-Octavian Manolache20 min read
Ler artigo
7 melhores APIs SERP em 2026: comparação de preços e recursos
Guias

7 melhores APIs SERP em 2026: comparação de preços e recursos

TL;DR: Não existe uma API SERP oficial do Google, pelo que os fornecedores terceiros preenchem a lacuna. Os preços variam entre cerca de $0,30 e $15 por mil pesquisas, e a escolha certa depende do seu volume, orçamento e das funcionalidades SERP que precisa de extrair. Este guia compara os principais provedores lado a lado, divide o custo real em escala e fornece uma estrutura de decisão para selecionar a melhor API SERP para o seu projeto.

Andrei Ogiolan21 min read
Ler artigo
Como configurar o proxy Axios no Node.js: Autenticação, rotação, SOCKS5
Guias

Como configurar o proxy Axios no Node.js: Autenticação, rotação, SOCKS5

TL;DR: O Axios encaminha pedidos através de um proxy, aceitando um objeto proxy com anfitrião, porta e campos de autenticação opcionais. Este guia aborda como definir a configuração de proxy do Axios a partir do zero: cabeamento básico, proxies autenticados, tunelamento HTTPS, um sistema de rotação usando interceptores, SOCKS5 via socks-proxy-agent e diagnóstico de erros comuns. Cada snippet é um código Node.js que pode ser copiado e colado.

Suciu Dan11 min read
Ler artigo
Arquivo para download do Puppeteer: 4 métodos para Node.js
Guias

Arquivo para download do Puppeteer: 4 métodos para Node.js

TL;DR: Um fluxo de trabalho de arquivo de download do Puppeteer tem quatro boas formas: clique em um botão e deixe o Chrome escrever em uma pasta que você controla, execute fetch() dentro da página e canalize base64 de volta para o Node, conduza o Chrome DevTools Protocol com eventos de progresso de download, ou pule o navegador e puxe a URL com Axios usando cookies colhidos da sessão do Puppeteer. Escolha pelo tamanho do arquivo, autenticação e como o site expõe o link.

Mihnea-Octavian Manolache39 min read
Ler artigo
Como usar um proxy no Node-Fetch: Um Guia Prático
Guias

Como usar um proxy no Node-Fetch: Um Guia Prático

TL;DR: O Node-Fetch não tem um switch de proxy embutido, então você conecta um agente HTTP, HTTPS ou SOCKS5 na requisição através de sua opção de agente. Este guia mostra como usar um proxy no Node-Fetch de ponta a ponta: proxies HTTP e HTTPS autenticados, SOCKS5, rotação, novas tentativas, casos extremos de TLS, solução de problemas e a rota moderna undici para o fetch nativo do Node 18+.

Mihnea-Octavian Manolache13 min read
Ler artigo
Web Scraping de Tabelas JavaScript em Python: De APIs ocultas a Playwright
Guias

Web Scraping de Tabelas JavaScript em Python: De APIs ocultas a Playwright

TL;DR: Web scraping de tabelas JavaScript em Python raramente precisa de um navegador sem cabeça. Abra o DevTools, encontre o endpoint JSON que hidrata a grade, reproduza-o com solicitações, pagine-o e volte para o Playwright apenas quando a chamada de rede for assinada, criptografada ou fechada de outra forma.

Andrei Ogiolan13 min read
Ler artigo
Extrair tabelas HTML em Golang com Colly
Guias

Extrair tabelas HTML em Golang com Colly

TL;DR: Este guia mostra como extrair tabelas HTML em Golang de ponta a ponta: escolha entre Colly, goquery e golang.org/x/net/html, direcione o <tbody> correto, modele as linhas como uma estrutura tipada e exporte JSON e CSV limpos. Você também obtém paginação, anti-bloqueio e padrões de tabela renderizados em JavaScript.

Andrei Ogiolan11 min read
Ler artigo
Playwright Web Scraping: O Guia Completo para Python e Node.js
Guias

Playwright Web Scraping: O Guia Completo para Python e Node.js

TL;DR: O Playwright oferece automação completa do navegador para raspagem de sites com muito JavaScript, com suporte de primeira classe para Python e Node.js. Este guia o orienta na instalação, extração de elementos, configuração de proxy, anti-deteção, paginação, downloads de imagens e exportação de dados para CSV ou JSON, tudo com exemplos de código lado a lado em ambas as linguagens.

Mihnea-Octavian Manolache16 min read
Ler artigo
Extrair comentários do Google Maps com Python
Guias

Extrair comentários do Google Maps com Python

TL;DR: Descobrir como fazer scraping de reviews do Google Maps se resume a três métodos: um scraper Selenium DIY por trás de um proxy rotativo, uma API de scraping com instruções de renderização ou uma API de Reviews do Maps estruturada que retorna JSON analisado. Este guia percorre os três métodos em Python com código que pode ser copiado e colado, padrões de paginação, tácticas anti-bloqueio e um passo final de limpeza que transforma os comentários em bruto em algo que uma empresa pode realmente usar.

Andrei Ogiolan17 min read
Ler artigo
Descarregue páginas da Web e ficheiros com facilidade usando Python e o wget
Guias

Descarregue páginas da Web e ficheiros com facilidade usando Python e o wget

TL;DR: Automatize a extração de dados da Web e o download de ficheiros com Python e o wget. Aprenda a utilizar estas ferramentas para recolher dados e poupar tempo.

Gabriel Cioci8 min read
Ler artigo
Como usar proxies com Python Requests: Do básico à produção
Guias

Como usar proxies com Python Requests: Do básico à produção

TL;DR: Este guia mostra como usar proxies com Python Requests de ponta a ponta: um ditado de proxies funcionando, URLs autenticadas, variáveis de ambiente, reutilização de sessão, SOCKS5 sem vazamentos de DNS, e um pool de rotação com novas tentativas e um circuit breaker. No final, você saberá quando uma API gerenciada ganha seu sustento sobre um pool DIY.

Ștefan Răcilă11 min read
Ler artigo
Extrair resultados de locais do Google Maps
Guias

Extrair resultados de locais do Google Maps

TL;DR: Aprenda a extrair resultados de locais do Google Maps com a nossa API utilizando Node.js: guia passo a passo, vantagens de um extrator profissional e muito mais. Obtenha facilmente o data_id, as coordenadas e o parâmetro de dados.

Andrei Ogiolan7 min read
Ler artigo
Web Scraping com Regex: Um guia prático
Guias

Web Scraping com Regex: Um guia prático

TL;DR: Web scraping com regex brilha quando você precisa de padrões de texto curtos e previsíveis (preços, SKUs, e-mails, datas) do HTML em que você já confia. Emparelhe o módulo re do Python com Beautiful Soup, escopo seus padrões para um nó analisado em vez de marcação bruta, e mantenha o regex fora do caminho da análise completa da árvore HTML. Este guia apresenta um raspador de título e preço em funcionamento, recursos avançados de regex e as armadilhas que afetam os raspadores reais em produção.

Mihai Maxim11 min read
Ler artigo
Da análise de sentimentos ao marketing: as inúmeras vantagens da extração de dados do Twitter
Guias

Da análise de sentimentos ao marketing: as inúmeras vantagens da extração de dados do Twitter

TL;DR: Tire o máximo partido dos dados do Twitter com técnicas especializadas de web scraping. Aprenda a extrair dados do Twitter para análise de sentimentos, marketing e inteligência empresarial. Guia completo com TypeScript.

Raluca Penciuc9 min read
Ler artigo
Como usar um proxy com HttpClient em C#
Guias

Como usar um proxy com HttpClient em C#

TL;DR: Para usar um proxy com HttpClient em C#, construa um WebProxy, anexe-o a um HttpClientHandler (ou SocketsHttpHandler), e passe esse handler para o construtor do HttpClient. Para produção, troque os loops manuais por IHttpClientFactory, adicione NetworkCredential para proxies autenticados e envolva as chamadas em tentativas com Polly para que IPs mortos não derrubem seu trabalhador.

Suciu Dan18 min read
Ler artigo
Como extrair tabelas HTML usando Python
Guias

Como extrair tabelas HTML usando Python

TL;DR: A maioria das tabelas HTML pode ser raspada com uma única linha de pandas.read_html. Quando a tabela é paginada, renderizada em JavaScript ou tem cabeçalhos mesclados, mude para Requests + BeautifulSoup ou um navegador sem cabeçalho como o Playwright. Este guia fornece uma matriz de decisão, código de trabalho para todas as três abordagens e as etapas de limpeza que transformam as linhas raspadas em dados prontos para o pipeline.

Andrei Ogiolan17 min read
Ler artigo
Cheerio vs Puppeteer: Como escolher a ferramenta certa
Guias

Cheerio vs Puppeteer: Como escolher a ferramenta certa

TL;DR: Cheerio é um analisador de HTML leve; Puppeteer conduz um navegador Chromium real. Use o Cheerio quando os dados já estiverem no HTML bruto, o Puppeteer quando o JavaScript os renderizar, e combine-os quando uma página com muito JS tiver muitos campos para extrair por visita.

Sergiu Inizian9 min read
Ler artigo
Como fazer scraping do Realtor.com: Um guia prático para 2026
Guias

Como fazer scraping do Realtor.com: Um guia prático para 2026

TL;DR: Se você está trabalhando em como fazer scrape do Realtor.com de forma limpa, três coisas importam mais: seletores estáveis que sobrevivem a seus nomes de classe com hash, uma camada de requisição que sobrevive à proteção anti-bot do Realtor, e código que percorre tanto as páginas de lista quanto as páginas de detalhes. Este guia é a compilação completa em Python, com táticas anti-bloqueio e exportações prontas para LLM.

Raluca Penciuc14 min read
Ler artigo
Web Scraping Booking.com: Hotéis, preços e avaliações (Guia 2026)
Guias

Web Scraping Booking.com: Hotéis, preços e avaliações (Guia 2026)

TL;DR: Este guia mostra como fazer o web scraping do Booking.com de ponta a ponta em Python: extraindo listagens de busca, páginas de hotéis, preços noturnos e avaliações de hóspedes. Você recebe dois métodos complementares: um fluxo de trabalho Selenium Wire para páginas renderizadas em JS e um caminho mais rápido que chama o endpoint interno /dml/graphql do Booking.com diretamente, além de um playbook anti-bloqueio, manipulação de moeda e uma solução alternativa para o limite de paginação de aproximadamente 1.000 resultados.

Raluca Penciuc15 min read
Ler artigo
Como extrair dados do Idealista: Um manual para 2026
Guias

Como extrair dados do Idealista: Um manual para 2026

TL;DR: O Idealista é o maior mercado imobiliário de Espanha, Itália e Portugal, mas tem uma proteção anti-bot séria que bloqueia rapidamente scrapers ingénuos. Este guia mostra como extrair dados do Idealista de ponta a ponta em Python: mapeamento do site, Selenium com undetected-chromedriver, gestão do DataDome, rotação de proxies e exportações limpas, além do reforço para produção que os concorrentes costumam ignorar.

Raluca Penciuc16 min read
Ler artigo
Como fazer o Scrape do Yelp com Python: Avaliações, listagens e pipelines de dados prontos para LLM
Guias

Como fazer o Scrape do Yelp com Python: Avaliações, listagens e pipelines de dados prontos para LLM

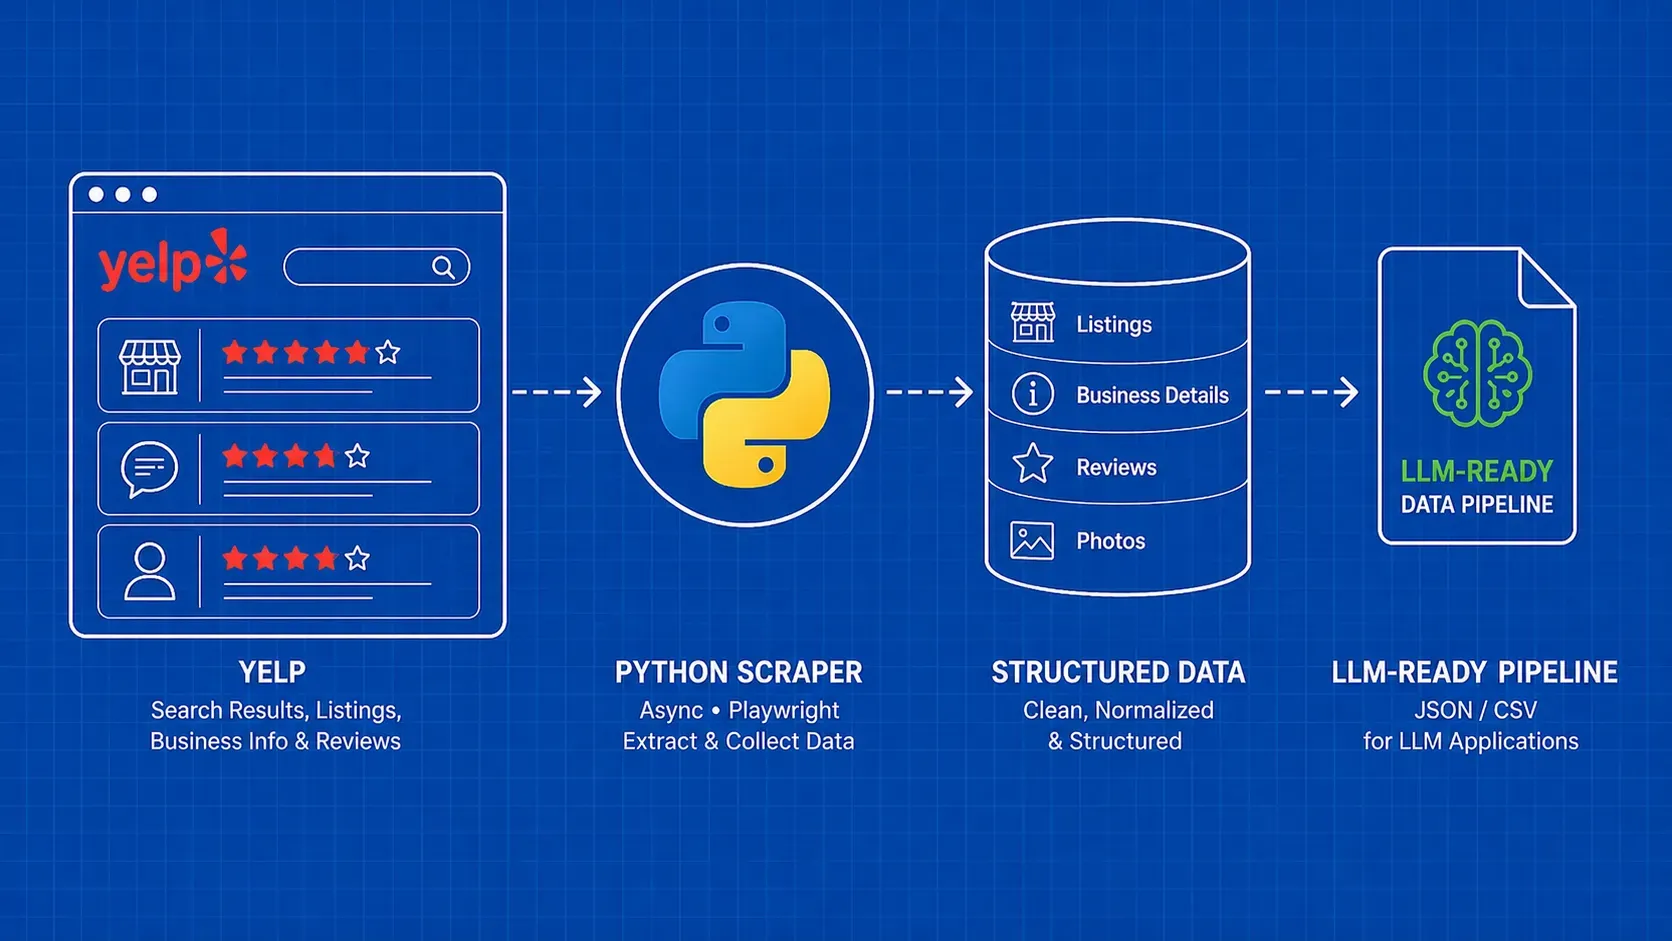
TL;DR: Este guia orienta-o na construção de um raspador Yelp completo em Python, cobrindo resultados de pesquisa, detalhes de negócios e avaliações com código de trabalho. Você também aprenderá como lidar com proteções anti-bot, exportar dados para CSV ou JSON e alimentar avaliações raspadas em um LLM para análise de sentimentos, algo que nenhum outro tutorial de raspagem do Yelp cobre.

Raluca Penciuc15 min read
Ler artigo
Como extrair dados da Web dos vendedores nas proximidades do Google Shopping com Node.js
Guias

Como extrair dados da Web dos vendedores nas proximidades do Google Shopping com Node.js

TL;DR: Saiba como utilizar o Node.js e a nossa API para extrair dados de vendedores nas proximidades a partir do Google Shopping. Extraia dados valiosos de forma rápida e fácil com o nosso scraper profissional.

Andrei Ogiolan6 min read
Ler artigo
Formulário de envio do Puppeteer: Guia do Node.js para 2026
Guias

Formulário de envio do Puppeteer: Guia do Node.js para 2026

TL;DR: Utilize page.locator(seletor).fill(value) para scripts de formulários de submissão rápidos e determinísticos do Puppeteer e page.type() quando a página procura por toques de teclas reais (autocomplete, anti-bot, validação em tempo real). Submeter clicando no botão, premindo Enter ou chamando form.requestSubmit(), e esperar sempre por um sinal de sucesso concreto em vez de um tempo limite fixo.

Mihnea-Octavian Manolache14 min read
Ler artigo
Como construir um Web Scraper com Pyppeteer (Guia 2026)
Guias

Como construir um Web Scraper com Pyppeteer (Guia 2026)

TL;DR: Pyppeteer é o port não-oficial do Puppeteer para Python e ainda funciona para conduzir um Chromium real a partir do asyncio. Neste guia você vai instalá-lo, escrever um web scraper moderno com Pyppeteer usando asyncio.run e try/finally, lidar com waits, formulários, screenshots, scroll infinito, cookies e proxies, e aprender quando migrar para Playwright, Selenium ou uma API de scraping hospedada.

Mihnea-Octavian Manolache12 min read
Ler artigo
Como fazer scraping do Walmart.com: Guia de ponta a ponta para 2026
Guias

Como fazer scraping do Walmart.com: Guia de ponta a ponta para 2026

TL;DR: Este guia mostra como raspar os dados de produtos do Walmart de ponta a ponta em Python, desde a análise do JSON __NEXT_DATA__ oculto até o dimensionamento com proxies, novas tentativas e buscas assíncronas. Ele também traça uma linha honesta para quando uma API de raspagem gerenciada supera a DIY.

Raluca Penciuc14 min read
Ler artigo
Aprenda a extrair informações sobre as especificações dos produtos do Google Shopping com o Node.js
Guias

Aprenda a extrair informações sobre as especificações dos produtos do Google Shopping com o Node.js

TL;DR: Descubra o guia passo a passo para extrair as especificações dos produtos do Google Shopping utilizando o Node.js. Melhore as suas competências em extração de dados da Web com este tutorial.

Andrei Ogiolan6 min read
Ler artigo
Contornar o Cloudflare em 2026: ferramentas e código
Guias

Contornar o Cloudflare em 2026: ferramentas e código

TL;DR: O Cloudflare bloqueia scrapers ao combinar impressões digitais TLS, desafios JavaScript, análise comportamental e CAPTCHAs Turnstile numa pontuação de confiança composta. Para o contornar de forma fiável, tem de passar todas as camadas em simultâneo. Este guia descreve as camadas de deteção, compara quatro ferramentas práticas (Nodriver, SeleniumBase UC, Camoufox, curl-impersonate) e aborda estratégias de proxy, persistência de sessões, resolução de erros e escalabilidade em produção.

Mihnea-Octavian Manolache16 min read
Ler artigo
Comece a usar o Web Stealth Proxy como um profissional: Guia de início rápido
Guias

Comece a usar o Web Stealth Proxy como um profissional: Guia de início rápido

TL;DR: Descubra como utilizar o Web Stealth Proxy como um profissional com o nosso guia de início rápido. Obtenha instruções passo a passo para otimizar a sua experiência com proxies e elevar a sua privacidade online a um novo nível. Comece hoje mesmo!

Mihai Maxim6 min read
Ler artigo
Como fazer scraping do YouTube com Python em 2026
Guias

Como fazer scraping do YouTube com Python em 2026

TL;DR: Este é um manual de 2026 sobre como raspar o YouTube com Python. Escolherá o método certo (Data API v3, yt-dlp, endpoints ocultos /youtubei/v1/ ou um scraper gerido) usando uma matriz de decisão, depois executará código para metadados de vídeo, comentários, canais, pesquisa, Shorts e transcrições, com uma secção de produção sobre proxies, cabeçalhos e 429 backoff para não ser bloqueado.

Raluca Penciuc20 min read
Ler artigo
Bibliotecas de navegador sem cabeça Python para raspagem da Web em 2026
Guias

Bibliotecas de navegador sem cabeça Python para raspagem da Web em 2026

TL;DR: Um navegador sem cabeça Python permite renderizar JavaScript, clicar em SPAs e raspar sites que clientes HTTP simples não conseguem alcançar. Selenium é o padrão mais seguro, Playwright é a escolha moderna para novos códigos, Pyppeteer e Splash ainda têm usos de nicho, e uma API de navegador hospedada é o que você procura quando as defesas anti-bot ou escala começam a incomodar.

Mihnea-Octavian Manolache21 min read
Ler artigo
Analisadores HTML e XML em Ruby: Uma comparação com base na carga de trabalho
Guias

Analisadores HTML e XML em Ruby: Uma comparação com base na carga de trabalho

TL;DR: Resumo: Escolha os analisadores HTML e XML em Ruby de acordo com a carga de trabalho, e não com base num ranking genérico. Comece com o Nokogiri para a análise geral de árvores HTML e XML, considere o Ox ou o LibXML Ruby para tarefas específicas de XML e recorra ao Selenium apenas quando for necessário que um navegador real exiba ou interaja com a página.

Raluca Penciuc14 min read
Ler artigo
Erros de estado do proxy: diagnosticar o ponto de falha da solicitação
Guias

Erros de estado do proxy: diagnosticar o ponto de falha da solicitação

TL;DR: Identifique o salto com falha antes de voltar a tentar um pedido de proxy. Utilize códigos de estado, resultados do comando CONNECT e registos de diagnóstico seguros para distinguir as falhas do proxy das respostas do destino.

Mihai Maxim16 min read
Ler artigo
Como extrair dados de uma tabela HTML em JavaScript e exportar um ficheiro CSV limpo
Guias

Como extrair dados de uma tabela HTML em JavaScript e exportar um ficheiro CSV limpo

TL;DR: Resumo: Primeiro, determine se as linhas da tabela existem na resposta HTTP, se são obtidas através de um pedido de dados ou se requerem que um navegador as apresente. Em seguida, utilize o script estático do Axios e do Cheerio ou a abordagem específica do Puppeteer apresentada abaixo para extrair dados de uma tabela HTML em JavaScript, validar registos com base nos cabeçalhos, eliminar páginas duplicadas e gravar ficheiros CSV de forma segura. Uma tabela HTML organiza a informação em linhas e colunas, normalmente com os elementos <table>, <tr>, <th> e <td>. Extrair uma tabela HTML em JavaScript significa recuperar ou renderizar essa marcação, converter cada linha de dados num objeto JavaScript, validar o resultado e serializá-lo para um formato como o CSV.

Mihai Maxim14 min read
Ler artigo
Análise de HTML em Java com Jsoup
Guias

Análise de HTML em Java com Jsoup

TL;DR: Jsoup é a biblioteca padrão para análise de HTML em Java. Este guia percorre todo o ciclo de vida (configuração do Maven, carregamento de um documento, seletores CSS, travessia do DOM, extração, modificação e serialização), além de um projeto de raspagem executável, tratamento de erros, paginação e os limites que o levam a um navegador sem cabeça ou a uma API de raspagem.

Mihai Maxim13 min read
Ler artigo
Python Extrair texto de HTML
Guias

Python Extrair texto de HTML

TL;DR: Para extrair texto de HTML em Python, analise a marcação com um analisador real (BeautifulSoup, lxml.html ou html-text), remova scripts, estilos e cromo do site e, em seguida, normalize o espaço em branco e o Unicode antes de salvar. Este guia compara as principais bibliotecas, corrige as armadilhas comuns de limpeza e termina com um rastreador executável que escreve JSONL e arquivos .txt por página.

Mihai Maxim25 min read
Ler artigo
Raspagem da Web com Scrapy: Manual 2026
Guias

Raspagem da Web com Scrapy: Manual 2026

TL;DR: Este é um guia opinativo, de ponta a ponta, para raspagem da web com Scrapy em 2026. Você instalará o Scrapy, criará protótipos de seletores no shell, construirá um spider de comércio eletrônico de várias páginas, limpará itens com Item Loaders, persistirá em um banco de dados, fortalecerá as configurações contra proibições e incluirá o Scrapy-Playwright para páginas renderizadas em JavaScript.

Mihai Maxim18 min read
Ler artigo
JavaScript com o Scrapy: os dados em primeiro lugar, renderização apenas quando necessário
Guias

JavaScript com o Scrapy: os dados em primeiro lugar, renderização apenas quando necessário

TL;DR: Resumo: A utilização do JavaScript com o Scrapy nem sempre requer um navegador. Em primeiro lugar, analise a resposta em bruto, os pedidos de rede e o estado da página incorporada; adicione o scrapy-playwright apenas quando os dados alvo dependerem efetivamente da execução no navegador e, em seguida, controle deliberadamente as esperas, as interações, a limpeza e a concorrência.

Mihai Maxim13 min read
Ler artigo
Axios Set Headers in 2026: O manual do programador
Guias

Axios Set Headers in 2026: O manual do programador

TL;DR: Axios define cabeçalhos em cinco camadas, configuração por requisição, padrões globais, instâncias axios.create(), interceptores de requisição e resposta, e a própria resposta. Este guia percorre cada camada com trechos executáveis da v1 e, em seguida, corrige os quatro bugs que afetam a todos: limites de várias partes, cookies CORS, certificados auto-assinados e revestimento de cabeçalho.

Mihnea-Octavian Manolache18 min read
Ler artigo
Web scraping com JavaScript e Node.js: Um guia prático
Guias

Web scraping com JavaScript e Node.js: Um guia prático

TL;DR: Extraia dados da Web com JavaScript e Node.js: recupere e analise páginas com o `fetch` nativo e o Cheerio, navegue por sites paginados de forma educada, aceda a pontos de extremidade JSON ocultos, renderize páginas com o Playwright ou o Puppeteer, teste o seu analisador offline e encaminhe páginas bloqueadas para uma API de extração sem ter de a reescrever.

Robert Sfichi26 min read
Ler artigo
Web scraping com Ruby: Faraday, Nokogiri, Selenium
Guias

Web scraping com Ruby: Faraday, Nokogiri, Selenium

TL;DR: A extração de dados da Web com Ruby consiste no processo de solicitar conteúdo da Web, localizar valores úteis em HTML ou num documento apresentado pelo navegador e converter esses valores em registos estruturados através de código Ruby. A abordagem mais fácil de manter consiste em utilizar a combinação de ferramentas mais leve que consiga aceder aos dados de forma fiável.

Raluca Penciuc19 min read
Ler artigo
Web scraping com PHP em 2026: bibliotecas e código
Guias

Web scraping com PHP em 2026: bibliotecas e código

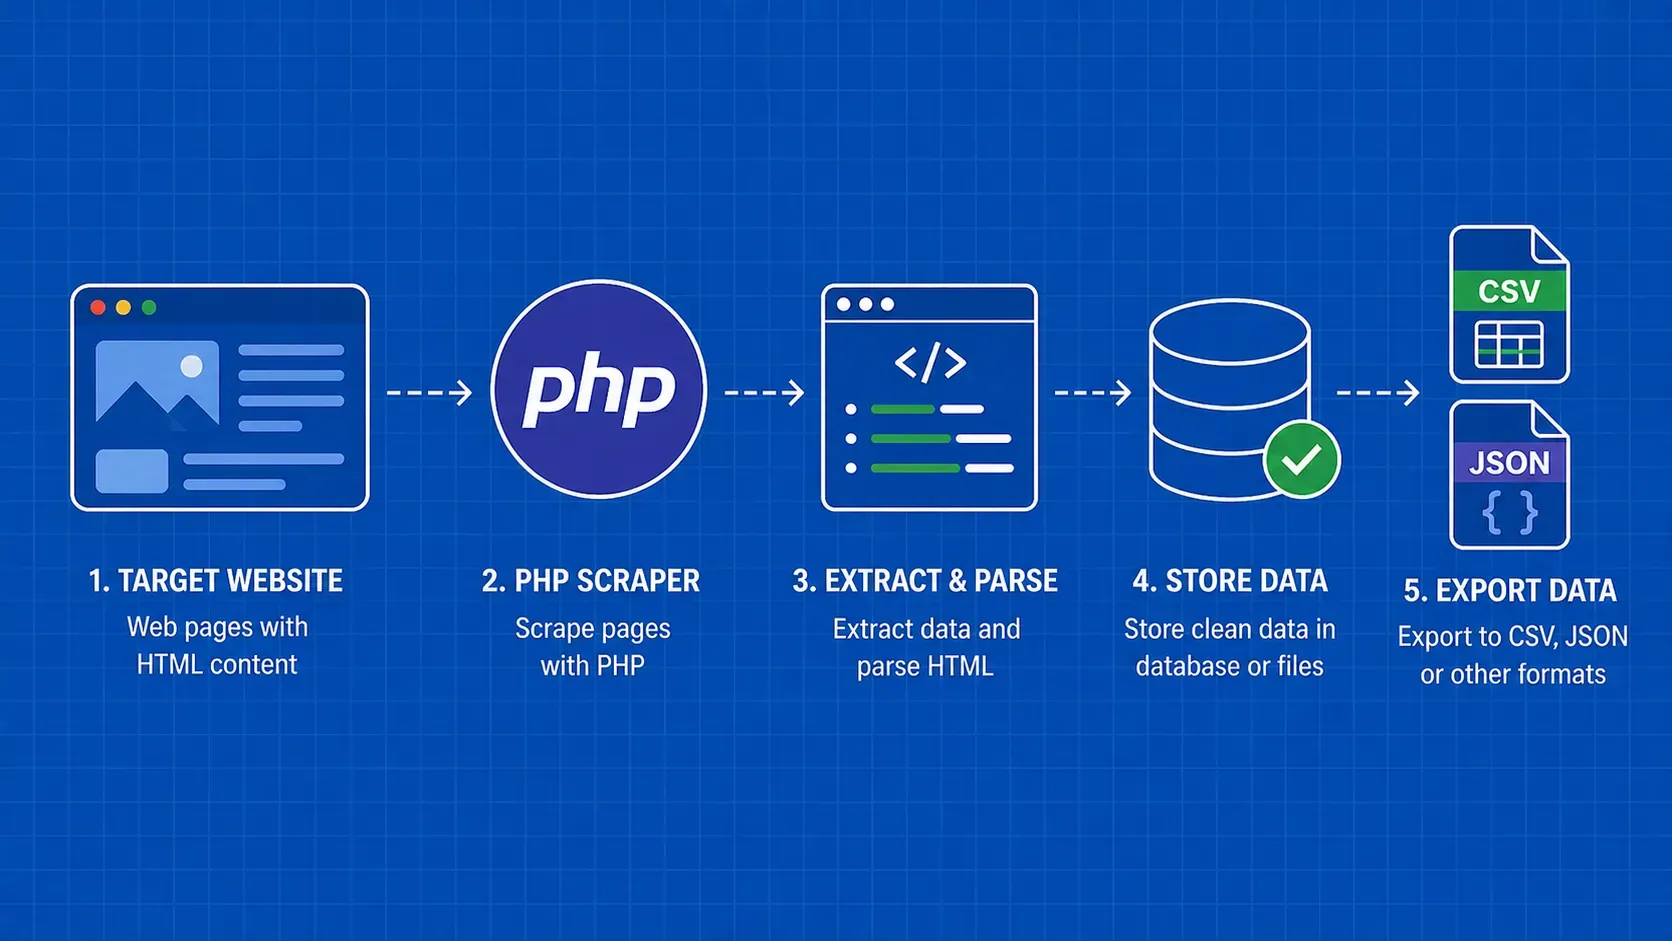
TL;DR: O PHP é uma linguagem perfeitamente capaz de fazer scraping da web, graças às extensões embutidas como cURL e DOMDocument, além de um rico ecossistema Composer que inclui Guzzle, Symfony DomCrawler e Symfony Panther para navegação sem cabeça. Este guia o orienta por todo o fluxo de trabalho: buscar páginas, analisar HTML, armazenar resultados em CSV/JSON/MySQL, tratar erros e evitar bloqueios.

Sorin-Gabriel Marica19 min read
Ler artigo
Cheerio Web Scraping em Node.js: load() para um scraper testado
Guias

Cheerio Web Scraping em Node.js: load() para um scraper testado

TL;DR: Resumo: O Cheerio é um analisador de HTML rápido para Node.js com uma API ao estilo jQuery, por isso serve para web scraping quando os dados já estão no HTML bruto da página. Utilize fetch com o Cheerio para páginas estáticas, chame diretamente o JSON quando a página carrega os dados assim e renderize com um navegador apenas quando o JavaScript constrói o conteúdo. Este guia constrói um scraper testado com paginação, novas tentativas e exportação para JSON ou CSV.

Raluca Penciuc20 min read
Ler artigo
Folha de dicas de XPath para Web Scraping: Sintaxe, eixos e código real
Guias

Folha de dicas de XPath para Web Scraping: Sintaxe, eixos e código real

TL;DR: Esta folha de dicas de XPath cobre a sintaxe, predicados, eixos e funções que você realmente precisa para raspagem da web, além de uma tabela de tradução CSS-para-XPath e exemplos executáveis de Puppeteer e Scrapy. Use-a como referência na próxima vez que um seletor CSS quebrar silenciosamente em um site do qual você depende.

Mihai Maxim15 min read
Ler artigo
Como usar cURL com Python em 2026
Guias

Como usar cURL com Python em 2026

TL;DR: Existem três maneiras sensatas de usar o cURL com Python: fazer um shell para o binário curl com subprocessos, ligar-se à libcurl através do PycURL, ou pular o curl completamente e usar a biblioteca Requests. Saber como usar bem o cURL com Python significa conhecer todos os três. Este guia dá-lhe exemplos executáveis para todos os três, uma tabela de tradução de curl-flag para Python, e uma matriz de decisão para que possa escolher a ferramenta certa à primeira.

Andrei Ogiolan15 min read
Ler artigo
Aprenda a usar o Node-Fetch do NPM para fazer pedidos HTTP no Node.js
Guias

Aprenda a usar o Node-Fetch do NPM para fazer pedidos HTTP no Node.js

TL;DR: Descubra como utilizar o recém-lançado node-fetch para efetuar pedidos HTTP diretamente a partir do Node.js. O node-fetch é o equivalente à API fetch em JavaScript

Sorin-Gabriel Marica8 min read
Ler artigo
Os 6 melhores clientes HTTP em Python para web scraping
Guias

Os 6 melhores clientes HTTP em Python para web scraping

TL;DR: Escolha o cliente HTTP em Python mais adequado para o seu scraper. Compare o Requests, o HTTPX, o aiohttp, o urllib3, o curl_cffi e o Niquests, com exemplos práticos e conselhos sobre fiabilidade.

Mihnea-Octavian Manolache22 min read
Ler artigo
Como fazer scraping do LinkedIn em 2026: um guia Python
Guias

Como fazer scraping do LinkedIn em 2026: um guia Python

TL;DR: Raspar o LinkedIn significa trabalhar em torno de uma parede de autenticação agressiva, rastreamento comportamental e impressão digital TLS. Este guia fornece uma árvore de decisão método por página, padrões Python de trabalho para trabalhos, perfis e empresas (API oculta, JSON-LD, Selenium quando necessário) e uma lista de verificação anti-bloqueio consolidada para 2026.

Suciu Dan14 min read
Ler artigo
12 melhores ferramentas de raspagem da Web gratuitas em 2026: comparadas
Guias

12 melhores ferramentas de raspagem da Web gratuitas em 2026: comparadas

TL;DR: As 12 melhores ferramentas gratuitas de raspagem da web em 2026 divididas em quatro grupos: APIs gerenciadas com créditos gratuitos, estruturas de código aberto, extensões de navegador sem código e extratores de IA. Escolha primeiro por caso de uso (raspagem única vs. pipeline programado) e, em seguida, por nível de habilidade. A maioria dos níveis gratuitos cobre a avaliação, não a produção; no momento em que sua taxa de sucesso cai abaixo de ~90% ou você gasta mais horas em blocos do que em dados, é hora de passar para uma API paga.

Suciu Dan29 min read
Ler artigo
Alternativas à API do Yahoo Finance: Um guia para programadores
Guias

Alternativas à API do Yahoo Finance: Um guia para programadores

TL;DR: Compare os fornecedores de dados de mercado documentados e, em seguida, efetue a migração de acordo com requisitos explícitos relativos ao feed, ao fuso horário, aos ajustes, ao licenciamento e à validação.

Raluca Penciuc15 min read
Ler artigo
A raspagem da Web é legal em 2026? Quadro de conformidade
Guias

A raspagem da Web é legal em 2026? Quadro de conformidade

TL;DR: A raspagem da Web é legal? Normalmente sim, com algumas ressalvas. A legalidade depende do tipo de dados, do caminho de acesso, das jurisdições envolvidas e do que se faz com o resultado. Este guia dá-lhe um veredito direto, uma estrutura de cinco minutos antes da recolha de dados, os casos que interessam e uma lista de verificação que pode executar antes de enviar.

Suciu Dan15 min read
Ler artigo
As 9 melhores APIs de pesquisa de imagens do Google em 2022
Guias

As 9 melhores APIs de pesquisa de imagens do Google em 2022

TL;DR: Descubra as 9 melhores ferramentas da API de Pesquisa de Imagens do Google para uma extração eficiente de imagens. Saiba como otimizar a sua pesquisa de imagens e melhorar a recolha de dados com estas poderosas APIs.

Raluca Penciuc10 min read
Ler artigo
Como testar proxies: 6 métodos práticos
Guias

Como testar proxies: 6 métodos práticos

TL;DR: Proxies ruins são caros. Eles queimam largura de banda, acionam banimentos e corrompem silenciosamente os dados dos quais seus scrapers dependem. Este guia mostra como testar proxies em cinco sinais de saúde (conetividade, IP de saída, velocidade, anonimato e reputação) usando ping, curl, verificadores online, bancos de dados de IP e um script Python reutilizável que você pode colocar no seu pipeline de CI.

Robert Munceanu11 min read
Ler artigo
As melhores APIs de web scraping em 2026: comparação de 12, por funcionalidade e custo
Guias

As melhores APIs de web scraping em 2026: comparação de 12, por funcionalidade e custo

TL;DR: Resumo: A melhor API de web scraping depende da tarefa: uma API de páginas barata ganha em HTML estático, uma opção de renderização ou um navegador alojado em aplicações com muito JavaScript, um endpoint de SERP ou de e-commerce para registos já analisados, e uma API focada em Markdown para pipelines de LLM. Selecione dois ou três fornecedores e compare o custo por página utilizável nos seus URLs: os multiplicadores de créditos e a faturação de falhas decidem o custo real.

Suciu Dan30 min read
Ler artigo
Análise do webscraper.io: Preços, limites e quando mudar de serviço
Guias

Análise do webscraper.io: Preços, limites e quando mudar de serviço

TL;DR: Resumo: O Web Scraper da webscraper.io é uma extensão gratuita para Chrome e Firefox, com uma versão paga, o Web Scraper Cloud, e é uma boa escolha para tarefas recorrentes pequenas e médias em sites públicos comuns. Mantenha-o quando poucas pessoas atualizam alguns sites diária ou semanalmente e alguém mantém os seletores. Mude quando precisar de muitos sites, alvos protegidos ou com muito JavaScript, ou controlo ao nível do código.

Suciu Dan19 min read
Ler artigo
Cookies HTTP: Um guia para programadores sobre a extração de sessões
Guias

Cookies HTTP: Um guia para programadores sobre a extração de sessões

TL;DR: Compreenda como os «cookie jars», as políticas do navegador e a propriedade da sessão afetam as respostas obtidas por scraping. Aprenda a diagnosticar falhas de autenticação sem expor credenciais.

Gabriel Cioci14 min read
Ler artigo
Aplicações de extração de dados: compare quatro fluxos de trabalho reais
Guias

Aplicações de extração de dados: compare quatro fluxos de trabalho reais

TL;DR: Compare o Octoparse, o ParseHub, o Web Scraper e o Apify em termos de configuração do projeto, execução, exportações e manutenção, através de um projeto-piloto que testa todo o fluxo de trabalho de entrega.

Mihnea-Octavian Manolache15 min read
Ler artigo
Extracção automatizada de dados da Web: crie tarefas que possa recuperar
Guias

Extracção automatizada de dados da Web: crie tarefas que possa recuperar

TL;DR: Crie coletores agendados com identidades de execução explícitas, tentativas de repetição limitadas, validação e entrega segura para repetição. Saiba como recuperar falhas sem ocultar dados em falta.

Andrei Ogiolan17 min read
Ler artigo
Alternativas ao Scrapebox: cinco ferramentas para diferentes tarefas
Guias

Alternativas ao Scrapebox: cinco ferramentas para diferentes tarefas

TL;DR: Encontre a solução adequada para auditorias de sites, rastreamento personalizado, interações com o navegador, extração visual ou limpeza de conjuntos de dados e, em seguida, valide a mudança através de um projeto-piloto.

Raluca Penciuc15 min read
Ler artigo
Ferramentas de extração de conteúdo: escolha com base na fidelidade do texto
Guias

Ferramentas de extração de conteúdo: escolha com base na fidelidade do texto

TL;DR: Escolha um extrator para artigos com formatos variados ou regras de modelo específicas e, em seguida, teste a fidelidade do texto, os metadados, a estrutura e o tratamento de erros no seu próprio corpus.

Robert Munceanu15 min read
Ler artigo
Alternativas ao Puppeteer: Principais ferramentas para raspagem e testes 2026
Guias

Alternativas ao Puppeteer: Principais ferramentas para raspagem e testes 2026

TL;DR: O Puppeteer é ótimo para automação rápida do Chromium, mas seu bloqueio de navegador único, escala pesada de recursos e nenhum suporte anti-bot embutido empurram muitas equipes para alternativas. Este guia divide as alternativas mais fortes do Puppeteer por caso de uso (raspagem, teste E2E, QA entre navegadores, celular), fornece uma tabela de comparação lado a lado e termina com uma estrutura de decisão para que você possa escolher a ferramenta certa sem tentativa e erro.

Suciu Dan17 min read
Ler artigo
Extracção de dados de sites: um fluxo de trabalho prático com o DOM
Guias

Extracção de dados de sites: um fluxo de trabalho prático com o DOM

TL;DR: Crie um coletor de navegador com prontidão explícita, registos validados e condições de paragem fiáveis. Saiba quando a extração do DOM é preferível às capturas de ecrã e ao OCR.

Raluca Penciuc14 min read
Ler artigo
Alternativas ao Charles Proxy: Fiddler, Proxyman, mitmproxy
Guias

Alternativas ao Charles Proxy: Fiddler, Proxyman, mitmproxy

TL;DR: Compare o mitmproxy, o Fiddler Everywhere, o HTTP Toolkit e o Proxyman em função das tarefas de depuração. Recorra a um ensaio controlado para verificar a captura, a partilha de provas e a limpeza de certificados.

Robert Sfichi15 min read
Ler artigo
Alternativa ao import.io: Escolha com base no fluxo de trabalho de dados
Guias

Alternativa ao import.io: Escolha com base no fluxo de trabalho de dados

TL;DR: Compare o Octoparse, o Browse AI, o Apify e o Scrapy em função da responsabilidade pela extração e das necessidades de entrega. Crie um projeto-piloto que verifique a integridade, a atualidade e a preparação para a migração.

Ștefan Răcilă16 min read
Ler artigo
Site Scraper: Crie um coletor que possa validar
Guias

Site Scraper: Crie um coletor que possa validar

TL;DR: Conceba um coletor de sites, desde a definição do registo até à entrega verificada. Defina o âmbito da fonte, escolha um modelo de execução, valide as observações e recupere execuções incompletas.

Mihnea-Octavian Manolache15 min read
Ler artigo
Alternativas ao PhantomJS: O que utilizar agora e como fazer a migração
Guias

Alternativas ao PhantomJS: O que utilizar agora e como fazer a migração

TL;DR: O PhantomJS deixou de ser desenvolvido em 2018. Escolha um substituto de acordo com a função do seu script, mapeie as chamadas do PhantomJS para o Playwright ou o Puppeteer e elimine as dependências antigas.

Sorin-Gabriel Marica21 min read
Ler artigo
8 alternativas ao Scrapy para 2026: escolha em função do gargalo, do custo e do risco
Guias

8 alternativas ao Scrapy para 2026: escolha em função do gargalo, do custo e do risco

TL;DR: Resumo: a escolha certa depende de o gargalo do Scrapy ser a renderização, o bloqueio, a adequação da linguagem ou as operações. Sempre que possível, mantenha ou amplie os spiders em bom estado; use ferramentas de navegador para páginas interativas, plataformas alojadas para operações, ferramentas leves para tarefas estáticas delimitadas e APIs geridas quando a infraestrutura de pedidos for a limitação. Valide a lista final com um modelo de custos e uma prova de conceito representativa.

Mihai Maxim21 min read
Ler artigo
Alternativa ao Web Scraper: Adapte primeiro o fluxo de trabalho
Guias

Alternativa ao Web Scraper: Adapte primeiro o fluxo de trabalho

TL;DR: Compare o Octoparse, o Browse AI, o Apify e o Playwright em termos de modelo de criação. Preserve a navegação, registe a identidade e o comportamento de entrega ao substituir o Web Scraper.

Suciu Dan15 min read
Ler artigo
Alternativa ao WebHarvy: Comparar fluxos de trabalho de dados de produtos
Guias

Alternativa ao WebHarvy: Comparar fluxos de trabalho de dados de produtos

TL;DR: Compare o Octoparse, o ParseHub, o Web Scraper e o Apify para a extração de produtos. Verifique as variantes, as ofertas, os artigos em falta e as exportações antes de substituir o WebHarvy.

Suciu Dan16 min read
Ler artigo
Alternativa ao Niche Scraper: Escolha melhores dados de pesquisa
Guias

Alternativa ao Niche Scraper: Escolha melhores dados de pesquisa

TL;DR: Compare alternativas de pesquisa de produtos por tarefa, origem das evidências e necessidades de entrega. Crie um teste repetível sem confundir a procura estimada com as vendas verificadas.

Mihnea-Octavian Manolache15 min read
Ler artigo
Melhores alternativas ao Wget: Ferramentas modernas de download CLI comparadas
Guias

Melhores alternativas ao Wget: Ferramentas modernas de download CLI comparadas

TL;DR: O Wget é fiável mas está a envelhecer. Se você precisa de downloads paralelos, pegue o aria2. Para uma ampla cobertura de protocolos e scripts, curl é a opção ideal. Quer um fluxo de trabalho de teste de API mais amigável? HTTPie (ou seu irmão em Rust xh) se encaixa perfeitamente. E se quiser o caminho de atualização mais próximo, o wget2 adiciona HTTP/2, multithreading e um sistema de plugins, mantendo os mesmos padrões de comandos que já conhece.

Anda Miuțescu12 min read
Ler artigo
Comparação de 5 alternativas ao node-fetch: Native Fetch, Axios, Got, Ky e SuperAgent
Guias

Comparação de 5 alternativas ao node-fetch: Native Fetch, Axios, Got, Ky e SuperAgent

TL;DR: Resumo: Comece com o Fetch nativo nas versões compatíveis do Node.js e, só depois, adicione uma dependência se esta substituir código personalizado relevante. O Axios privilegia a conveniência entre diferentes ambientes de execução, o Got oferece um controlo mais aprofundado específico do Node.js, o Ky melhora a ergonomia do Fetch e o SuperAgent adapta-se a fluxos de trabalho fluentes com formulários e ficheiros. Seja qual for a sua escolha, preserve o comportamento relativo ao estado, ao tempo de espera, às tentativas de repetição, aos cookies e aos fluxos durante a migração.

Raluca Penciuc18 min read
Ler artigo
Como a extração de dados da Web em R torna a ciência de dados divertida
Guias

Como a extração de dados da Web em R torna a ciência de dados divertida

TL;DR: Saiba como dar os primeiros passos no seu próximo projeto utilizando web scraping em R e rvest.

Raluca Penciuc9 min read
Ler artigo
Profit Scraper: Verificar a disponibilidade e substituir o fluxo de trabalho
Guias

Profit Scraper: Verificar a disponibilidade e substituir o fluxo de trabalho

TL;DR: Verifique a identidade atual do serviço antes de seguir recomendações antigas do Profit Scraper. Crie um fluxo de trabalho alternativo para a listagem de dados, a pesquisa de preços de venda e as premissas de custos transparentes.

Mihai Maxim15 min read
Ler artigo
O guia definitivo sobre como começar a fazer web scraping com Elixir
Guias

O guia definitivo sobre como começar a fazer web scraping com Elixir

TL;DR: Este é o guia completo para a extração de dados da Web com Elixir. Aprenda a criar um programa de extração de dados da Web utilizando uma das melhores linguagens de programação para tarefas simultâneas.

Robert Sfichi8 min read
Ler artigo
Aprender web scraping com Rust
Guias

Aprender web scraping com Rust

TL;DR: O Rust é uma linguagem rápida e eficiente em termos de memória. Mas como é que lida com a extração de dados da Web? Consulte este guia para principiantes e descubra como pode utilizá-la para criar um programa básico de extração de dados da Web.

Mihai Maxim7 min read
Ler artigo
Web scraping com Go: criar um scraper HTML fiável
Guias

Web scraping com Go: criar um scraper HTML fiável

TL;DR: Crie um scraper em Go que extraia registos de livros para JSON. Siga um exemplo testado com o goquery e, em seguida, planeie a paginação, o Colly, a renderização no navegador e o tratamento de erros.

Sorin-Gabriel Marica15 min read
Ler artigo
Alternativa ao Octoparse: Compare os trabalhos de que é autor
Guias

Alternativa ao Octoparse: Compare os trabalhos de que é autor

TL;DR: Compare o Web Scraper, o Browse AI, o Apify e o Scrapy em termos de trabalho retido. Recorra a um teste de reparabilidade controlado e verifique se a entrega está completa antes de substituir o Octoparse.

Gabriel Cioci15 min read
Ler artigo
Web scraping em C# com HttpClient, AngleSharp e Playwright
Guias

Web scraping em C# com HttpClient, AngleSharp e Playwright

TL;DR: Resumo: Para web scraping em C#, comece no .NET 10 com o HttpClient integrado para descarregar páginas e o AngleSharp para analisar HTML com seletores CSS. Escolha o HtmlAgilityPack se preferir XPath ou mantiver código mais antigo, e acrescente o Playwright para .NET quando o JavaScript constrói a página. Este guia constrói um scraper com novas tentativas educadas, rastreio limitado, exportação para CSV e JSON e testes offline.

Sorin-Gabriel Marica30 min read
Ler artigo
Os melhores raspadores da Web do Node.js em 2026: 6 bibliotecas comparadas
Guias

Os melhores raspadores da Web do Node.js em 2026: 6 bibliotecas comparadas

TL;DR: Os melhores raspadores da web Node.js em 2026 se dividem em dois campos: clientes HTTP como Axios e Superagent para páginas estáticas e navegadores sem cabeça como Puppeteer e Playwright para sites com muito JavaScript. Escolha por fluxo de trabalho, não por popularidade, e transfira a renderização para uma API de raspagem gerenciada quando as defesas anti-bot ou a escala começarem a consumir seu tempo de engenharia.

Suciu Dan12 min read
Ler artigo
Alternativa ao ProxyScrape: escolher a certa
Guias

Alternativa ao ProxyScrape: escolher a certa

TL;DR: Compare redes de proxy e a recolha gerida com base no comportamento por sessão, na origem dos dados e no custo por registo aceite. Recorra a um teste controlado e a um plano de migração reversível.

Ștefan Răcilă14 min read
Ler artigo
7 alternativas ao Axios comparadas para navegadores, Node.js e scraping
Guias

7 alternativas ao Axios comparadas para navegadores, Node.js e scraping

TL;DR: Resumo: Utilize o Fetch nativo para uma base com poucas dependências, o Ky para a ergonomia do Fetch, o Got ou o SuperAgent para um comportamento do cliente mais avançado e o Alova quando o estado da solicitação do front-end for o verdadeiro requisito. Opte pelo Puppeteer ou por uma API de scraping gerida apenas quando a renderização, a interação, os proxies ou os sistemas anti-bot tornarem o transporte HTTP normal insuficiente.

Raluca Penciuc17 min read
Ler artigo
Como extrair dados das páginas do eBay para obter informações sobre preços
Guias

Como extrair dados das páginas do eBay para obter informações sobre preços

TL;DR: No caso de novos produtos, é difícil definir o preço certo. Bem, há uma solução: recolher dados dos gigantes do comércio eletrónico e definir os preços com base em dados concretos

Gabriel Cioci5 min read
Ler artigo
Como fazer Web Scrape com Puppeteer e NodeJS Guia 2026
Guias

Como fazer Web Scrape com Puppeteer e NodeJS Guia 2026

TL;DR: O Puppeteer dá-lhe o controlo total de uma instância do Chrome sem cabeça a partir do Node.js, tornando-o a ferramenta de eleição para raspar páginas renderizadas em JavaScript. Este guia o orienta na instalação, extração baseada em seletor, rolagem infinita, login de formulário, intercetação de solicitação, plug-ins furtivos, exportação de dados estruturados e implantação do Docker, para que você possa passar de um script de brinquedo para um raspador de nível de produção.

Gabriel Cioci18 min read
Ler artigo
Tutorial BeautifulSoup: Construa um Scraper Python real a partir do zero
Guias

Tutorial BeautifulSoup: Construa um Scraper Python real a partir do zero

TL;DR: Este tutorial do BeautifulSoup guia-o através de um scraper Python completo, desde a instalação do pip até um script reforçado que pagina o Hacker News, exporta para CSV e JSON, e é educado o suficiente para não ser bloqueado. Cada snippet é executável, e nós apontamos os momentos exatos em que o BeautifulSoup é a ferramenta errada.

Sorin-Gabriel Marica19 min read
Ler artigo
Web scraping em Java: criar um scraper fiável
Guias

Web scraping em Java: criar um scraper fiável

TL;DR: Resumo: Comece com o HttpClient e o Jsoup quando os dados estiverem presentes no HTML devolvido, recorra a uma fonte JSON exposta quando for adequado e adicione renderização ou o Selenium apenas para estados dependentes do navegador. Este tutorial de web scraping em Java desenvolve uma base de código Java 21 através de paginação, concorrência limitada, novas tentativas, sessões, validação e saída duradoura.

Raluca Penciuc31 min read
Ler artigo
Web Scraping com Selenium: Tutorial passo-a-passo em Python
Guias

Web Scraping com Selenium: Tutorial passo-a-passo em Python

TL;DR: O Selenium permite que você faça scraping de sites com JavaScript pesado, conduzindo um navegador real a partir do código Python. Este tutorial acompanha-o em todas as fases: instalar o Selenium, configurar o Chrome, localizar e interagir com elementos, lidar com esperas e paginação, exportar dados limpos e escalar o seu scraper com proxies, Selenium Grid e alternativas baseadas em API.

Robert Sfichi32 min read
Ler artigo
Web scraping em C e C++ com a libcurl e o lexbor
Guias

Web scraping em C e C++ com a libcurl e o lexbor

TL;DR: Extrair dados de sites em C e C++ com a libcurl e o lexbor: criar um rastreador C++20 «educado» com o CMake e o vcpkg, exportar ficheiros CSV e JSON organizados, lidar com páginas em JavaScript de três formas diferentes e executar o mesmo extrator em C puro.

Raluca Penciuc28 min read
Ler artigo
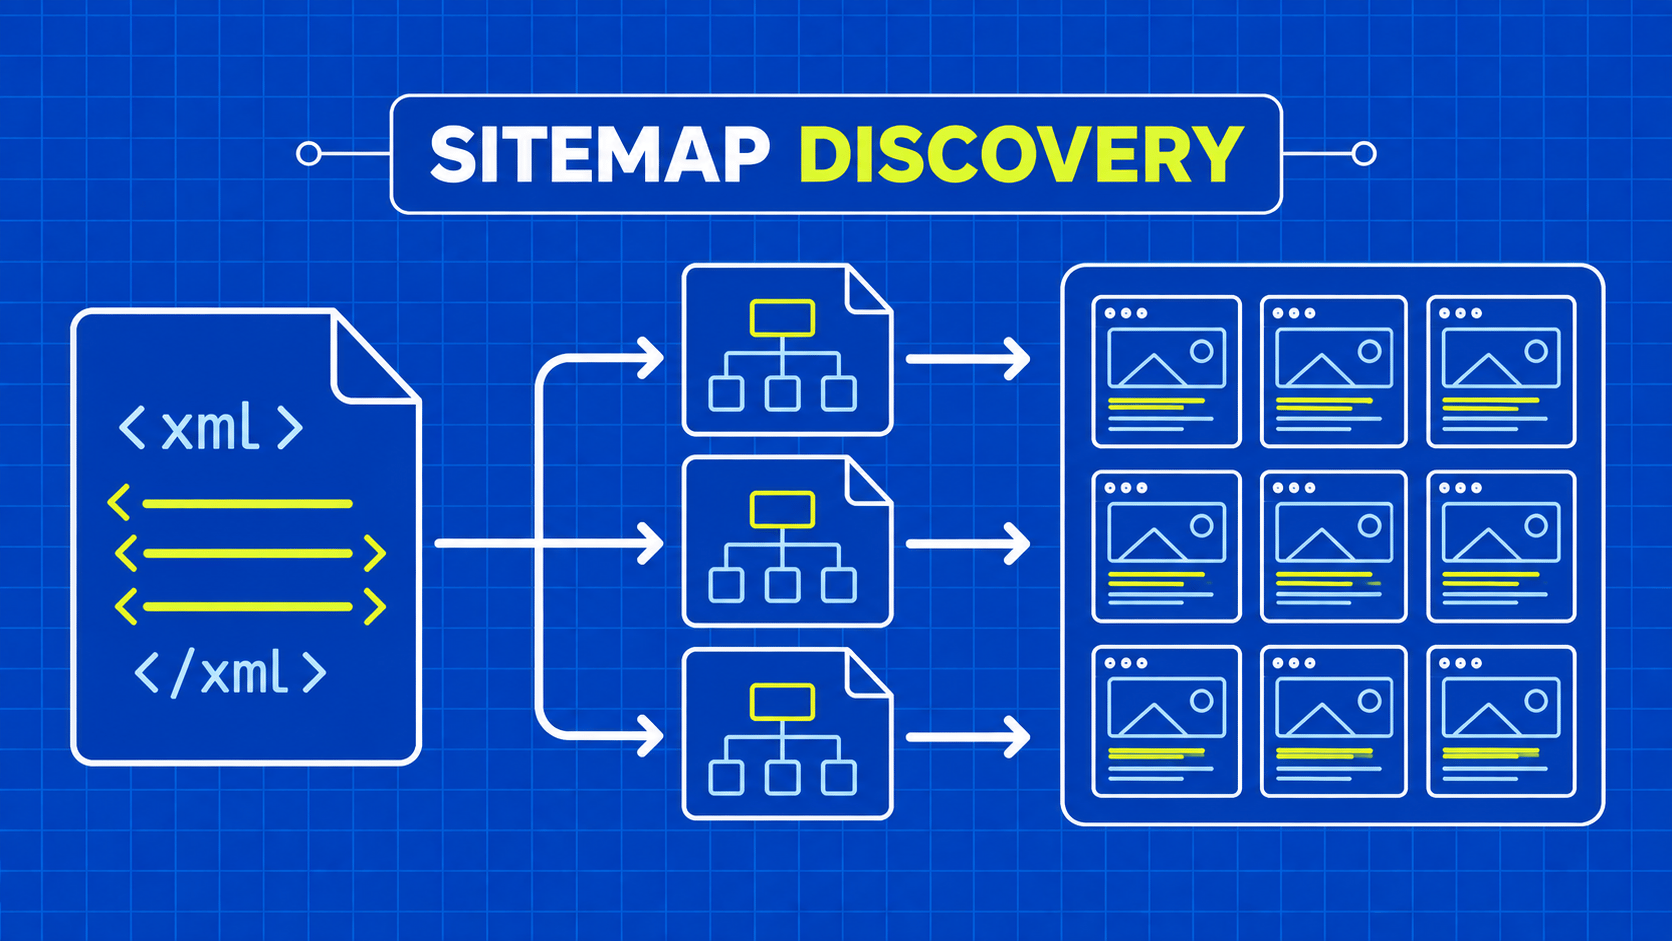
Web scraping de mapas do site: descobrir URLs dentro de limites seguros
Guias

Web scraping de mapas do site: descobrir URLs dentro de limites seguros

TL;DR: Transforme os índices do mapa do site numa fila de descoberta de URLs rastreáveis. Aprenda sobre a análise que tem em conta os espaços de nomes, os limites dos protocolos, as precauções relativas à atualidade e os limites de segurança para URLs não confiáveis.

Robert Munceanu16 min read
Ler artigo
Como utilizar a WebScrapingAPI: Guia da API de extração de dados e do Web MCP
Guias

Como utilizar a WebScrapingAPI: Guia da API de extração de dados e do Web MCP

TL;DR: Envie o seu primeiro pedido à API WebScrapingAPI Scraper com a chave definida numa variável de ambiente e, em seguida, adicione a renderização em JavaScript, a segmentação geográfica, as regras de extração e as tarefas assíncronas apenas quando um alvo as necessitar. O guia aborda todos os códigos de erro documentados, o acompanhamento dos custos por chamada, os planos a partir de outubro de 2026, quando optar pela API do Navegador, SERP, Crawl ou Dados, e como ligar agentes de IA através do Web MCP.

Robert Munceanu28 min read
Ler artigo
Web scraping com Python em 2026: manual do programador
Guias

Web scraping com Python em 2026: manual do programador

TL;DR: Resumo: Este é um guia prático sobre web scraping em Python que começa com uma árvore de decisão e, em seguida, aborda o Requests e o Beautiful Soup, o XPath com o lxml, o Playwright, o Selenium, o Scrapy e uma API de scraping para alvos difíceis. No final, ficará com código funcional, um manual de estratégias anti-bloqueio, padrões de armazenamento compatíveis com LLM e uma lista de verificação para produção.

Raluca Penciuc34 min read
Ler artigo

Comece a construir

Pronto para expandir a sua recolha de dados?

Junte-se a mais de 2.000 empresas que utilizam a WebScrapingAPI para extrair dados da Web à escala empresarial, sem quaisquer custos de infraestrutura.