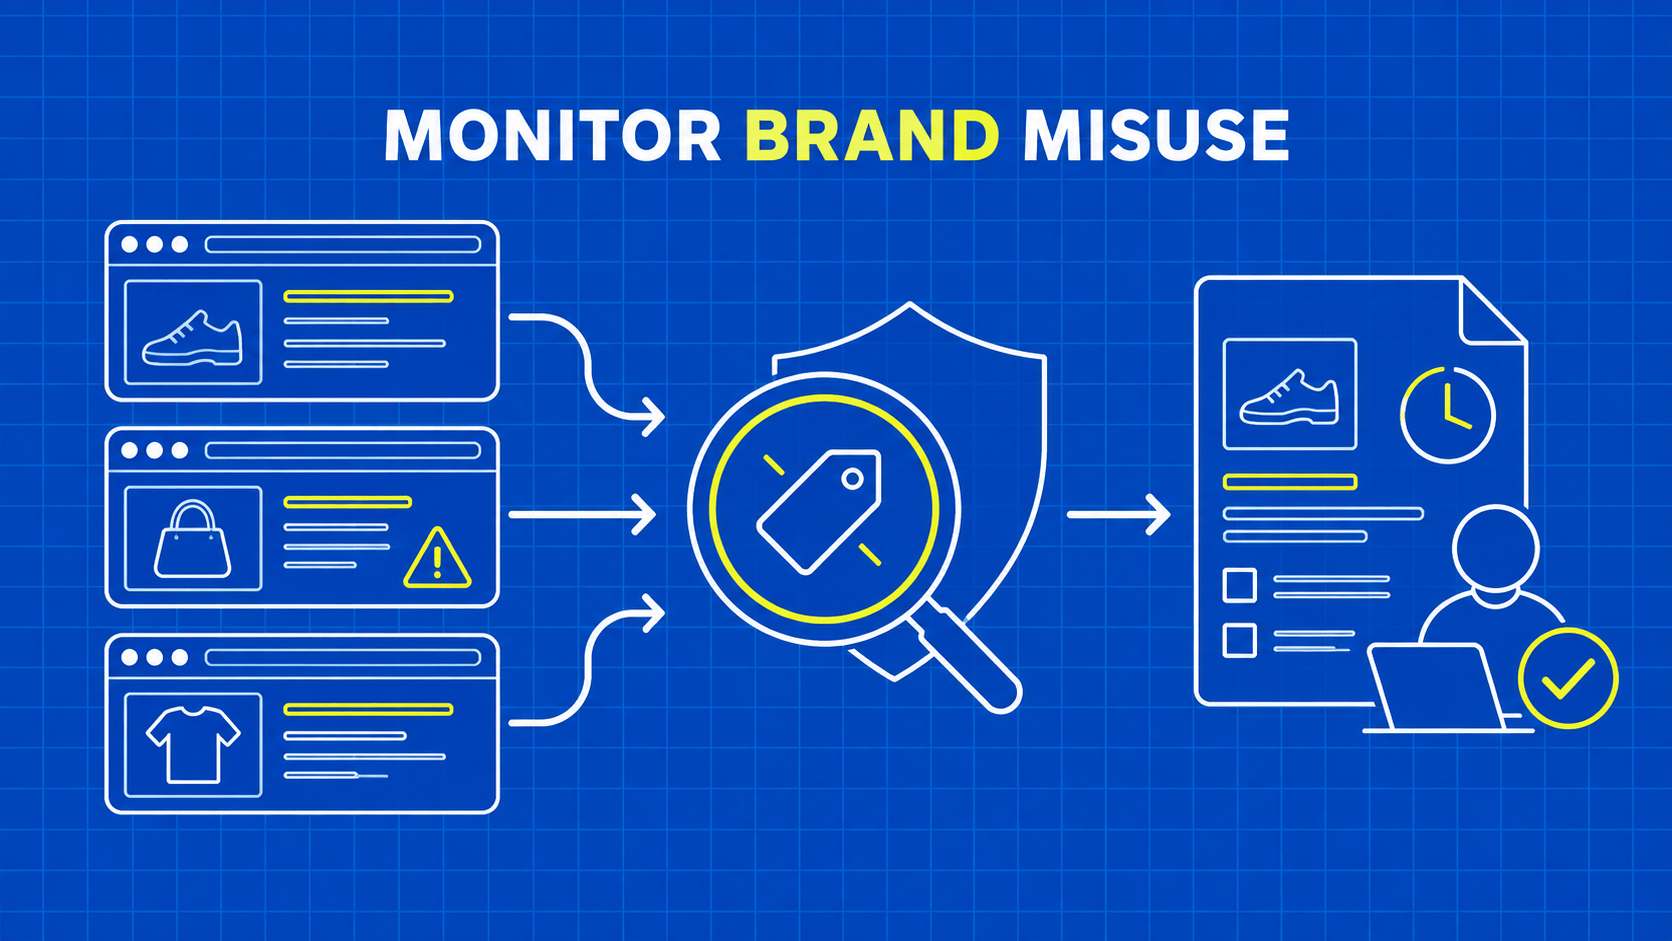
Resumo: o web scraping para proteção de marca ajuda as equipes a encontrar e acompanhar anúncios que merecem investigação. Compare as observações com os cadastros aprovados de produtos e vendedores, preserve evidências datadas e encaminhe casos explicáveis para revisores humanos, em vez de declarar automaticamente que um produto é falsificado ou registrar denúncias.
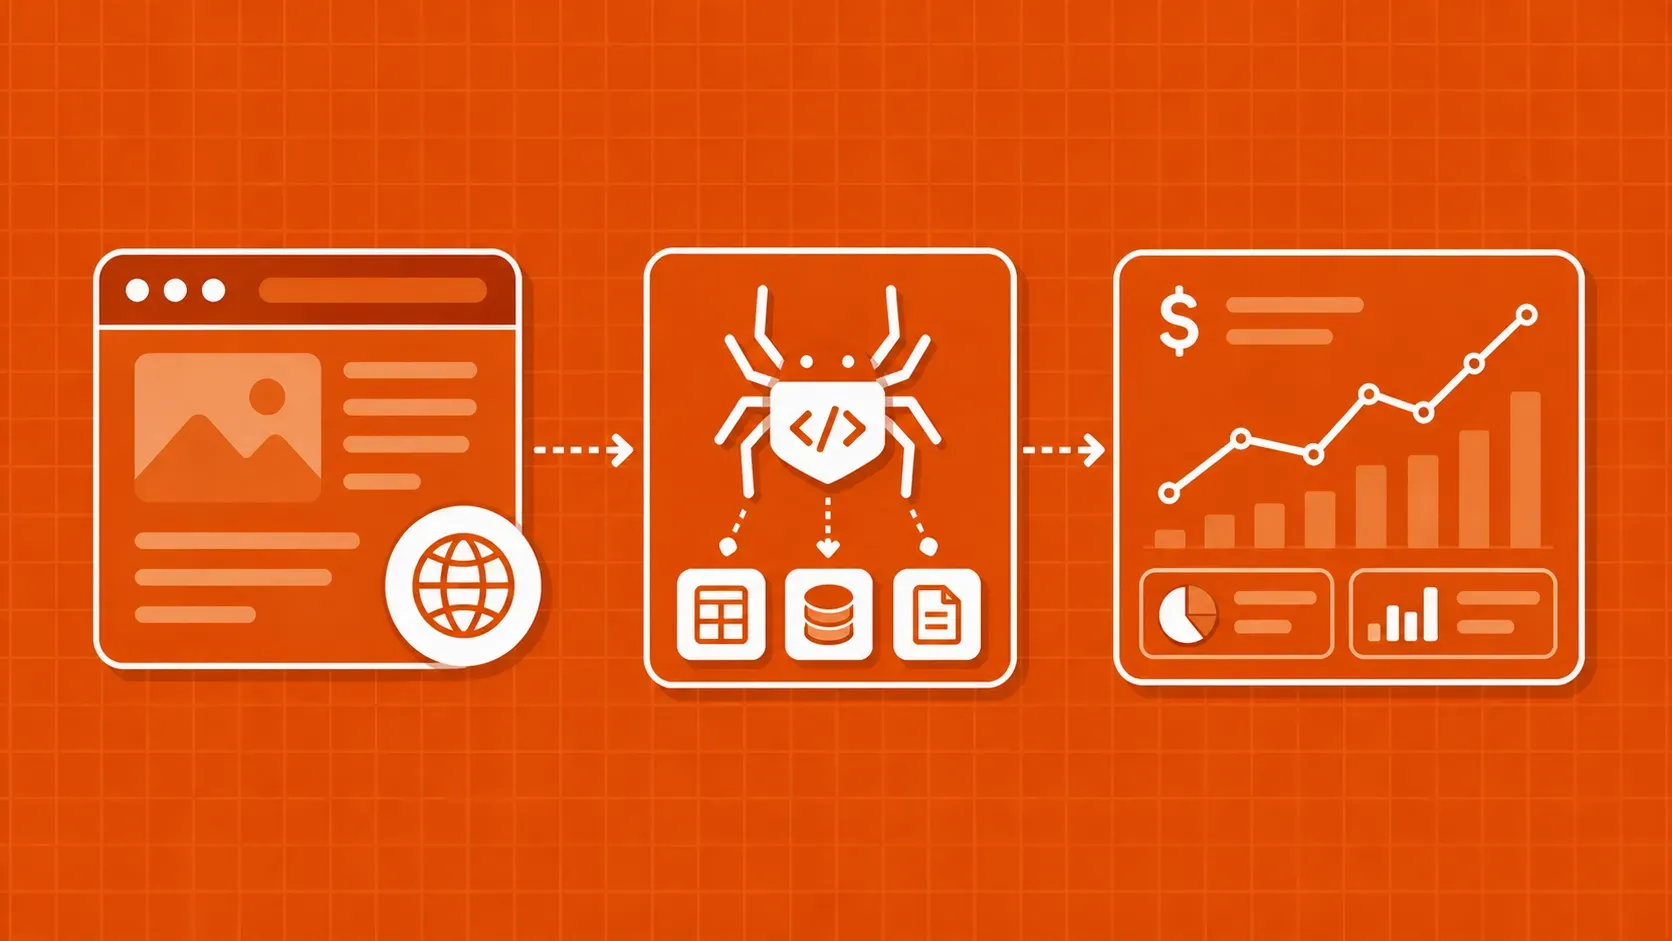
Web scraping para proteção de marca é a coleta automatizada de informações on-line sobre produtos, vendedores e uso da marca para apoiar o monitoramento e a investigação. O resultado útil é um caso de revisão sustentado por evidências: o que mudou, onde apareceu, com qual registro de referência entra em conflito e o que um revisor deve verificar em seguida.
Inteligência de preços, pesquisa de mercado e geração de leads aparecem ao lado do monitoramento de marca entre os casos de uso de web scraping para negócios.
Imagine que uma foto de produto conhecida apareça em um novo anúncio de marketplace. O preço está anormalmente baixo, e o vendedor não consta no seu cadastro de distribuidores. Essa combinação merece atenção, mas não prova que o produto é falsificado. O item pode ser usado, o cadastro do vendedor pode estar incompleto ou o anúncio pode descrever outro tamanho de embalagem.
Um bom sistema de monitoramento preserva essas distinções. Ele reduz o tempo necessário para encontrar e investigar candidatos sem transformar observações incompletas em acusações. Este guia mostra como construir esse sistema: estabelecer uma base de referência, descobrir candidatos, criar identidades estáveis para os anúncios, capturar evidências, priorizar a revisão e acompanhar os casos pelos canais oficiais de denúncia. A implementação foca na qualidade dos dados e na rastreabilidade que o desenvolvedor controla, deixando os julgamentos jurídicos e as decisões de aplicação para as pessoas responsáveis.