Saltar para o conteúdo
Comece grátis
Voltar ao blogue

Como utilizar a API do Amazon Scraper: Guia de início rápido

Robert SfichiÚltima atualização em 24 min read
Como utilizar a API do Amazon Scraper: Guia de início rápido
Resumo: Para utilizar a Amazon Scraper API, envie um pedido GET para https://ecom.webscrapingapi.com/v1 com api_key, engine=amazon, um tipo de pedido e a entrada desse tipo, como um ASIN em product_id ou uma palavra-chave em q. Utilize product para um ASIN, search para uma palavra-chave, bestsellers ou todays-deals para um ID de categoria, e seller_products ou seller_feedback para um ID de vendedor. Este guia aborda os nove tipos de pedido, 20 marketplaces, erros e planos.

Precisa de dados da Amazon relativos a produtos, pesquisas, classificações, avaliações ou vendedores que o seu código possa armazenar e comparar entre mercados, sem ter de manter um scraper para cada layout de página. Este guia utiliza a API da Amazon da WebScrapingAPI. No final, irá enviar um primeiro pedido com a sua chave numa variável de ambiente, escolher o tipo de pedido correto, selecionar o domínio da Amazon e a localização de entrega adequados, ler todos os formatos de resposta com um único analisador, repetir a tentativa de acordo com o contrato de erros documentado e dimensionar um plano.

Início rápido

  • Ponto de extremidade: https://ecom.webscrapingapi.com/v1 (GET)
  • Obrigatório: api_key, engine=amazon, type, além da entrada específica do tipo (q, product_id, category_id, ou seller_id)
  • Tipos de pedido: nove, desde um único produto até avaliações de vendedores
  • Teste gratuito: 100 pedidos na Amazon

O que é a API Amazon Scraper e o que é que ela devolve?

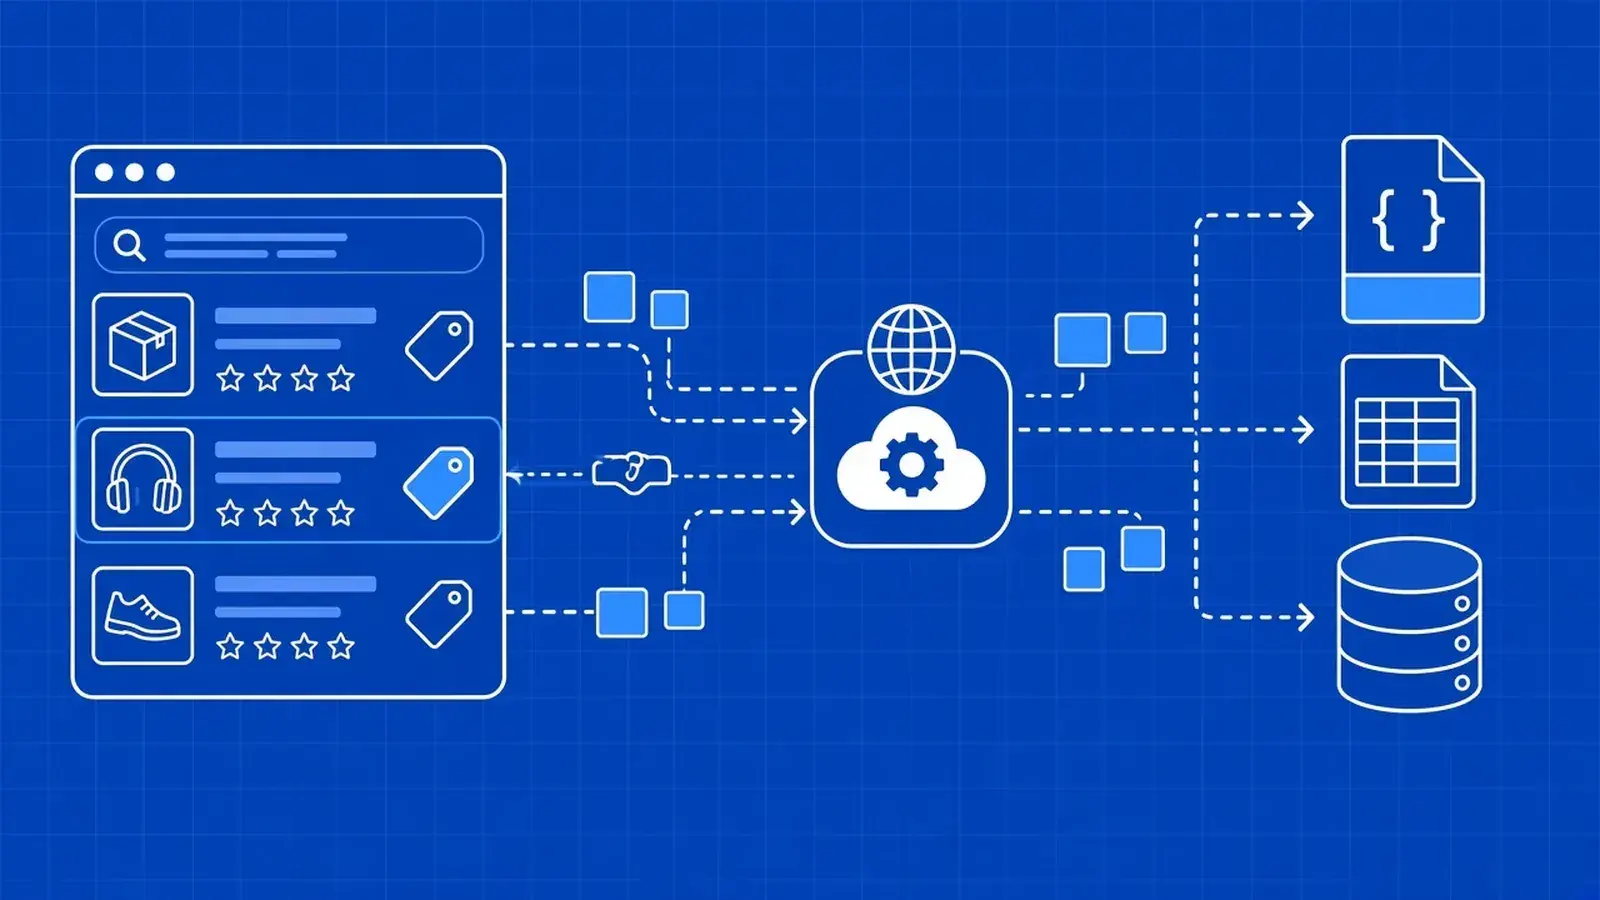
A API da Amazon da WebScrapingAPI é um ponto de extremidade GET que aceita um tipo de pedido, como produto, pesquisa ou mais vendidos, além de um ASIN, palavra-chave, categoria ou ID de vendedor, e devolve a página correspondente da Amazon em JSON estruturado. A WebScrapingAPI trata do acesso, da extração e da manutenção do analisador. O seu código seleciona as páginas, os mercados e os campos e armazena os resultados.

Nomeia a página através type e a sua entrada, e todas as respostas são devolvidas com o mesmo layout de nível superior: o que pediu, o que a Amazon apresentou e os registos nessa página. Não precisa de escrever seletores, nem de os reescrever quando a Amazon alterar a sua marcação.

Eis quem faz o quê:

  • A WebScrapingAPI opera: acesso à fonte, extração de dados, atualizações do analisador e monitorização da qualidade.
  • A sua equipa é responsável por: quais as páginas e mercados a recolher, quais os campos a manter, os horários de atualização e entrega, e a análise desenvolvida com base nisso.

A API abrange resultados de pesquisa e de categorias, páginas de produtos e variações, e listagens de ofertas dos vendedores. As equipas utilizam-nas para a «Buy Box» e inteligência de ofertas, quota de pesquisa e de categorias, e análise de variações e sinais de avaliações. A Amazon é uma fonte no catálogo mais vasto da Data API.

Cada resposta corresponde a uma observação de uma página, num mercado, num determinado momento. Um preço, uma classificação ou um número de avaliações só tem significado no contexto das definições e do momento em que foi gerado.

Como obter uma chave de API e enviar o seu primeiro pedido à Amazon?

Crie uma conta na WebScrapingAPI, subscreva a API da Amazon no painel de controlo e guarde a sua chave numa variável de ambiente. Em seguida, envie uma solicitação GET para https://ecom.webscrapingapi.com/v1 com api_key, engine=amazon, type=search e q definido com a sua palavra-chave. Deixe que o seu cliente HTTP codifique os parâmetros e mantenha a chave no seu servidor.

  1. Crie uma conta com e-mail e palavra-passe, GitHub ou Google.
  2. Subscreva a API da Amazon no painel de controlo. O período de avaliação inclui 100 pedidos à Amazon por 0 $.
  3. Guarde a chave numa variável de ambiente, como WSA_API_KEY, ou num gestor de segredos.
  4. Envie a solicitação a partir de um terminal, Python ou Node.js.

Guarde a chave nos segredos do lado do servidor, nunca no código front-end, num repositório público, numa linha de registo ou numa captura de ecrã. Está associada à sua conta e ao limite do seu plano, pelo que quem a possuir gasta as suas solicitações.

# Paste your key from the dashboard, or load it from your secrets manager. Never commit it.
export WSA_API_KEY="..."

curl --get "https://ecom.webscrapingapi.com/v1" \
  --max-time 130 \
  --data-urlencode "engine=amazon" \
  --data-urlencode "api_key=$WSA_API_KEY" \
  --data-urlencode "type=search" \
  --data-urlencode "q=memory card"

O resto deste guia baseia-se no cliente Python abaixo. Este lê a chave do ambiente, repete as tentativas de acordo com as regras de erro abordadas mais adiante e devolve o JSON analisado, juntamente com o cabeçalho de crédito da chamada. Instale o Requests com pip install requests.

# amazon_client.py
import os
import random
import time
from urllib.parse import urlencode

import requests

SCRAPER_URL = "https://ecom.webscrapingapi.com/v1"
RETRYABLE = {429, 500, 502, 503}


def redacted_url(params):
    """The request URL with the key hidden. Log this, never the real URL."""
    return f"{SCRAPER_URL}?{urlencode({'engine': 'amazon', 'api_key': '***', **params}, safe='*')}"


def amazon_get(params, retries=3, timeout=130):
    query = {"engine": "amazon", "api_key": os.environ["WSA_API_KEY"], **params}
    for attempt in range(retries + 1):
        resp = requests.get(SCRAPER_URL, params=query, timeout=timeout)
        if resp.status_code == 200:
            return resp.json(), resp.headers.get("Searchdata-Call-Credit-Usage")
        retry_422 = resp.status_code == 422 and attempt == 0  # retry a website error once
        if (resp.status_code not in RETRYABLE and not retry_422) or attempt == retries:
            raise RuntimeError(f"{resp.status_code} on {redacted_url(params)}: {resp.text[:200]}")
        wait = resp.headers.get("Retry-After", "")
        delay = int(wait) if wait.isdigit() else 2 ** attempt
        time.sleep(delay + random.random())  # exponential backoff with jitter
# first_request.py
from amazon_client import amazon_get

data, credits = amazon_get({"type": "search", "q": "memory card"})
results = data.get("search_results", {}).get("product_results", [])
print(len(results), "products; credits for this call:", credits)

A mesma chamada no Node.js 18 ou posterior não necessita de dependências:

// amazon_request.mjs — run with: node amazon_request.mjs
const params = new URLSearchParams({
  engine: "amazon",
  api_key: process.env.WSA_API_KEY,
  type: "search",
  q: "memory card",
});

const res = await fetch(`https://ecom.webscrapingapi.com/v1?${params}`, {
  signal: AbortSignal.timeout(130_000),
});
if (!res.ok) throw new Error(`${res.status}: ${await res.text()}`);

const data = await res.json();
console.log("credits for this call:", res.headers.get("searchdata-call-credit-usage"));
console.log(data.search_results?.product_results?.length, "products");

Uma palavra-chave com um espaço, &ou + deve seguir as regras de codificação por por cento. Um & inicia silenciosamente um novo parâmetro, o que a API rejeita com a mensagem «Parâmetro '<nome>' não permitido». As opções --data-urlencode e URLSearchParams do curl, bem como o argumento params do Requests, realizam a codificação automaticamente. Cada exemplo define também um tempo limite de 130 segundos, para que uma página lenta não bloqueie um worker.

Resposta de exemplo (copiada da documentação da API, resumida):

{
  "search_parameters": {
    "amazon_url": "https://www.amazon.com/s?k=memory+card",
    "engine": "amazon",
    "amazon_domain": "amazon.com",
    "type": "search",
    "q": "memory card"
  },
  "search_information": {
    "organic_results_state": "Results for exact spelling",
    "total_results": "5,000",
    "query_displayed": "memory card"
  },
  "search_results": {
    "product_results": [
      {
        "position": 1,
        "product_id": "B08TJRVWV1",
        "title": "Amazon Basics microSDXC Memory Card with Full Size Adapter",
        "link": "https://www.amazon.com/dp/B08TJRVWV1",
        "price": "$12.42",
        "rating": { "rating": "4.7 out of 5 stars", "total_ratings": 33500 }
      }
    ]
  }
}

Documentação: Aceder à API

Que tipos de pedidos da Amazon pode utilizar?

Defina o tipo como um dos nove valores: «product» para um ASIN, «search» para uma palavra-chave, «category», «bestsellers», «new-releases» ou «todays-deals» para um ID de categoria, e «seller_products», «seller_profile» ou «seller_feedback» para um ID de vendedor. «seller_feedback» é a solicitação de avaliações. Cada tipo requer os seus próprios dados de entrada e devolve linhas no seu próprio local.

Objetivo

type

Entrada obrigatória

Entradas opcionais do tipo

As linhas encontram-se em

Secção

Um produto por ASIN (incluindo classificação e número de avaliações)

product

product_id

—

product_results (objeto)

Produto por ASIN

Resultados por palavra-chave

search

q

page, sort_by, filter_by

search_results.product_results

Resultados da pesquisa

Ranking dos mais vendidos

bestsellers

category_id

parent_alias

category_results.product_results

Mais vendidos

Novidades

new-releases

category_id

parent_alias

category_results.product_results

Novidades

Explorar uma categoria

category

category_id

page, sort_by

category_results.product_results

Categoria

Ofertas de hoje

todays-deals

category_id

—

category_results.product_results (adiciona price_raw)

Ofertas de hoje

Catálogo do vendedor

seller_products

seller_id

page

search_results.product_results

Produtos do vendedor

Perfil do vendedor

seller_profile

seller_id

—

seller_profile (sem lista de produtos)

Perfil do vendedor

Avaliações (avaliações dos compradores sobre um vendedor)

seller_feedback

seller_id

page (5 por página)

seller_feedback (sem lista de produtos)

Avaliações

Os locais de resposta seguem os exemplos da documentação. Leia-os com cuidado. O analisador abaixo mostra como.

Há três detalhes que costumam confundir as pessoas. O valor das ofertas é todays-deals, com o hífen e o «s». A API aceita seller como um alias para seller_products, mas escreva o valor completo para que os seus registos permaneçam legíveis. E parent_alias aplica-se apenas aos best-sellers e aos lançamentos recentes, onde aponta para uma subcategoria.

Para críticas, utilize seller_feedback para recolher linhas de avaliações e product para a classificação e o número de avaliações de um ASIN.

Documentação: Tipos de pesquisa na Amazon

Como se extrai informações de um produto da Amazon pelo ASIN?

Envie type=product com product_id definido como o ASIN, o ID de dez caracteres que se segue a /dp/ em qualquer URL de produto da Amazon. O objeto product_results da resposta contém o título, o preço, a classificação, o total de avaliações, as categorias, as imagens e os atributos, além dos destaques do artigo, quando a Amazon os apresenta. Adicione amazon_domain para ler o mesmo ASIN noutro mercado da Amazon.

Em https://www.amazon.com/dp/B098RNZGNW, o ASIN é B098RNZGNW. O mesmo ASIN existe normalmente em vários mercados, pelo que um único ID, juntamente com amazon_domain permite-lhe comparar um produto entre países.

curl --get "https://ecom.webscrapingapi.com/v1" \
  --max-time 130 \
  --data-urlencode "engine=amazon" \
  --data-urlencode "api_key=$WSA_API_KEY" \
  --data-urlencode "type=product" \
  --data-urlencode "product_id=B098RNZGNW" \
  --data-urlencode "amazon_domain=amazon.co.uk"
import re
from amazon_client import amazon_get

url = "https://www.amazon.com/dp/B098RNZGNW"
asin = re.search(r"/dp/([A-Z0-9]{10})", url).group(1)

data, _ = amazon_get({"type": "product", "product_id": asin})
item = data.get("product_results", {})
rating = item.get("rating", {})
print(item.get("title"), item.get("price"), rating.get("rating"), rating.get("total_ratings"))

Exemplo de resposta (copiado da documentação da API, resumido):

{
  "product_results": {
    "product_id": "B098RNZGNW",
    "title": "Example Amazon Product",
    "item_highlights": "Foldable card table for board games, dining, and extra seating",
    "price": "$59.99",
    "rating": { "rating": "4.6 out of 5 stars", "total_ratings": 12438 },
    "categories": ["Electronics", "Headphones"],
    "images": ["https://m.media-amazon.com/images/I/example-1.jpg"],
    "attributes": { "Brand": "Example", "Color": "Black" }
  }
}

price é uma cadeia de caracteres de exibição, como "$59.99", por isso mantenha-a tal como está, com o domínio, e analise o número numa etapa separada. rating.rating é texto, enquanto rating.total_ratings é um número inteiro que pode ser comparado ao longo do tempo. É o indicador de avaliação ao nível do produto que se associa às avaliações dos compradores sobre o vendedor. item_highlights é omitido quando a Amazon não apresenta nenhum. Defina wait_for_offers=true quando os módulos de oferta forem relevantes e wait_for_video=true para módulos de vídeo.

A cobertura dos campos varia consoante a página. Os detalhes relativos à Buy Box, ao comerciante, às variações e à disponibilidade dependem do que cada página de produto apresenta; por isso, verifique uma amostra representativa dos seus próprios ASINs antes de conceber um esquema. É também nessa amostra que se inicia a monitorização do preço e da Buy Box.

Documentação: Produto da Amazon

Como se extrai os resultados de pesquisa da Amazon e se os pagina?

Envie type=search com q definido para a palavra-chave. Os produtos são apresentados em search_results.product_results, cada um com uma posição, ASIN, título, link, preço e classificação, e related_searches lista as sugestões da Amazon. Solicite page=2, 3 e seguintes para obter resultados mais detalhados e utilize sort_by ou filter_by=prime quando precisar da ordenação própria da Amazon ou do filtro Prime.

Os resultados de pesquisa da Amazon (a SERP da Amazon) mostram quem aparece para uma consulta e em que ordem. position é a classificação na lista devolvida para essa palavra-chave, domínio, página e momento. Guarde-a juntamente com q, amazon_domain, page, sort_by, e a hora de captura; caso contrário, as comparações de classificação deixam de fazer sentido.

curl --get "https://ecom.webscrapingapi.com/v1" \
  --max-time 130 \
  --data-urlencode "engine=amazon" \
  --data-urlencode "api_key=$WSA_API_KEY" \
  --data-urlencode "type=search" \
  --data-urlencode "q=memory card" \
  --data-urlencode "page=2" \
  --data-urlencode "filter_by=prime"

Para paginar, mantenha q, o domínio e as definições de ordenação iguais e aumente page. Cada página constitui um pedido independente, por isso limite o número de páginas por palavra-chave:

from datetime import datetime, timezone
from amazon_client import amazon_get

rows = []
for page in range(1, 4):  # page cap: three pages per keyword
    params = {"type": "search", "q": "memory card", "page": page, "amazon_domain": "amazon.com"}
    data, _ = amazon_get(params)
    found = data.get("search_results", {}).get("product_results", [])
    if not found:
        break
    captured_at = datetime.now(timezone.utc).isoformat()
    rows += [{**params, "captured_at": captured_at, "position": r.get("position"),
              "product_id": r.get("product_id"), "price_text": r.get("price")} for r in found]
print(len(rows), "rows")

Exemplo de resposta (copiado da documentação da API, resumido):

{
  "related_searches": [
    { "query": "micro sd card", "link": "https://www.amazon.com/s?k=micro+sd+card" }
  ]
}

sort_by aceita featured, price-asc-rank, price-desc-rank, review-rank, date-desc-ranke relevancerank. filter_by aceita prime e climate-friendly. Mantém ambos fixos ao longo das execuções se estiveres a acompanhar as posições. As páginas de pesquisa também podem incluir top_sponsored, video_sponsored, pagination, e amazon_pagination. Leia-as quando estiverem presentes e nunca as tome como certas.

Se estiver a acompanhar a posição de pesquisa ao longo do tempo, compare estas linhas com os resultados do Google para a mesma palavra-chave.

Documentação: Pesquisa na Amazon

Como se extrai os rankings dos mais vendidos da Amazon?

Envie «type=bestsellers» com um «category_id», que pode ser um alias, como «eletrónica», ou um ID numérico de nó, e adicione «parent_alias» para aceder a uma subcategoria. O auxiliar de categorias sem chave pesquisa ambos os valores a partir de uma palavra-chave. Os produtos classificados aparecem em category_results.product_results, cada um com a posição exibida pela Amazon, o ASIN, o título, o link e o preço.

Três passos para obter um ranking:

  1. Procure a categoria com o auxiliar de categorias, que não requer chave de API.
  2. Passe o seu category_id, além de parent_alias para uma subcategoria.
  3. Leia category_results.product_results.
curl "https://amazon-helpers.webscrapingapi.com/categories?q=electronics&limit=3"

Resposta do auxiliar (truncada):

[
  { "title": "Amazon Launchpad Top Electronics", "href": "/gp/new-releases/boost/23602499011", "parent_alias": "boost", "category_id": "23602499011" },
  { "title": "Electronics", "href": "/gp/new-releases/boost/21179674011", "parent_alias": "boost", "category_id": "21179674011" },
  { "title": "Electronics", "href": "/gp/new-releases/automotive/3248690011", "parent_alias": "automotive", "category_id": "3248690011" }
]

Leia os campos do helper por chave, uma vez que os nomes podem diferir da tabela da documentação. Aliases de nível superior, como electronics funcionam sem necessidade de pesquisa:

curl --get "https://ecom.webscrapingapi.com/v1" \
  --max-time 130 \
  --data-urlencode "engine=amazon" \
  --data-urlencode "api_key=$WSA_API_KEY" \
  --data-urlencode "type=bestsellers" \
  --data-urlencode "category_id=electronics"

Resposta de exemplo (copiada da documentação da API, resumida):

{
  "category_results": {
    "product_results": [
      { "position": 1, "product_id": "B08C1W5N87", "title": "Fire TV Stick with Alexa Voice Remote",
        "link": "/fire-tv-stick-with-3rd-gen-alexa-voice-remote/dp/B08C1W5N87", "price": "$19.99",
        "rating": { "rating": "4.7 out of 5 stars", "total_ratings": 141438 } }
    ]
  }
}

position é a classificação apresentada pela Amazon para essa categoria naquele momento; por isso, guarda a hora da captura e compara as execuções realizadas no mesmo horário. Tem em atenção o link: anteponha o domínio a esses caminhos antes de os armazenar, tal como absolute_link() é o que acontece na secção do analisador.

Documentação: Mais vendidos da Amazon

Como se obtêm os novos lançamentos da Amazon para uma categoria?

Envie type=new-releases com um category_id, como «fashion», e adicione parent_alias para uma subcategoria, exatamente como acontece com os mais vendidos. A resposta lista os novos lançamentos em destaque da Amazon para essa categoria em category_results.product_results, com posição, ASIN, título, link e preço. Execute-a periodicamente para ver quais os lançamentos que entram e saem da lista.

curl --get "https://ecom.webscrapingapi.com/v1" \
  --max-time 130 \
  --data-urlencode "engine=amazon" \
  --data-urlencode "api_key=$WSA_API_KEY" \
  --data-urlencode "type=new-releases" \
  --data-urlencode "category_id=fashion"

Exemplo de resposta (copiado da documentação da API; o ASIN é um espaço reservado da documentação):

{
  "category_results": {
    "product_results": [
      { "position": 1, "product_id": "B09EXAMPLE", "title": "New release product",
        "link": "https://www.amazon.com/dp/B09EXAMPLE", "price": "$29.99" }
    ]
  }
}

Encontre os IDs das subcategorias e os respetivos parent_alias com o auxiliar de categorias da secção dos mais vendidos. Utilize este pedido para acompanhar os lançamentos: uma categoria e um mercado por execução, sempre com a mesma programação.

Documentação: Novos lançamentos da Amazon

Como se extrai uma lista de categorias da Amazon?

Envie type=category com um category_id, que pode ser um alias, como amazon-devices, ou um ID numérico do nó. Adicione page para obter resultados mais detalhados e sort_by para alterar a ordem. Os produtos são apresentados em `category_results.product_results` com posição, ASIN, título, link, preço e classificação, para que possa acompanhar um nó de navegação completo em vez de apenas uma palavra-chave.

curl --get "https://ecom.webscrapingapi.com/v1" \
  --max-time 130 \
  --data-urlencode "engine=amazon" \
  --data-urlencode "api_key=$WSA_API_KEY" \
  --data-urlencode "type=category" \
  --data-urlencode "category_id=amazon-devices" \
  --data-urlencode "page=2"

Exemplo de resposta (copiado da documentação da API, resumido):

{
  "category_results": {
    "product_results": [
      { "position": 1, "product_id": "B08C1W5N87", "title": "Fire TV Stick with Alexa Voice Remote",
        "link": "/fire-tv-stick-with-3rd-gen-alexa-voice-remote/dp/B08C1W5N87", "price": "$19.99",
        "rating": { "rating": "4.7 out of 5 stars", "total_ratings": 141438 } }
    ]
  }
}

Um pedido de categoria devolve a lista de navegação na ordem escolhida pela Amazon, enquanto «bestsellers» devolve a lista de best-sellers classificados. page e sort_by aplicam-se aqui, mas parent_alias não se aplica. Os links podem ser relativos, como nos mais vendidos.

Documentação: Categoria da Amazon

Como se extraiem as ofertas de hoje da Amazon?

Envie type=todays-deals, e não deals, com um category_id como, por exemplo, 15684181. Os produtos em promoção aparecem em category_results.product_results, e cada linha contém o preço, o preço atual da promoção e o price_raw, o preço antes da promoção. Guarde ambos com a hora da captura, porque as promoções mudam ao longo do dia e um pedido posterior pode devolver uma lista diferente.

curl --get "https://ecom.webscrapingapi.com/v1" \
  --max-time 130 \
  --data-urlencode "engine=amazon" \
  --data-urlencode "api_key=$WSA_API_KEY" \
  --data-urlencode "type=todays-deals" \
  --data-urlencode "category_id=15684181"

Exemplo de resposta (copiado da documentação da API, resumido):

{
  "category_results": {
    "product_results": [
      { "position": 1, "product_id": "B081T7N948", "title": "Cleaning Gel for Car",
        "link": "/Cleaning-Universal-Detailing-Automotive-Interior/dp/B081T7N948",
        "price": "$5.94", "currency": "$", "price_raw": "$9.99" }
    ]
  }
}

Calcule o desconto apenas sobre os números analisados, depois de remover o símbolo da moeda desse domínio, e guarde também as cadeias de caracteres em bruto:

deal, before = float(row["price"].lstrip("$")), float(row["price_raw"].lstrip("$"))
discount_pct = round((before - deal) / before * 100, 1)  # 40.5 for the sample row

Os links das promoções podem ser relativos, por isso processe-os através de absolute_link().

Documentação: Ofertas da Amazon

Como se listam os produtos que um vendedor oferece na Amazon?

Envie type=seller_products com o ID do vendedor em seller_id. A resposta lista os produtos da loja desse vendedor em search_results.product_results, com posição, ASIN, título, link e preço, no mesmo formato que search. Adicione «page» para obter mais resultados. O alias mais curto «seller» também funciona, mas escreva «seller_products» para que o seu código se mantenha legível.

Utilize o ID do vendedor indicado no URL da loja do vendedor.

curl --get "https://ecom.webscrapingapi.com/v1" \
  --max-time 130 \
  --data-urlencode "engine=amazon" \
  --data-urlencode "api_key=$WSA_API_KEY" \
  --data-urlencode "type=seller_products" \
  --data-urlencode "seller_id=AAZRLVTNON75Z"

Exemplo de resposta (copiado da documentação da API, resumido):

{
  "search_results": {
    "product_results": [
      { "position": 1, "product_id": "B01NGTV4J5", "title": "Cascade Platinum Dishwasher Pods",
        "link": "https://www.amazon.com/dp/B01NGTV4J5", "price": "$38.88", "currency": "$" }
    ]
  }
}

Como as linhas correspondem aos resultados da pesquisa, o mesmo código de análise e armazenamento funciona aqui. Armazene-as por execução para ver quais ASINs um comerciante lista e a que preços são apresentados.

Documentação: Produtos de vendedores da Amazon

Como se obtém o perfil e a classificação de um vendedor da Amazon?

Envie type=seller_profile com o seller_id. O objeto seller_profile devolve seller_details com o nome da loja, o link da loja, a classificação por estrelas, o total de avaliações e a percentagem de avaliações positivas, além de uma pequena lista de comentários recentes e um resumo dos comentários com as percentagens positivas, neutras e negativas. É uma solicitação por vendedor, sem lista de produtos nem paginação.

curl --get "https://ecom.webscrapingapi.com/v1" \
  --max-time 130 \
  --data-urlencode "engine=amazon" \
  --data-urlencode "api_key=$WSA_API_KEY" \
  --data-urlencode "type=seller_profile" \
  --data-urlencode "seller_id=AAZRLVTNON75Z"

Exemplo de resposta (copiado da documentação da API, resumido):

{
  "seller_profile": {
    "seller_details": { "name": "Triplenet Pricing INC", "store_link": "https://www.amazon.com/s?me=AAZRLVTNON75Z",
      "rating": 4, "ratings_total": 4078, "ratings_positive_percentage": 74 },
    "feedback": [ { "rating": 5, "body": "Great service", "rater": "By Sarah M. on July 24, 2023." } ],
    "feedback_summary": [ { "positive_percent": 75, "neutral_percent": 1, "negative_percent": 24, "count": 366 } ]
  }
}

Utilize um perfil para avaliar os vendedores terceiros que competem pela «Buy Box» ou pela loja ratings_total e ratings_positive_percentage por execução para acompanhar a evolução da posição de um vendedor. A feedback lista aqui apresentada é uma pequena amostra recente. Para cada linha de avaliação, percorra a solicitação de feedback do vendedor abaixo.

Documentação: Perfil do vendedor na Amazon

Como se extraem as avaliações da Amazon através do pedido de feedback do vendedor?

Envie type=seller_feedback com um seller_id. Trata-se do pedido de avaliações da API da Amazon: cada linha corresponde a uma avaliação de um comprador sobre esse vendedor, incluindo o autor da avaliação, a classificação por estrelas, o texto da avaliação, a data e se o vendedor respondeu. Os resultados são apresentados em grupos de cinco por página, por isso siga pagination.has_next_page e next_page até atingir o limite de páginas que definiu.

curl --get "https://ecom.webscrapingapi.com/v1" \
  --max-time 130 \
  --data-urlencode "engine=amazon" \
  --data-urlencode "api_key=$WSA_API_KEY" \
  --data-urlencode "type=seller_feedback" \
  --data-urlencode "seller_id=AAZRLVTNON75Z" \
  --data-urlencode "page=2"

Exemplo de resposta (copiado da documentação da API, resumido):

{
  "seller_feedback": [
    { "rater": "Sarah M.", "rating": 5, "has_response": false, "body": "Great service",
      "date": { "raw": "July 24, 2023", "utc": "2023-07-24T04:00:00.000Z" }, "position": 1 }
  ],
  "pagination": { "current_page": 1, "has_next_page": true, "next_page": 2 }
}

Cada página constitui uma solicitação independente, pelo que um histórico de avaliações extenso acumula várias solicitações. Este paginador pára quando não há mais páginas seguintes ou quando atinge max_pages:

# seller_feedback_pages.py
from amazon_client import amazon_get


def all_feedback(seller_id, max_pages=3):
    page, rows = 1, []
    while page and page <= max_pages:
        data, _ = amazon_get({"type": "seller_feedback", "seller_id": seller_id, "page": page})
        rows += data.get("seller_feedback", [])
        pagination = data.get("pagination", {})
        page = pagination.get("next_page") if pagination.get("has_next_page") else None
    return rows


reviews = all_feedback("AAZRLVTNON75Z")
print(len(reviews), "reviews")

Store seller_id e date.utc em todas as avaliações e elimina duplicados entre execuções. date.raw segue o formato de apresentação da Amazon. Combine isto com os dados do produto: type=product fornece a classificação de cada ASIN e o número total de avaliações; assim, em conjunto, as duas solicitações abrangem o volume de avaliações, as classificações por estrelas e o texto das avaliações dos vendedores.

Documentação: Feedback dos vendedores da Amazon

Como se direciona para outro domínio da Amazon, país ou código postal?

Defina `amazon_domain` para um dos vinte mercados suportados, como `amazon.de` ou `amazon.co.jp`. O valor predefinido é `amazon.com`. Adicione `delivery_location` com um código de país, como `de` ou `gb`, para definir o país de entrega predefinido, ou `zip_code` para uma morada local nos EUA. Utilize hl e gl para o idioma e o país, e registe todas as configurações com os resultados.

O preço, a disponibilidade e as promessas de entrega na Amazon dependem do mercado e da morada de entrega, pelo que duas chamadas com configurações diferentes não são comparáveis. Defina uma pequena grelha de mercado (cada ASIN ou palavra-chave × cada domínio × cada local de entrega) e mantenha-a igual entre as execuções.

Região

Domínios

Américas

amazon.com, amazon.ca, amazon.com.mx, amazon.com.br

Europa

amazon.co.uk, amazon.de, amazon.fr, amazon.it, amazon.es, amazon.nl, amazon.pl, amazon.se, amazon.com.tr

Médio Oriente e África

amazon.ae, amazon.sa, amazon.eg

Ásia-Pacífico

amazon.co.jp, amazon.in, amazon.sg, amazon.com.au

Todos estes parâmetros gerais são opcionais:

Parâmetro

Função

Valores

amazon_domain

Qual mercado da Amazon deve ser lido

Um dos 20 domínios acima; valor predefinido: amazon.com

delivery_location

País de entrega predefinido

us, de, gb, ca, fr, jp, cn, au, es, br, in, mx

zip_code

Contexto do endereço de entrega local

Um código postal

hl / gl

Idioma / país

Códigos de idioma e país

page

Página de resultados

Número inteiro

sort_by

Ordenar resultados da pesquisa ou da categoria

em destaque, classificação por preço crescente, classificação por preço decrescente, classificação por avaliação, classificação por data decrescente, classificação por relevância

filter_by

Filtrar resultados

prime, amigo do ambiente

scroll_to_bottom

Deslocamento de página completa antes da extração

verdadeiro / falso (falso é mais rápido)

wait_bottom_carousel

Aguardar pelo carrossel inferior

verdadeiro / falso (falso é mais rápido)

lazy_loading

Espera adicional após o carregamento da página

Milissegundos

wait_for_offers / wait_for_video

Aguardar pelos módulos de ofertas ou vídeos nas páginas de produtos

verdadeiro / falso

delivery_location aceita apenas os doze códigos listados, pelo que nem todos os domínios têm um valor correspondente. Não há it ou nl, por exemplo. Quando não precisar de módulos na parte inferior da página, defina scroll_to_bottom=false e wait_bottom_carousel=false para obter respostas mais rápidas. Utilize lazy_loading quando uma página precisar de mais tempo após o carregamento.

No Node.js, as definições de mercado correspondem a mais chaves no ficheiro URLSearchParams:

const params = new URLSearchParams({
  engine: "amazon",
  api_key: process.env.WSA_API_KEY,
  type: "search",
  q: "memory card",
  amazon_domain: "amazon.de",
  delivery_location: "de",
});

Documentação: Domínios suportados

Como se lê e armazena a resposta JSON?

Comece por «search_parameters», que apresenta a sua solicitação e o URL da Amazon obtido, e por «search_information». Em seguida, leia as linhas de «search_results», «category_results», do objeto único «product_results», «seller_profile» ou «seller_feedback», dependendo do tipo. Trate todos os outros módulos como opcionais, mantenha as cadeias de caracteres de preço em formato bruto com o respetivo domínio e armazene cada linha com as suas definições de pedido.

As descrições e exemplos da documentação, por vezes, colocam os produtos sob chaves diferentes. O texto da página de categorias diz product_results, enquanto o exemplo aninha isso em category_results, e o texto da página de produtos do vendedor denomina seller_results, enquanto o exemplo utiliza search_results. Por isso, o analisador verifica todas as localizações documentadas e devolve uma lista vazia em vez de falhar. Adicione-o a amazon_client.py:

def product_rows(data):
    """Return the product list wherever this request type puts it."""
    for container in ("search_results", "category_results"):
        rows = (data.get(container) or {}).get("product_results")
        if isinstance(rows, list):
            return rows
    single = data.get("product_results")
    return [single] if isinstance(single, dict) else []


def absolute_link(link, amazon_domain="amazon.com"):
    """Category-style responses can return relative links such as /Item/dp/ASIN."""
    if not link or link.startswith("http"):
        return link
    return f"https://www.{amazon_domain}{link}"

product_rows() retorna linhas para todos os sete tipos que contêm produtos. Leia seller_profile e seller_feedback pelas suas próprias chaves, tal como nas respetivas secções. Em seguida, simplifique cada produto numa única linha de armazenamento:

# store.py
from datetime import datetime, timezone
from amazon_client import absolute_link, product_rows


def to_records(data, request):
    """One flat row per product, with the request settings that produced it."""
    captured_at = datetime.now(timezone.utc).isoformat()
    domain = request.get("amazon_domain", "amazon.com")
    amazon_url = (data.get("search_parameters") or {}).get("amazon_url")
    for row in product_rows(data):
        rating = row.get("rating") or {}
        yield {
            "captured_at": captured_at,
            "type": request["type"],
            "input": request.get("q") or request.get("category_id")
                     or request.get("seller_id") or request.get("product_id"),
            "amazon_domain": domain,
            "delivery_location": request.get("delivery_location"),
            "page": request.get("page", 1),
            "position": row.get("position"),
            "product_id": row.get("product_id"),
            "title": row.get("title"),
            "price_text": row.get("price"),
            "rating_text": rating.get("rating"),
            "total_ratings": rating.get("total_ratings"),
            "link": absolute_link(row.get("link"), domain),
            "amazon_url": amazon_url,
        }

Guarde também a resposta em bruto, para que possa reprocessá-la quando adicionar campos. Distinga um pedido que falhou (um erro HTTP) de um que foi bem-sucedido com um módulo ausente (uma lista vazia). O segundo é uma observação, não um erro. Para mais padrões, consulte a análise de respostas JSON em Python.

A página de preços apresenta as saídas em JSON, CSV e HTML em todos os planos. A documentação da Amazon descreve respostas JSON, pelo que este guia utiliza JSON ao longo de todo o texto.

Como deve o seu código lidar com erros, novas tentativas e utilização de créditos?

Não repita tentativas em caso de erros 401 ou de validação. Corrija a chave, a subscrição ou os parâmetros. Refaça as tentativas para os códigos de erro 429, 500, 502 e 503 algumas vezes com recuo exponencial e jitter, e reduza a simultaneidade no caso do 429. Um código 422 significa que a Amazon devolveu um erro, um desafio ou um tempo limite esgotado; por isso, tente novamente apenas uma vez, quando a falha parecer temporária.

Status

Corpo ou forma

Significado

Ação

401

Access denied. No key api_key provided.

Nenhuma chave enviada

Corrija a configuração; não tente novamente

401

Access denied. Invalid api_key provided. ou Authentication failure: …

Chave inválida ou a chave não tem autorização para aceder à API da Amazon

Verifique a chave e a subscrição; não tente novamente

Erro de validação

Parameter '<name>' not allowed. e similares

Parâmetro incorreto ou em falta para engine=amazon

Corrija o pedido; não tente novamente

422

error_type: "website"

A Amazon devolveu um erro, um desafio, um corpo inválido ou um tempo limite esgotado

Tente novamente uma vez, se for um problema passageiro

429

{"error":"max_concurrent_connections"}

Limite de simultaneidade atingido

Reduzir a simultaneidade, aguardar e tentar novamente

500 / 503

Internal Server Error / other_failure

Falha transitória da API

Reintente algumas vezes com recuo variável

Um pedido sem chave devolve este corpo com o código de estado HTTP 401:

{ "error": "Access denied. No key `api_key` provided." }

Outras mensagens de validação incluem Parameter '<name>' is required., must be a boolean, must be in range, e cannot be used with. Significam que a própria solicitação está incorreta, pelo que repetir a tentativa não altera nada. Se uma /v1 pedido responder «Este ponto de extremidade está obsoleto. Por favor, utilize /v2.», a sua chave não está subscrita na API da Amazon. Subscreva no painel de controlo em vez de mudar de ponto de extremidade.

amazon_get() implementa esta política. Reitera tentativas para respostas HTTP 429 e 5xx com recuo exponencial e jitter aleatório, respeita um cabeçalho numérico «Retry-After» quando este estiver presente, reitera uma tentativa para um 422 uma vez e gera uma exceção em todos os outros casos, com a chave ocultada. Em caso de erros 429 repetidos, execute também menos trabalhadores em paralelo.

Registe dois cabeçalhos em cada chamada: Searchdata-Call-Credit-Usage (créditos cobrados por esta chamada) e Searchdata-Current-Credit-Usage (utilização atual da sua conta). Uma semana desse registo mostra quais os tipos e mercados que utilizam a sua quota.

Documentação: Erros e cabeçalhos

Quanto custa a API do Amazon Scraper?

A partir de outubro de 2026, a versão de avaliação custa 0 $ por 100 pedidos à Amazon. Os planos pagos são mensais: o Starter custa 59 $ por 10 000 pedidos, o Grow 375 $ por 250 000, o Business 1 000 $ por 1 000 000 e o Pro 2 200 $ por 2 500 000. Todos os planos abrangem todos os domínios da Amazon, APIs de produtos e avaliações, resultados de pesquisa e categorias, e best-sellers.

Plano

Preço

Pedidos na Amazon

Custo efetivo por 1 000

Versão de avaliação

0 $

100

—

Inicial

59 $/mês

10 000

5,90

Grow

375 $/mês

250 000

1,50

Empresa

1 000 $/mês

1 000 000

1,00

Pro

2 200 $/mês

2 500 000

0,88

Todos os planos incluem todos os domínios da Amazon, APIs de produtos e avaliações, resultados de pesquisa e por categoria, a API dos Mais Vendidos, saída em JSON, CSV e HTML, e processamento em massa. Os preços estão em USD. Neste guia, as APIs de produtos e avaliações são as product e seller_feedback .

Escolha um plano com base nos seus dados, não em suposições:

solicitações por mês = dados de entrada (ASINs, palavras-chave, categorias, vendedores) × domínios × locais de entrega × páginas por dado de entrada × execuções por mês, mais uma margem para testes e novas tentativas

Por exemplo, 400 ASINs × 2 domínios × 1 página × 4 execuções semanais resultam em 3 200 pedidos, o que se enquadra no plano Starter. Acrescente 50 palavras-chave × 2 domínios × 3 páginas × 30 execuções diárias, ou seja, mais 9 000, e o total de 12 200 ultrapassa o plano Starter, pelo que o plano Grow é o seguinte. Os preços e as quotas variam, pelo que a página de preços é a fonte de informação oficial. Ainda está a escolher um fornecedor? Consulte o nosso guia para comparar APIs de scraping da Amazon.

O que é que a API da Amazon não faz e quando é que outra opção é melhor?

A API da Amazon abrange os nove tipos de páginas indicados na sua documentação de referência, e apenas esses. Não há tarefas assíncronas da Amazon, a cobertura de campos varia consoante a página e cada resultado descreve um domínio, uma localização e um momento. Para outras páginas, outros mercados ou conjuntos de dados pré-criados, utilize a API Scraper, outra fonte da Data API ou um feed gerido.

  • Páginas fora dos nove tipos. Solicite uma amostra para essas páginas ou recupere-as em formato HTML. Veja como utilizar a API Scraper.
  • Prefere criar o seu próprio scraper. Para executar e manter o scraper por conta própria, siga um guia prático de criação de um scraper da Amazon em Python.
  • Quer registos, não pedidos. Para dados da Amazon já preparados e recorrentes, consulte o conjunto de dados de produtos da Amazon.
  • Precisa de outro marketplace. A Data API também abrange outros retalhistas, como os dados de produtos do Walmart.
  • Não há tarefas assíncronas para a Amazon. Todas as chamadas são síncronas, por isso execute a sua própria fila de tarefas com a política de repetição de tentativas acima.
  • Os campos variam consoante a página. Verifique uma amostra representativa antes de se comprometer com um esquema.
  • A utilização está sujeita a regras. Recolha apenas páginas públicas, em conformidade com o Acordo de Serviço da WebScrapingAPI e com os requisitos que se aplicam a si.

Perguntas frequentes

Existe uma versão de avaliação gratuita da API de scraping da Amazon?

Sim. A partir de outubro de 2026, o plano de avaliação da API da Amazon da WebScrapingAPI custa 0 $ e inclui 100 pedidos à Amazon, o suficiente para testar pedidos de produtos, pesquisas, best-sellers e vendedores com os seus próprios dados. Crie uma conta, subscreva a API da Amazon no painel de controlo e guarde a chave numa variável de ambiente enquanto faz a avaliação.

O que é um ASIN e onde o posso encontrar?

Um ASIN é o identificador de produto de dez caracteres da Amazon, e a API da Amazon utiliza-o como product_id. Encontrá-lo-á no URL de um produto após /dp/, ou na secção «Informações do produto» ou «Informações adicionais» da página do produto. O mesmo ASIN pode apresentar preços e disponibilidade diferentes em domínios distintos da Amazon.

Como posso extrair os rankings dos mais vendidos da Amazon?

Envie type=bestsellers com um category_id, como «eletrónica», e adicione parent_alias quando pretender uma subcategoria. O auxiliar de categorias sem chave encontra ambos os valores a partir de uma palavra-chave. Os resultados são apresentados em category_results.product_results com a posição exibida pela Amazon, o ASIN, o título, o link, o preço e a classificação; por isso, guarde a hora da captura em cada linha.

Que mercados da Amazon é que a API suporta?

Suporta vinte domínios da Amazon: Estados Unidos, Canadá, México, Brasil, Reino Unido, Alemanha, França, Itália, Espanha, Países Baixos, Polónia, Suécia, Turquia, Emirados Árabes Unidos, Arábia Saudita, Egito, Japão, Índia, Singapura e Austrália. Defina `amazon_domain` para selecionar um e utilize `delivery_location` ou `zip_code` quando o contexto de entrega alterar o que a Amazon apresenta.

Posso chamar a API da Amazon a partir do JavaScript do navegador?

Não o faça. Um pedido feito a partir do navegador exporia a sua chave de API a qualquer pessoa que abrisse as ferramentas de programador, e a chave controla a sua cota do plano. Chame a API a partir de um servidor, de uma função sem servidor ou de uma tarefa agendada, leia a chave a partir de uma variável de ambiente ou de um gestor de segredos e envie apenas os resultados analisados para o front-end.

Como posso percorrer as páginas dos resultados de pesquisa da Amazon?

Adicione page=2, page=3 e assim sucessivamente a uma solicitação type=search com as mesmas configurações de q, domínio e ordenação. Cada página é uma solicitação separada que conta para a sua cota, por isso defina um limite de páginas por palavra-chave. Armazene o número da página em cada linha para que possa reconstruir posteriormente a classificação completa para essa palavra-chave.

A API da Amazon permite extrair avaliações?

Sim. Envie «type=seller_feedback» com um «seller_id» para recolher avaliações de compradores sobre um vendedor, cinco por página, cada uma com o autor da avaliação, classificação por estrelas, texto da avaliação, data e se o vendedor respondeu. Para sinais de avaliação ao nível do produto, «type=product» devolve a classificação de cada ASIN e o número total de avaliações. Siga pagination.has_next_page para ler todas as páginas.

Por que razão a minha solicitação devolve a mensagem «Parâmetro não permitido»?

A API valida todos os parâmetros em relação ao motor da Amazon e rejeita os nomes que não aceita. As causas mais comuns são um nome de parâmetro com erros ortográficos ou de maiúsculas, um parâmetro de outro motor ou um símbolo «&» não codificado na sua palavra-chave, o que a divide num novo parâmetro. Corrija a solicitação em vez de tentar novamente.

Como posso saber quantos créditos uma solicitação utilizou?

Consulte o cabeçalho de resposta «Searchdata-Call-Credit-Usage», que indica os créditos cobrados por essa chamada, e «Searchdata-Current-Credit-Usage», que indica a utilização atual da sua conta. Registe ambos com o tipo de pedido, a entrada e o domínio. Ao longo de uma semana, esse registo mostra quais os tipos de pedidos e mercados que consomem a sua quota e se o seu plano ainda se adequa às suas necessidades.

Posso obter dados da Amazon sem escrever código?

Sim, se um feed pré-definido se adequar às suas necessidades. A WebScrapingAPI pode fornecer registos da Amazon como um conjunto de dados ou uma coleção gerida de forma programada, depois de analisar dados de amostra para as suas páginas, campos e mercados. A API é adequada para equipas que pretendem escolher elas próprias as entradas e o calendário, enquanto um feed gerido é adequado para analistas que apenas necessitam de ficheiros recorrentes.

Comece com 100 pedidos gratuitos à Amazon

A API Amazon Scraper devolve páginas de produtos, pesquisa, categorias, best-sellers, promoções, vendedores e avaliações de vendedores de 20 mercados da Amazon como JSON estruturado, com a manutenção do analisador tratada por nós. Quando souber os seus ASINs, palavras-chave, mercados e calendário de atualização, compare os planos da API da Amazon e escolha a cota que melhor se adequa às suas necessidades.

Sobre o autor

Robert Sfichi, Desenvolvedor Full-Stack @ WebScrapingAPI

Robert Sfichi

Desenvolvedor Full-Stack

Robert Sfichi é membro da equipa da WebScrapingAPI, contribuindo para o produto e ajudando a criar soluções fiáveis que apoiam a plataforma e os seus utilizadores.

Web Scraping com AWS Lambda: Guia para Python e Java 2026
Guias

Web Scraping com AWS Lambda: Guia para Python e Java 2026

TL;DR: Resumo: A extração de dados da Web com o AWS Lambda funciona melhor quando cada invocação é curta, delimitada e pode ser repetida de forma independente. Comece com HTTP direto, AWS SAM e S3 e, só depois, adicione SQS, contentores, renderização no navegador, proxies ou uma camada de recuperação gerida, apenas quando a carga de trabalho demonstrar que precisa deles.

Suciu Dan32 min read
Ler artigo
Como utilizar o GoSpider: rastrear, limpar URLs e extrair dados
Guias

Como utilizar o GoSpider: rastrear, limpar URLs e extrair dados

TL;DR: Resumo: O GoSpider é um rastreador de linha de comandos destinado a descobrir URLs, não um extrator completo de dados estruturados. Este guia sobre como utilizar o GoSpider mostra como realizar um rastreio limitado, gerir resultados de forma organizada, fazer a transferência de dados do Colly para CSV e seguir um percurso de diagnóstico para respostas 403 ou páginas que exijam renderização em JavaScript.

Suciu Dan23 min read
Ler artigo
Como fazer o Scrape Redfin: Guia Python para Dados de Propriedade
Guias

Como fazer o Scrape Redfin: Guia Python para Dados de Propriedade

TL;DR: A Redfin expõe pontos de extremidade de API ocultos que retornam JSON estruturado para listagens de propriedades, tornando possível ignorar totalmente a análise HTML frágil. Este guia orienta-o na construção de um scraper Python que extrai dados de aluguer e venda, pesquisa por localização, monitoriza novas listagens através de sitemaps XML e exporta resultados limpos para CSV ou JSON.

Suciu Dan14 min read
Ler artigo

Comece a construir

Pronto para expandir a sua recolha de dados?

Junte-se a mais de 2.000 empresas que utilizam a WebScrapingAPI para extrair dados da Web à escala empresarial, sem quaisquer custos de infraestrutura.