
Saltar para o conteúdo
Comece grátis
Voltar ao blogue

Extracção automatizada de dados da Web: crie tarefas que possa recuperar

Andrei OgiolanÚltima atualização em 17 min read
Extracção automatizada de dados da Web: crie tarefas que possa recuperar
Resumo: A extração automatizada de dados da Web requer mais do que um temporizador associado a um script. Separe o agendamento, a recolha, a validação e a entrega; atribua uma identidade a cada execução; e conceba tentativas de repetição de forma a que as falhas não dupliquem registos nem eliminem a cobertura sem aviso prévio. Avalie os dados utilizáveis e a atualidade, e não apenas os pedidos bem-sucedidos.

Um coletor agendado termina sem apresentar exceções, mas a sua exportação contém os dados de ontem e metade dos produtos esperados. O script foi executado. A tarefa de dados falhou. Essa distinção deve moldar o sistema antes de adicionar mais fontes ou aumentar a simultaneidade.

A extração automatizada da Web consiste na recolha e transformação repetidas de dados de sites através de um fluxo de trabalho definido e não supervisionado. Uma tarefa de produção também precisa de uma forma de reconhecer resultados incompletos, recuperar o trabalho interrompido e explicar o que foi entregue. Caso contrário, a automatização apenas faz com que a mesma incerteza se repita de forma programada.

Para os programadores, o ponto de partida mais útil é um contrato de execução: quais as fontes abrangidas, o que conta como uma observação válida, para onde vão os resultados e quais as falhas que devem interromper a entrega. Um coletor com esses limites é mais fácil de operar do que um rastreador maior cujo único sinal de sucesso é um código de saída.

Este guia percorre essa arquitetura utilizando como exemplo uma recolha recorrente de catálogos. Os padrões também se aplicam a diretórios públicos, listas de empregos e conjuntos de dados de monitorização de alterações. A ênfase está na semântica de agendamento e recuperação, não numa promessa de que qualquer site possa ser rastreado automaticamente ou de que a automação elimine a necessidade de revisão.
Definir o contrato de execução para a extração automatizada da Web

Comece pela saída que alguém irá consumir. Uma tarefa de catálogo pode fornecer uma observação por produto de origem e região, com o preço observado, a moeda, a disponibilidade, o URL de origem e a hora da recolha. Escreva essa definição antes de selecionar o agendador ou decidir quantos trabalhadores lançar.

Separe os campos obrigatórios dos campos opcionais úteis. A falta de um identificador de produto pode tornar um registo inutilizável; a falta de uma imagem secundária pode não o tornar. Defina explicitamente a resposta a cada falha. Sem essa distinção, um programador pode eliminar a linha, enquanto outro a preenche com uma cadeia vazia, e o conjunto de dados resultante altera o seu significado entre versões.

Utilize um registo de execução para descrever a tarefa independentemente das linhas individuais. Segue-se um esquema ilustrativo, não um formato de saída exigido por uma plataforma específica:

{
  "run_id": "catalog-eu-2026-09-10-01",
  "source_set_version": "catalog-sources-v3",
  "parser_version": "catalog-parser-v7",
  "scheduled_for": "2026-09-10T06:00:00Z",
  "started_at": "2026-09-10T06:02:00Z",
  "status": "collecting",
  "counts": {
    "requested": 0,
    "fetched": 0,
    "valid": 0,
    "rejected": 0,
    "delivered": 0
  }
}

A hora agendada e a hora de início efetiva são separadas porque um trabalho atrasado não é o mesmo que uma observação pontual. Inclua também as horas de observação efetivas nos registos. Atribuir a cada linha o carimbo de data/hora da agenda implicaria que a fonte tivesse sido observada antes de o ter sido efetivamente.

Mantenha o conjunto de fontes versionado. Adicionar um retalhista ou remover uma categoria com falhas altera a cobertura, mesmo quando o analisador permanece idêntico. Um analista a jusante deve ser capaz de distinguir uma amostra de mercado mais ampla de uma alteração no próprio mercado.

Por fim, designe um responsável e defina uma política de aceitação. Decida se uma execução parcial pode ser entregue com um indicador de integridade ou se deve aguardar a recuperação. Nenhuma das políticas é universalmente correta. O requisito é que os utilizadores consigam identificar qual delas foi aplicada.

Separe o temporizador, o rastreador e o agente de entrega

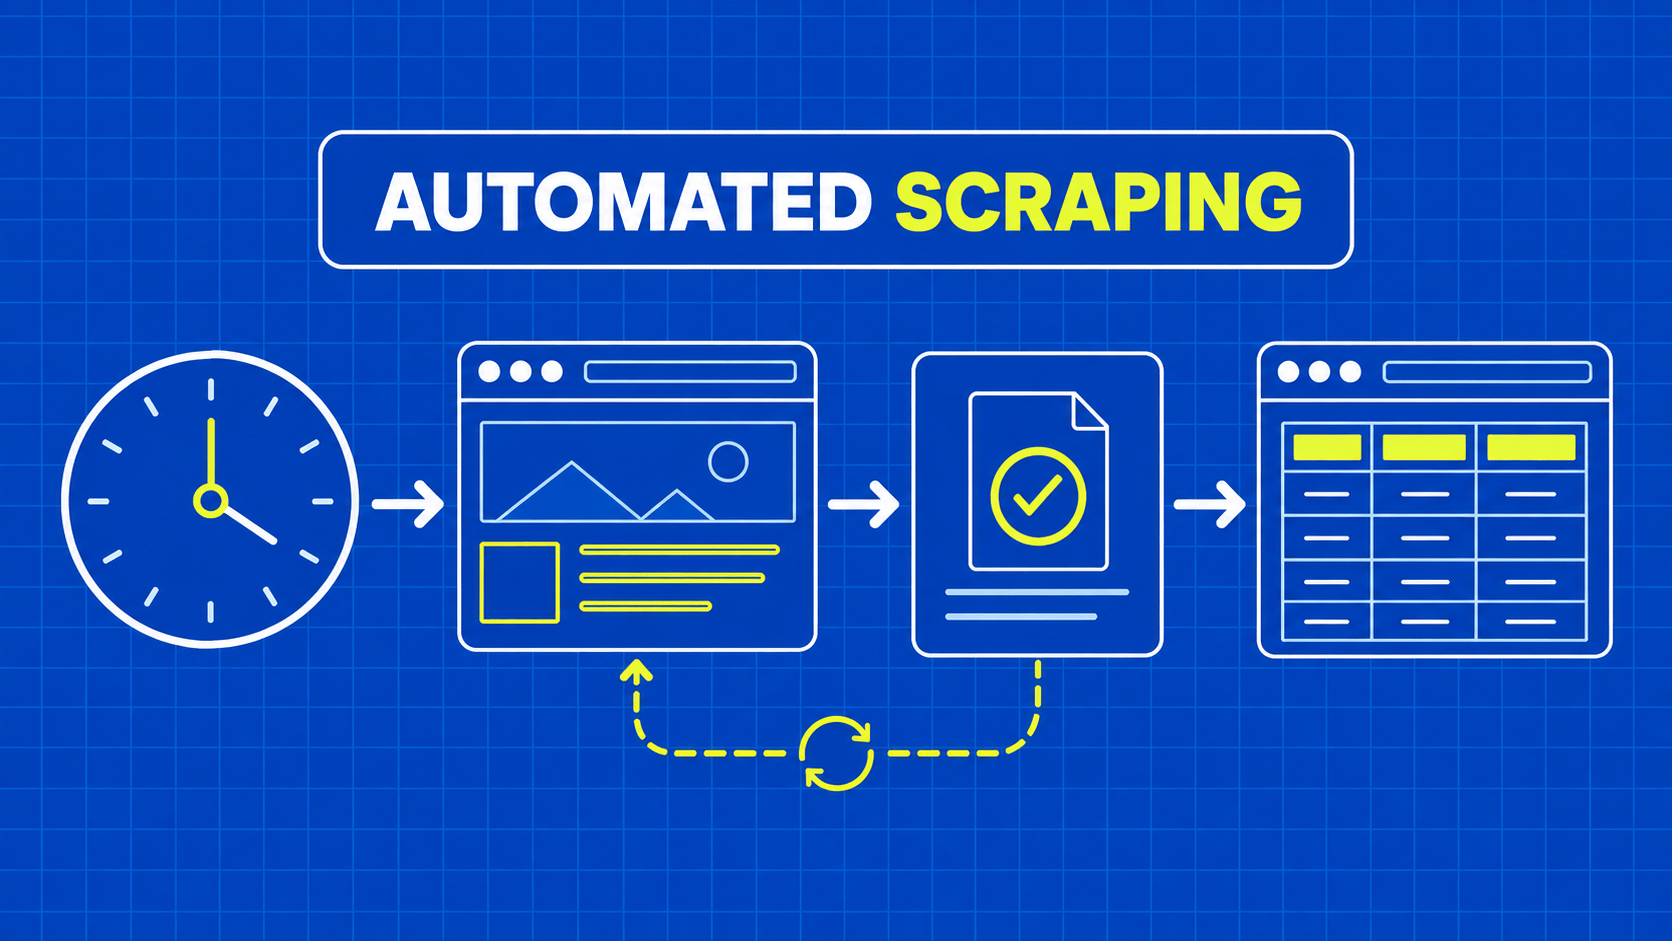
Um temporizador determina quando o trabalho deve ser concluído. Um rastreador decide quais as páginas a solicitar e como extrair os campos. Um processador de entrega transfere os registos aceites para o destino. Manter essas responsabilidades distintas evita que uma exportação falhada desencadeie automaticamente outro rastreio completo.

Fase

Entrada

Saída

Limite de falha

Agendamento

Prazo de entrega e configuração da fonte

Identidade da execução

Acionador ausente ou duplicado

Descobrir

Âmbito da fonte aprovado

Candidatos a pedidos

Categorias ou paginação em falta

Recolher

Pedidos e contexto da sessão

Respostas e resultados da recuperação

Tempos de espera, recusas, páginas inesperadas

Validar

Registos candidatos extraídos

Linhas aceites e evidências rejeitadas

Incompatibilidade de esquema ou semântica

Entregar

Lote aceite e identificação da entrega

Confirmação de destino

Gravação parcial ou reprodução duplicada

Esta divisão não requer serviços separados no primeiro dia. As funções dentro de uma aplicação podem ter as mesmas entradas e saídas explícitas. Comece com uma estrutura que possa testar localmente e, em seguida, distribua apenas as fases cuja carga de trabalho o justifique.

Tenha cuidado com a palavra «agendador». O agendador de pedidos interno de um rastreador não é necessariamente o sistema que inicia uma tarefa diária. O primeiro gere os pedidos pendentes dentro de uma execução; o segundo controla quando uma nova execução começa. Misturar esses conceitos pode levar a uma fila que retoma o rastreio de ontem, quando a sua intenção era uma nova observação diária.

Se utilizar um executor de fluxos de trabalho alojado, confirme as suas garantias de temporização. A documentação do GitHub sobre fluxos de trabalho agendados refere que os eventos agendados podem sofrer atrasos sob carga elevada e que alguns trabalhos em fila podem ser descartados. Um gatilho agendado conveniente não é, portanto, garantia de um momento exato de observação.

Defina uma política de sobreposição: ignorar, colocar na fila ou permitir execuções simultâneas sob identidades distintas. Não permita que duas execuções atualizem acidentalmente o mesmo diretório de pontos de verificação. Para uma fonte que demore mais tempo do que o intervalo pretendido, reduza o âmbito ou altere o requisito de atualização antes de adicionar tarefas sobrepostas de forma indiscriminada.

No que diz respeito à própria estrutura de recolha, o guia do Scrapy fornece um ponto de partida útil para a implementação. O seu contrato de execução deve permanecer claro, independentemente da estrutura que o execute.

Recuperação limitada, paginação e novas tentativas

Cada tarefa automatizada de scraping da Web necessita de uma regra de paragem definida. Defina os hosts permitidos, os padrões de caminho, a profundidade máxima de percurso quando apropriado, a interrupção da paginação, os tempos limite das solicitações e um prazo de execução. Um rastreador que siga todos os links disponíveis pode sair do conjunto de dados pretendido sem encontrar um erro técnico.

Escolha o método de recuperação a partir dos campos obrigatórios. O conteúdo renderizado pelo servidor pode necessitar apenas de um cliente HTTP. Os campos renderizados por script podem exigir a execução no navegador. Uma API de origem documentada pode oferecer uma via mais estável quando os seus termos e cobertura de dados forem adequados. A nossa comparação de clientes HTTP em Python ajuda a avaliar a via mais leve antes de introduzir a infraestrutura do navegador.

Classifique os erros antes de tentar novamente. Uma falha temporária de rede difere de uma credencial inválida ou de um analisador que já não corresponde à página. Tentar novamente as três situações com o mesmo ciclo desperdiça capacidade e oculta a falha que requer ação humana.

O cabeçalho «Retry-After» pode indicar um período de espera em segundos ou uma data HTTP. Quando aplicável, respeite as instruções do servidor e a sua própria política de pedidos. Defina um limite de tentativas e um prazo para a tarefa, para que uma espera cooperativa não se transforme numa tarefa em execução indefinida.

Resultado

Ação seguinte típica

Preservar

Falha temporária de ligação

Nova tentativa com atraso limitado

Número de tentativas e categoria de erro

Resposta com limitação de taxa

Respeitar o atraso e reduzir a pressão

Estado da resposta e próximo momento elegível

Autenticação rejeitada

Interromper o trabalho dependente e rever a sessão

Resultado da verificação de identidade censurado

Página esperada em falta

Classificar a resposta antes da análise

URL final e evidência do tipo de página

Incompatibilidade do analisador

Colocar em quarentena e investigar

Versão do analisador e fixture permitido

Limitar a simultaneidade por fonte, bem como globalmente. Um anfitrião lento não deve receber todos os trabalhadores disponíveis simplesmente porque outras filas estão vazias. O Scrapy AutoThrottle ajusta os atrasos utilizando feedback relacionado com a latência, mas não é um mecanismo de permissão nem uma garantia de que a política de pedidos escolhida seja adequada.

No caso da paginação, registe o motivo pelo qual a descoberta foi interrompida. Uma página final explícita, um cursor repetido, um resultado vazio e uma solicitação falhada têm significados diferentes. Trate um cursor repetido como um possível defeito, em vez de aceitar silenciosamente um conjunto de dados mais pequeno como completo.

Valide os registos antes de estes entrarem no destino

Uma recuperação bem-sucedida prova que chegou uma resposta. Não prova, porém, que o preço extraído pertença ao produto certo nem que a resposta contenha, de todo, produtos. Insira a validação entre a análise e a entrega, com verificações adequadas ao conjunto de dados.

Comece pela estrutura: campos obrigatórios, tipos esperados, identificadores estáveis e formatos permitidos. Em seguida, verifique o significado: a moeda deve corresponder ao montante, uma data deve ter a interpretação correta, uma listagem deve estar associada à variante selecionada e uma mensagem «não disponível» não deve ser convertida num zero numérico.

O pipeline de itens do Scrapy fornece um local documentado para o processamento e a validação dos itens extraídos. O princípio arquitetónico vai além de uma única estrutura: a validação deve ser uma etapa explícita cujos resultados se possam contabilizar e inspecionar.

Mantenha os registos rejeitados num fluxo de revisão controlado, quando as regras de retenção o permitirem. Inclua um código de motivo e provas de origem suficientes para a investigação. A eliminação silenciosa das falhas faz com que o ficheiro entregue pareça mais limpo, ao mesmo tempo que oculta uma alteração na cobertura. A contagem de rejeições deve constar do relatório de execução, mesmo quando os valores rejeitados não pertencem ao conjunto de dados do consumidor.

Algumas verificações são aplicadas a todo o lote. Uma queda repentina no número de identificadores de produto distintos pode indicar a falta de paginação. Identificadores duplicados podem revelar erros no tratamento de variantes. Uma alteração na distribuição de preços pode refletir uma promoção ou um defeito no analisador. Estes sinais devem desencadear uma investigação; não são razões suficientes para apagar automaticamente valores invulgares.

Utilize fixtures revistos para tipos de páginas representativas, incluindo páginas com falhas. Uma página de início de sessão, um pedido de consentimento, uma listagem removida e uma categoria vazia são entradas de teste valiosas. Elas ensinam ao analisador e ao classificador de respostas o que não devem tratar como registos normais.

Não substitua um contrato de dados pela confiança na IA. Se um modelo ajudar a extrair ou classificar campos, avalie os seus resultados em comparação com exemplos revistos e guarde a versão do modelo ou do prompt. Um JSON válido pode ainda conter uma associação incorreta ou um valor adivinhado. Mantenha os resultados incertos distinguíveis dos campos observados diretamente.

As verificações de aceitação também devem ser executadas no limite do consumidor. Um destino pode truncar cadeias de caracteres, interpretar identificadores como números ou converter valores em falta de forma inesperada. Verifique um ciclo completo através do percurso real de exportação e importação antes de declarar o esquema estável.

Conceba pontos de verificação e repetição como operações distintas

A recuperação começa com uma pergunta: está a continuar uma execução de observação interrompida, a reenviar um lote existente ou a recolher uma nova observação? Essas operações podem envolver os mesmos URLs, mas não devem ter a mesma identidade nem efeitos secundários.

A documentação sobre persistência de tarefas do Scrapy descreve o estado de rastreamento guardado através de JOBDIR e adverte contra a partilha de um diretório entre tarefas separadas. Retome após uma paragem limpa; um encerramento abrupto pode corromper o estado da tarefa. Os pedidos que não podem ser serializados permanecem na memória e são perdidos quando a tarefa é pausada. A documentação atual também exige que a retoma seja feita com a mesma versão do Scrapy. Teste essas condições antes de confiar num ponto de verificação para uma cobertura completa. Uma fila persistida é útil, mas não é um ponto de verificação transacional universal para toda a sua aplicação.

Mantenha o progresso do rastreio separado do progresso da entrega. Uma página pode ter sido obtida e analisada enquanto a sua saída ainda não chegou ao destino. Por outro lado, o destino pode ter aceitado um lote mesmo que o seu trabalhador tenha perdido a confirmação. Reiniciar toda a operação sem uma identidade de entrega pode criar linhas duplicadas.

Defina uma chave de registo de acordo com o conjunto de dados. Para a sincronização do estado atual, um identificador do produto de origem, juntamente com o âmbito relevante, pode identificar a entidade a atualizar. Para o histórico de observações, a chave também necessita da identidade da observação ou da execução. Utilizar apenas o identificador do produto sobrescreveria o histórico que pretendia preservar.

Utilize um identificador de entrega estável para novas tentativas do mesmo lote aceite. O destino ou a sua camada de entrega podem reconhecer essa identidade e evitar a sua aplicação dupla. Não presuma um comportamento «exatamente uma vez» apenas porque um componente possui filtragem de duplicados. A garantia depende de todo o percurso de gravação e confirmação.

Operação

Reutilizar a identidade da observação?

Recuperar a fonte novamente?

Continuar a recolha interrompida

Sim, com os horários reais das observações

Apenas trabalho pendente ou explicitamente repetido

Repetir a entrega dos resultados aceites

Sim

Não, reutilizar o lote aceite

Iniciar uma nova observação agendada

Não

Sim, dentro do novo âmbito

Corrigir um defeito do analisador

Preservar a linha de correção

Depende das evidências retidas e da política

Tornar as decisões de recuperação auditáveis. Se uma execução retomada abranger uma longa interrupção, identifique a janela de observação com honestidade. Os seus registos podem já não descrever um instantâneo preciso. A resposta adequada poderá ser uma nova execução, em vez de fingir que os resultados retomados foram recolhidos num único instante.

Trate o armazenamento de pontos de verificação como um estado operacional, com cópias de segurança e controlos de acesso adequados ao seu conteúdo. Não armazene sessões confidenciais num diretório partilhado sem restrições. Um mecanismo de recuperação deve restaurar o trabalho, não alargar o acesso às contas que este utiliza.

Entregue um lote com um manifesto e um aviso de receção

Um ficheiro de exportação não é prova de que o destino o tenha consumido. Acompanhe a entrega separadamente, incluindo a identidade da saída, o número de registos, a versão do esquema e o estado de confirmação ou falha. Isso permite que um operador tente novamente a entrega sem ter de adivinhar se os dados precisam de ser recolhidos novamente.

As exportações do Scrapy Feed documentam os formatos de saída suportados e a configuração de armazenamento. Escolha o formato com base no destinatário, em vez de apenas pela conveniência. O CSV simples adapta-se a muitos fluxos de trabalho tabulares, enquanto os dados aninhados requerem frequentemente uma política de simplificação explícita ou um formato que mantenha a estrutura.

Inclua um manifesto com o lote. Este deve explicar o intervalo de observação, a cobertura da fonte, as contagens de dados aceites e rejeitados e se a execução foi parcial. Se uma fonte falhar, os utilizadores a jusante devem saber disso antes de interpretarem o conjunto de dados como uma comparação completa.

Para a entrega de ficheiros, evite expor um ficheiro parcialmente gravado com o nome final. Utilize o mecanismo de preparação e conclusão suportado pelo sistema de armazenamento e teste o seu comportamento real. Para a entrega via API, defina a identidade de repetição de tentativas e o tratamento de erros parciais antes de enviar um lote grande. Uma resposta mista não deve obrigá-lo a adivinhar quais as linhas que foram aceites.

Faça da conclusão uma transição de estado com evidência. «Entregue» deve significar que a ação de destino exigida foi bem-sucedida de acordo com o seu contrato, e não apenas que a função de exportação foi concluída. Se os consumidores recolherem ficheiros de forma assíncrona, mantenha essa distinção no estado da tarefa.

Mantenha um artefacto aceite que possa ser reproduzido, sempre que a política o permitir. É valioso para recuperação, depuração e reprocessamento para um novo esquema de destino. Limite a retenção ao necessário para o fluxo de trabalho e distinga as evidências de origem das exportações normalizadas, para que cada uma tenha um ciclo de vida adequado.

Monitorize a atualidade dos dados e teste os percursos de falha antes de escalar

A pergunta mais importante no painel de controlo é frequentemente: «Qual é a antiguidade dos dados utilizáveis mais recentes?» Um número elevado de trabalhadores em bom estado diz pouco se cada um deles estiver a produzir linhas rejeitadas. Acompanhe a atualidade a partir de observações bem-sucedidas ou da entrega de acordo com os requisitos do consumidor, e não a partir do último início do processo.

Monitorize cada fase com contagens separadas. As páginas solicitadas, as respostas recuperadas, as linhas aceites, as linhas rejeitadas e as entregas confirmadas não devem ser agrupadas numa única percentagem de sucesso. As variações entre essas contagens indicam-lhe onde deve investigar.

Adicione um alerta de execução em falta. Uma tarefa que nunca arranca não pode emitir a sua própria mensagem de falha. Uma verificação independente deve detetar quando os dados esperados não chegaram dentro do prazo permitido. Registe os atrasos na programação separadamente da lentidão na recolha de dados e do atraso nas entregas.

Antes de expandir o conjunto de fontes, teste deliberadamente interrupções, gatilhos duplicados, sessões expiradas, seletores alterados, campos obrigatórios em falta e uma falha no destino. Verifique se cada resultado tem uma resposta delimitada e deixa informação suficiente para a recuperação. Uma demonstração do «caminho ideal» não garante a fiabilidade operacional.

Implemente alterações no analisador em ambientes de teste e, em seguida, numa pequena amostra controlada em produção, dentro do âmbito de fontes aprovado. Compare os significados e a cobertura dos campos, e não apenas o número de linhas. Um novo analisador que extraia mais linhas pode estar a seguir um widget de recomendação não pretendido.

Mantenha a reversão e a correção de dados separadas. A reversão do código evita mais resultados incorretos; não repara registos já entregues. O seu procedimento de incidentes deve identificar os IDs de execução afetados, notificar os consumidores quando necessário e produzir uma correção rastreável, em vez de reescrever silenciosamente o histórico.

Dimensiona a etapa que está efetivamente a limitar o fluxo de trabalho. Se a validação rejeitar a maioria das linhas, mais trabalhadores de recuperação apenas geram mais trabalho de revisão. Se a entrega for o estrangulamento, aumentar a simultaneidade do navegador pode agravar a pressão sobre o armazenamento sem melhorar a atualidade útil.

Pontos-chave

  • Atribua a cada execução automatizada de web scraping um âmbito, uma identidade, uma política de aceitação e um responsável claros.
  • Separe o agendamento, a recolha, a validação e a entrega, para que cada um possa falhar e recuperar de forma independente.
  • Limite as tentativas de repetição e distinga os erros temporários de transporte dos defeitos de autenticação ou do analisador.
  • Mantenha as novas observações, o trabalho retomado e as tentativas de entrega semanticamente distintas.
  • Monitorize a atualidade dos dados utilizáveis e teste as falhas antes de aumentar a escala.

Perguntas frequentes

Cada campo recolhido deve ter o mesmo período de retenção?

Não. As evidências de origem em bruto, os registos normalizados, os registos operacionais e o estado de autenticação têm finalidades diferentes e podem exigir ciclos de vida distintos. Defina a retenção de acordo com a finalidade e a sensibilidade e, em seguida, verifique a eliminação em cada local de armazenamento. Uma política de registos de curta duração não remove automaticamente as exportações ou cópias de segurança mais antigas.

O mesmo pipeline pode suportar vários conjuntos de dados de clientes?

Sim, se o âmbito da fonte, os direitos de acesso, o estado e os destinos forem isolados deliberadamente. Utilize um contexto explícito do inquilino e valide-o nos limites. A reutilização de código de análise é diferente da partilha de credenciais ou de sessões mutáveis. Verifique se uma nova tentativa ou alteração de configuração de um cliente não pode encaminhar os dados de outro cliente para o destino errado.

Como devem ser estimados os custos de recolha?

Avalie um projeto-piloto representativo, incluindo tentativas falhadas, execução no navegador, trabalho de validação, armazenamento e entrega. Divida o total relevante pela produção utilizável, em vez de apenas pelas páginas solicitadas. Considere esse valor como uma observação específica da carga de trabalho, e não como um custo universal por site. Reavalie-o quando os layouts de origem, a cobertura ou os requisitos de atualização mudarem.

Conclusão

A extração automatizada de dados da Web torna-se fiável quando a tarefa explica o que aconteceu, e não apenas que foi concluída. Uma identidade de execução, verificações explícitas de aceitação, novas tentativas limitadas e entrega confirmada tornam as falhas recuperáveis e os resultados interpretáveis.

Comece com um pequeno conjunto de fontes e um ciclo de vida completo. Interrompa a tarefa, tente novamente a sua entrega e confirme que o destino não recebe duplicados indesejados. Verifique se um atraso na programação gera um alerta e se uma resposta bem-sucedida contendo a página errada nunca se torna um dado comum. Esses testes geram uma confiança mais útil do que uma contagem impressionante de pedidos.

Se a recuperação de páginas em funcionamento for a principal restrição, avalie a API Scraper da WebScrapingAPI para esse componente, mantendo simultaneamente o seu contrato de validação e entrega. Transferir a recuperação para um serviço não elimina a necessidade de definir a cobertura ou a atualidade. O objetivo é um pipeline cuja saída outro programador possa inspecionar, em que possa confiar dentro dos limites estabelecidos e recuperar sem ter de executar tudo de novo cegamente.

Se preferir não operar o pipeline, os Data Feeds entregam conjuntos de dados recorrentes de forma programada e, com o Managed Data, a nossa equipa constrói e opera a recolha por si.

Sobre o autor

Andrei Ogiolan, Desenvolvedor Full Stack @ WebScrapingAPI

Andrei Ogiolan

Desenvolvedor Full Stack

Andrei Ogiolan é um programador Full Stack na WebScrapingAPI, contribuindo em todas as áreas do produto e ajudando a criar ferramentas e funcionalidades fiáveis para a plataforma.

Web Scraping com AWS Lambda: Guia para Python e Java 2026
Guias

Web Scraping com AWS Lambda: Guia para Python e Java 2026

TL;DR: Resumo: A extração de dados da Web com o AWS Lambda funciona melhor quando cada invocação é curta, delimitada e pode ser repetida de forma independente. Comece com HTTP direto, AWS SAM e S3 e, só depois, adicione SQS, contentores, renderização no navegador, proxies ou uma camada de recuperação gerida, apenas quando a carga de trabalho demonstrar que precisa deles.

Suciu Dan32 min read
Ler artigo
Como utilizar o GoSpider: rastrear, limpar URLs e extrair dados
Guias

Como utilizar o GoSpider: rastrear, limpar URLs e extrair dados

TL;DR: Resumo: O GoSpider é um rastreador de linha de comandos destinado a descobrir URLs, não um extrator completo de dados estruturados. Este guia sobre como utilizar o GoSpider mostra como realizar um rastreio limitado, gerir resultados de forma organizada, fazer a transferência de dados do Colly para CSV e seguir um percurso de diagnóstico para respostas 403 ou páginas que exijam renderização em JavaScript.

Suciu Dan23 min read
Ler artigo
Como fazer o Scrape Redfin: Guia Python para Dados de Propriedade
Guias

Como fazer o Scrape Redfin: Guia Python para Dados de Propriedade

TL;DR: A Redfin expõe pontos de extremidade de API ocultos que retornam JSON estruturado para listagens de propriedades, tornando possível ignorar totalmente a análise HTML frágil. Este guia orienta-o na construção de um scraper Python que extrai dados de aluguer e venda, pesquisa por localização, monitoriza novas listagens através de sitemaps XML e exporta resultados limpos para CSV ou JSON.

Suciu Dan14 min read
Ler artigo

Comece a construir

Pronto para expandir a sua recolha de dados?

Junte-se a mais de 2.000 empresas que utilizam a WebScrapingAPI para extrair dados da Web à escala empresarial, sem quaisquer custos de infraestrutura.
