Extrair dados do Expedia com Python: hotéis e preços
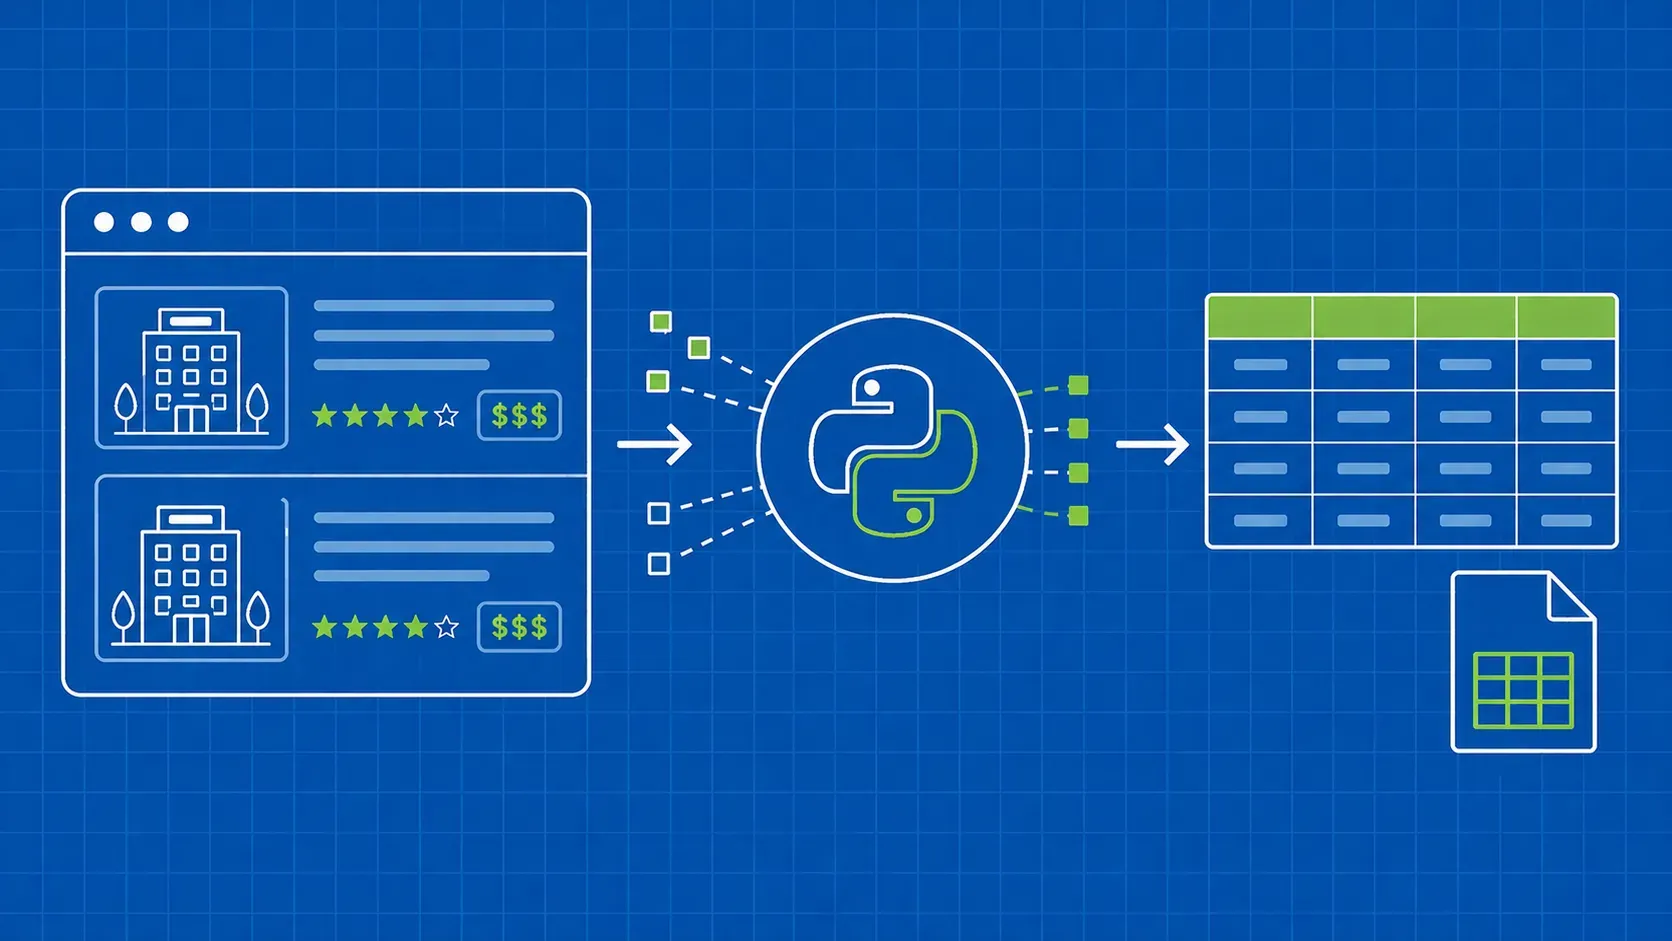
TL;DR: Extraia os anúncios de hotéis da Expedia com Python, utilizando renderização em JS, proxies, seletores CSS e paginação; em seguida, limpe e exporte os dados para CSV.
Perfil do autor
Mihai Maxim é um programador Full Stack na WebScrapingAPI, contribuindo em todas as áreas do produto e ajudando a criar ferramentas e funcionalidades fiáveis para a plataforma.

Artigos publicados
15 artigos

TL;DR: Extraia os anúncios de hotéis da Expedia com Python, utilizando renderização em JS, proxies, seletores CSS e paginação; em seguida, limpe e exporte os dados para CSV.

TL;DR: Os selectores XPath e CSS localizam ambos elementos DOM, mas resolvem problemas diferentes. Os selectores CSS são mais rápidos e mais legíveis para selecções simples. O XPath ganha quando é necessário percorrer o DOM em qualquer direção, fazer corresponder conteúdo de texto ou lidar com lógica condicional complexa. A maioria dos projectos de produção beneficia da utilização de ambos estrategicamente.

TL;DR: Web scraping com regex brilha quando você precisa de padrões de texto curtos e previsíveis (preços, SKUs, e-mails, datas) do HTML em que você já confia. Emparelhe o módulo re do Python com Beautiful Soup, escopo seus padrões para um nó analisado em vez de marcação bruta, e mantenha o regex fora do caminho da análise completa da árvore HTML. Este guia apresenta um raspador de título e preço em funcionamento, recursos avançados de regex e as armadilhas que afetam os raspadores reais em produção.

TL;DR: Um projeto de web scraping falha no planeamento muito antes de falhar no código. Estas dez perguntas sobre scraping orientam-no através da legalidade, alternativas de API, defesas anti-bot, custo, cadência de atualização, qualidade dos dados e governação, para que possa definir o âmbito do trabalho, escolher a stack certa e evitar os modos de falha que matam silenciosamente os scrapers em produção.

TL;DR: Descubra como utilizar o Web Stealth Proxy como um profissional com o nosso guia de início rápido. Obtenha instruções passo a passo para otimizar a sua experiência com proxies e elevar a sua privacidade online a um novo nível. Comece hoje mesmo!

TL;DR: Identifique o salto com falha antes de voltar a tentar um pedido de proxy. Utilize códigos de estado, resultados do comando CONNECT e registos de diagnóstico seguros para distinguir as falhas do proxy das respostas do destino.

TL;DR: Resumo: Primeiro, determine se as linhas da tabela existem na resposta HTTP, se são obtidas através de um pedido de dados ou se requerem que um navegador as apresente. Em seguida, utilize o script estático do Axios e do Cheerio ou a abordagem específica do Puppeteer apresentada abaixo para extrair dados de uma tabela HTML em JavaScript, validar registos com base nos cabeçalhos, eliminar páginas duplicadas e gravar ficheiros CSV de forma segura. Uma tabela HTML organiza a informação em linhas e colunas, normalmente com os elementos <table>, <tr>, <th> e <td>. Extrair uma tabela HTML em JavaScript significa recuperar ou renderizar essa marcação, converter cada linha de dados num objeto JavaScript, validar o resultado e serializá-lo para um formato como o CSV.

TL;DR: Jsoup é a biblioteca padrão para análise de HTML em Java. Este guia percorre todo o ciclo de vida (configuração do Maven, carregamento de um documento, seletores CSS, travessia do DOM, extração, modificação e serialização), além de um projeto de raspagem executável, tratamento de erros, paginação e os limites que o levam a um navegador sem cabeça ou a uma API de raspagem.

TL;DR: Para extrair texto de HTML em Python, analise a marcação com um analisador real (BeautifulSoup, lxml.html ou html-text), remova scripts, estilos e cromo do site e, em seguida, normalize o espaço em branco e o Unicode antes de salvar. Este guia compara as principais bibliotecas, corrige as armadilhas comuns de limpeza e termina com um rastreador executável que escreve JSONL e arquivos .txt por página.

TL;DR: Este é um guia opinativo, de ponta a ponta, para raspagem da web com Scrapy em 2026. Você instalará o Scrapy, criará protótipos de seletores no shell, construirá um spider de comércio eletrônico de várias páginas, limpará itens com Item Loaders, persistirá em um banco de dados, fortalecerá as configurações contra proibições e incluirá o Scrapy-Playwright para páginas renderizadas em JavaScript.

TL;DR: Resumo: A utilização do JavaScript com o Scrapy nem sempre requer um navegador. Em primeiro lugar, analise a resposta em bruto, os pedidos de rede e o estado da página incorporada; adicione o scrapy-playwright apenas quando os dados alvo dependerem efetivamente da execução no navegador e, em seguida, controle deliberadamente as esperas, as interações, a limpeza e a concorrência.

TL;DR: Esta folha de dicas de XPath cobre a sintaxe, predicados, eixos e funções que você realmente precisa para raspagem da web, além de uma tabela de tradução CSS-para-XPath e exemplos executáveis de Puppeteer e Scrapy. Use-a como referência na próxima vez que um seletor CSS quebrar silenciosamente em um site do qual você depende.

TL;DR: Resumo: a escolha certa depende de o gargalo do Scrapy ser a renderização, o bloqueio, a adequação da linguagem ou as operações. Sempre que possível, mantenha ou amplie os spiders em bom estado; use ferramentas de navegador para páginas interativas, plataformas alojadas para operações, ferramentas leves para tarefas estáticas delimitadas e APIs geridas quando a infraestrutura de pedidos for a limitação. Valide a lista final com um modelo de custos e uma prova de conceito representativa.

TL;DR: Verifique a identidade atual do serviço antes de seguir recomendações antigas do Profit Scraper. Crie um fluxo de trabalho alternativo para a listagem de dados, a pesquisa de preços de venda e as premissas de custos transparentes.

TL;DR: O Rust é uma linguagem rápida e eficiente em termos de memória. Mas como é que lida com a extração de dados da Web? Consulte este guia para principiantes e descubra como pode utilizá-la para criar um programa básico de extração de dados da Web.
Comece a construir
Junte-se a mais de 2.000 empresas que utilizam a WebScrapingAPI para extrair dados da Web à escala empresarial, sem quaisquer custos de infraestrutura.