
Saltar para o conteúdo
Comece grátis
Voltar ao blogue

Aplicações de extração de dados: compare quatro fluxos de trabalho reais

Mihnea-Octavian ManolacheÚltima atualização em 15 min read
Aplicações de extração de dados: compare quatro fluxos de trabalho reais
Resumo: O Octoparse, o ParseHub, o Web Scraper e o Apify oferecem diferentes formas de transformar um site num conjunto de dados. Escolha com base em quem irá manter o projeto, onde as tarefas devem ser executadas e como os resultados chegam ao seu destino; depois, teste todo o fluxo de trabalho com páginas representativas.

Uma folha de cálculo que só fica disponível quando um colaborador abre o portátil é um produto diferente de um conjunto de dados entregue automaticamente todas as manhãs. As aplicações de extração de dados podem suportar ambos os tipos de trabalho, mas uma demonstração visual bem-sucedida não indica qual o modelo operacional que está a adquirir.

O ponto de partida certo é uma tarefa específica: recolher estes campos, destas fontes aprovadas, com esta frequência, para este destino. Assim que essa tarefa estiver clara, a comparação entre aplicações torna-se muito mais fácil. Pode separar as funcionalidades essenciais das opções que parecem úteis, mas que não irão alterar o resultado.

Este guia compara quatro opções reais e as decisões que as envolvem. Centra-se na criação de projetos, na sua execução, na exportação de resultados, na ligação a sistemas a jusante e na manutenção do fluxo de trabalho. Não classifica as aplicações com base em pontuações de precisão inventadas nem parte do princípio de que um plano de nuvem funcionará com todos os sites. O objetivo prático é selecionar uma aplicação que a sua equipa consiga utilizar após a primeira exportação, com um projeto-piloto que revele o trabalho que ainda resta por fazer.
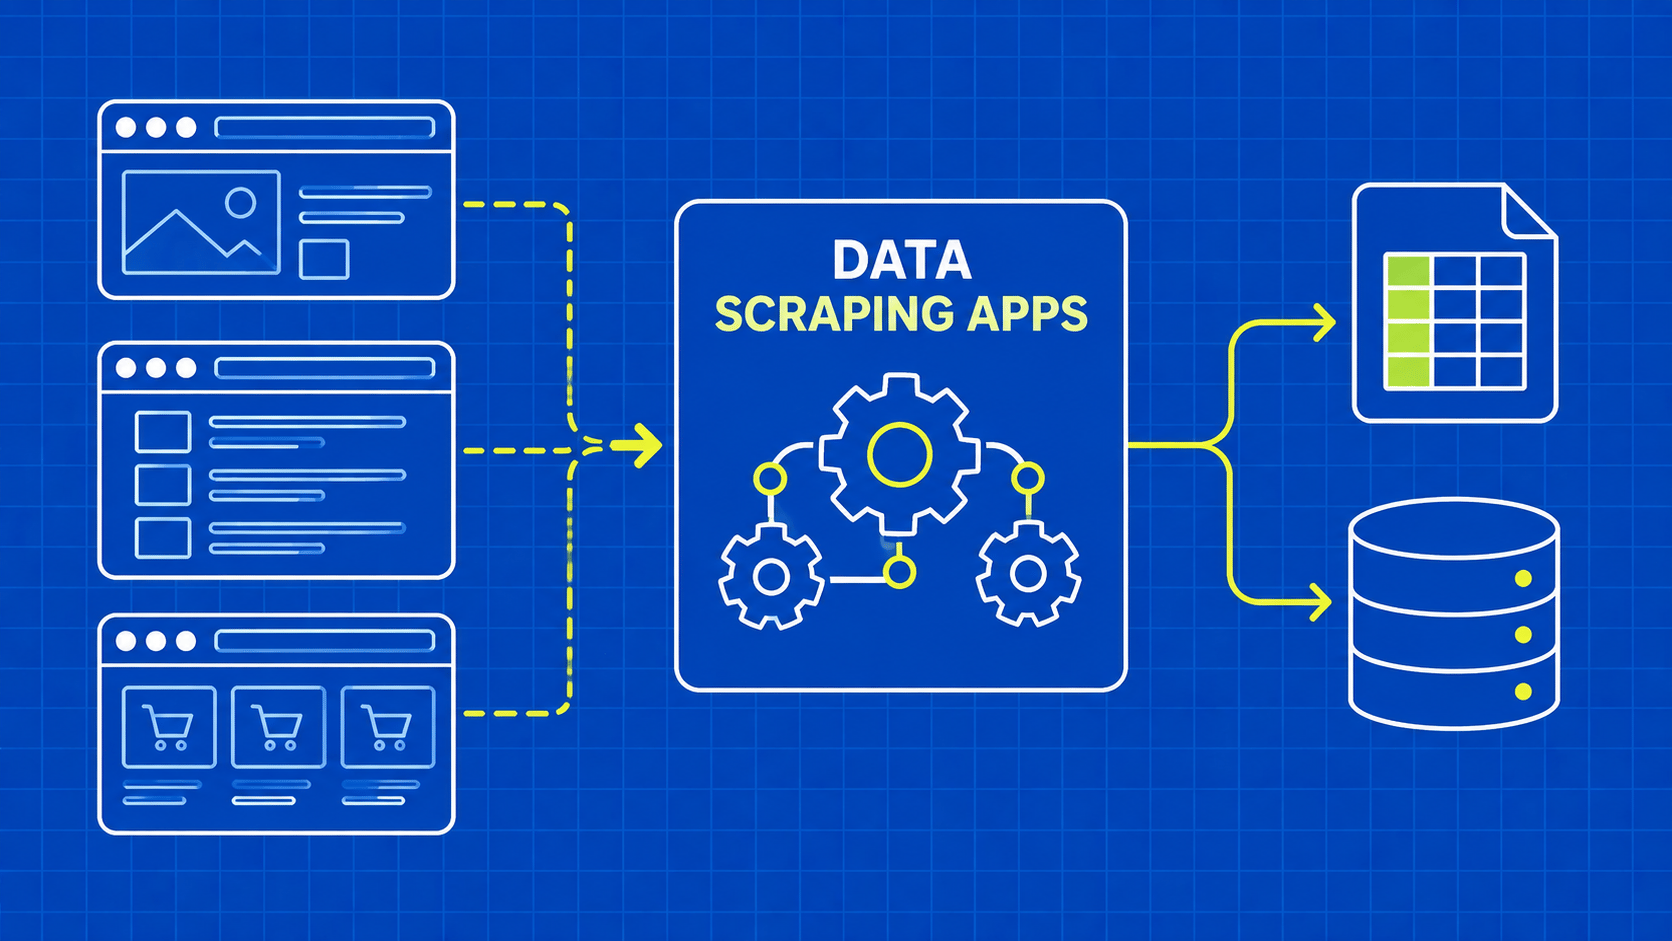
Compare aplicações de extração de dados com base no seu modelo de funcionamento

Algumas aplicações começam com um editor de ambiente de trabalho. Outras utilizam uma extensão de navegador ou uma consola na nuvem. Todas essas interfaces podem produzir registos estruturados, mas distribuem a responsabilidade de forma diferente entre a pessoa que configura a tarefa, o serviço que a executa e o sistema que consome os resultados.

Aplicação

Ponto de partida do projeto

Distinção entre execução e entrega

Cenário de avaliação útil

Octoparse

Configurar uma tarefa de scraping na sua aplicação

As execuções locais e na nuvem têm percursos de acesso e integração diferentes

Um analista necessita de uma configuração visual seguida de entregas recorrentes

ParseHub

Crie um projeto na aplicação para computador

Os resultados da execução podem ser descarregados através da aplicação ou da interface da conta

Um operador pretende um projeto que possa ser inspecionado e uma saída em CSV ou JSON

Web Scraper

Crie um mapa do site na extensão do navegador

A execução local e a automatização na nuvem são percursos de produto distintos

Um fluxo de trabalho baseado no navegador necessita de um caminho para a operação programada

Apify

Configure um Actor existente ou desenvolva um

As tarefas na nuvem ligam-se ao armazenamento da plataforma e às integrações

Uma equipa necessita de automação reutilizável que se adapte ao fluxo de trabalho de uma aplicação

Os cenários são pontos de partida editoriais, não afirmações de que uma aplicação é a melhor para todos os utilizadores dessa categoria. Teste o site de destino e o formato do resultado pretendido antes de tomar uma decisão de compra. As secções abaixo associam as capacidades específicas desta tabela à documentação oficial.

Não confunda um mercado de modelos com compatibilidade universal. Um scraper pré-configurado pode abranger a sua fonte, mas omitir um campo, uma região ou um tipo de página de que o seu projeto necessita. Da mesma forma, um editor visual pode eliminar a necessidade de escrever seletores manualmente, mas continua a exigir que compreenda a paginação, os registos repetidos e a relação entre páginas de lista e de detalhes.

As aplicações de extração de dados devem ser comparadas ao longo de todo o percurso, desde a entrada até à saída aceite. Uma aplicação que demore mais tempo a configurar pode, ainda assim, adequar-se melhor à sua equipa se o resultado for fácil de inspecionar e entregar. Uma primeira exportação rápida é uma prova útil, mas é apenas o início da avaliação.

Octoparse: analise a transição do ambiente local para a nuvem

O Octoparse documenta um fluxo de trabalho de tarefas com execução local e na nuvem. Uma execução local depende do dispositivo que está a realizar o trabalho; uma execução na nuvem continua na infraestrutura do serviço, mesmo quando a aplicação de secretária ou o computador estão fechados. Essa distinção é importante antes de prometer uma entrega sem supervisão. Fluxo de trabalho de execução do Octoparse.

A sua documentação de exportação enumera formatos de folha de cálculo e estruturados, destinos de bases de dados e opções de armazenamento na nuvem. Também distingue os dados locais dos dados na nuvem: a exportação via API e o caminho Zapier documentado aplicam-se aos dados na nuvem. Verifique os requisitos relevantes do plano e do destino, em vez de assumir que todos os métodos de exportação funcionam de forma idêntica para ambos os modos de execução. Formatos de exportação do Octoparse.

Para um projeto-piloto, crie uma tarefa que recolha tanto um campo de listagem como um campo da página de detalhes. Exporte localmente e, em seguida, repita a mesma tarefa delimitada utilizando o modo de implementação pretendido. Compare o número de registos, os nomes dos campos, os valores em falta e a associação entre listagens principais e registos de detalhes.

A transferência de responsabilidades é o teste mais importante. Confirme quem pode editar a tarefa, quem pode visualizar os resultados da execução e como um colega recupera a saída quando o criador original está ausente. Registe quaisquer etapas manuais de exportação ou limpeza. As aplicações de extração de dados que oferecem várias vias de entrega podem ser flexíveis, mas o seu fluxo de trabalho efetivo deve estabelecer-se numa única via documentada.

Não considere a pré-visualização da aplicação como o produto final de aceitação. Abra o ficheiro exportado no destino que o irá utilizar. Preserve os identificadores como cadeias de caracteres, verifique as descrições com várias linhas e confirme que uma segunda execução não acrescenta acidentalmente duplicados onde a sua equipa esperava um instantâneo de substituição.

ParseHub: avalie o projeto e o fluxo de trabalho de resultados

A documentação do ParseHub descreve como criar um projeto na aplicação para computador, iniciar uma execução e descarregar os dados resultantes em formato CSV ou JSON. Também documenta a recuperação de resultados a partir da página da conta ou do link do e-mail de conclusão. Estas são opções concretas para um operador que precise de inspecionar e recolher execuções concluídas. Guia de execução e descarregamento do ParseHub.

O produto também documenta o fornecimento de uma lista inicial de URLs através da importação de CSV ou de valores JSON. Isso é útil quando já dispõe de uma lista de fontes e pretende processar essas páginas, em vez de descobrir links através da navegação de um site. Entrada de lista de URLs do ParseHub.

Avalie esses dois caminhos separadamente. Um rastreio de diretório precisa de descobrir e seguir os links corretos. Uma lista fixa precisa de preservar a relação entre cada URL de entrada e a sua saída. Se uma fonte não produzir nenhum registo, o seu processo a jusante deve ser capaz de identificar a entrada em falta, em vez de se limitar a observar que o ficheiro final é mais curto.

Durante um período de teste, inclua registos com campos opcionais e vários valores filhos. Verifique como essas relações aparecem no JSON e na saída em folha de cálculo simplificada. O formato mais conveniente para um revisor humano pode diferir do melhor formato para uma importação para uma base de dados.

O ParseHub deve figurar na lista restrita de aplicações de extração de dados quando o seu modelo de projeto corresponder à forma como o seu operador encara a tarefa. Teste a facilidade com que essa pessoa consegue encontrar e corrigir uma seleção incorreta. Verifique também os limites atuais de automação e de conta para o plano específico que pretende utilizar; esta comparação não pressupõe que todas as opções de implementação ou agendamento estejam incluídas.

Web Scraper: separar a extensão da operação na nuvem

O Web Scraper utiliza um mapa do site para descrever a navegação e a extração. A sua documentação explica que se cria e testa o mapa do site numa extensão do navegador e, em seguida, o executa localmente ou no seu serviço na nuvem. Aqui, «mapa do site» refere-se à configuração de extração da aplicação, e não ao ficheiro XML que um site publica para os motores de busca. Documentação do Web Scraper.

A mesma documentação distingue os produtos: a extensão cria e executa mapas do site locais, enquanto o serviço na nuvem adiciona funcionalidades como agendamento, monitorização, acesso à API, webhooks e entrega automatizada. Analise o plano escolhido e a compatibilidade do mapa do site antes de considerar uma experiência local como um fluxo de trabalho de produção.

Este é um modelo útil quando se pretende inspecionar a navegação como uma estrutura explícita. Para o projeto-piloto, trace um percurso completo desde um URL inicial até uma lista, depois para uma página de detalhes e, finalmente, para o registo exportado. Verifique se o registo ainda contém informação de origem suficiente para explicar de onde veio cada campo.

Teste cuidadosamente a navegação repetida. Um controlo de «próxima página», uma ação de «carregar mais» e a rolagem infinita podem exigir comportamentos diferentes do projeto. A questão não é se o nome da funcionalidade aparece numa lista de produtos; é se a sua página específica atinge a condição de paragem esperada sem recolher os mesmos itens repetidamente.

Entre as aplicações de extração de dados, uma extensão pode facilitar a inspeção inicial, mas a entrega recorrente continua a necessitar de um responsável operacional. Confirme como a tarefa na nuvem recebe atualizações, como os resultados são recuperados e o que acontece se a tarefa for interrompida prematuramente. Guarde a última configuração funcional conhecida e uma pequena amostra de aceitação, para que uma alteração possa ser avaliada antes de afetar todo o calendário.

Apify: avalie o «Actor», bem como a plataforma

A Apify organiza a automação em torno de Actors, com serviços de plataforma para armazenamento, agendamento, integrações e monitorização. Uma equipa pode executar um Actor existente ou desenvolver o seu próprio. Isto torna-o um ponto de partida diferente de desenhar um projeto de extração inteiramente num editor visual de ambiente de trabalho. Documentação da plataforma Apify.

A escolha do Actor faz, portanto, parte da decisão relativa ao produto. Analise os seus campos de entrada, o exemplo de saída, as limitações documentadas, a atividade de manutenção e os detalhes de preços. O facto de uma funcionalidade da plataforma existir não significa que todos os Actors apresentem o mesmo comportamento ou devolvam o mesmo esquema de registos.

Os conjuntos de dados da Apify suportam exportações, incluindo JSON, CSV, Excel, XML e JSONL, com acesso através da consola e das APIs. A documentação também descreve os conjuntos de dados como armazenamento apenas de adição e explica que a retenção difere entre conjuntos de dados nomeados e não nomeados. Esses detalhes são importantes quando se planeiam importações e retenção a longo prazo. Documentação dos conjuntos de dados da Apify.

Um projeto-piloto útil inicia uma execução delimitada, identifica o seu conjunto de dados de saída e importa uma amostra para o seu destino real. Preserve o identificador da execução e os parâmetros de entrada com o lote importado. Isso permite-lhe explicar qual a configuração que produziu um registo e evitar confusão entre os resultados de execuções separadas.

Verifique o modelo de tarifação atual do Actor juntamente com a utilização da plataforma. A documentação oficial distingue os modelos de tarifação e refere que a utilização incluída pode variar. Não estime os custos apenas com base na subscrição da plataforma. Documentação sobre preços do Actor.

As aplicações de extração de dados construídas em torno de automação reutilizável podem adaptar-se bem a fluxos de trabalho orientados pela engenharia, mas trata-se de uma avaliação condicional. O seu teste deve demonstrar que o Actor escolhido, o seu esquema e o seu modelo de manutenção se adequam à aplicação que está a construir.

Certifique-se de que as exportações e integrações passam num teste de aceitação

Um logótipo de destino indica que existe uma integração; não determina, no entanto, como os seus registos se comportarão após a importação. Defina o contrato de entrega antes de selecionar a aplicação. Inclua o destino, o esquema, o modelo de atualização, o sinal de conclusão esperado e o procedimento para lidar com execuções parciais.

Escolha de entrega

Boa adequação

Teste antes da adoção

Ficheiro CSV ou folha de cálculo

Revisão por analista e trabalho pontual limitado

Formatação de identificadores, células com várias linhas, delimitadores e valores em falta

JSON ou JSONL

Registos aninhados e integração de aplicações

Tipos de campo, matrizes secundárias, alterações de esquema e limites de registo

Exportação da base de dados

Coleção estruturada recorrente

Comportamento de inserção versus atualização, chaves, tratamento de duplicados e linhas rejeitadas

Entrega em armazenamento na nuvem

Processamento em lote e instantâneos retidos

Nomeação, permissões, sinais de conclusão e retenção

Fluxo de trabalho via API ou webhook

Orquestração automatizada

Autenticação, tentativas de repetição, paginação e notificações repetidas

Estes são testes recomendados, não uma afirmação de que todas as aplicações suportam todas as opções de entrega. Utilize a documentação atual do produto para selecionar a linha aplicável e, em seguida, verifique o comportamento no plano e na configuração reais.

Distinga uma notificação de conclusão de tarefa da prova de que todos os dados esperados chegaram. O seu importador deve comparar o lote entregue com o âmbito solicitado, inspecionar os campos obrigatórios e registar quaisquer linhas rejeitadas. Se um webhook for entregue duas vezes, a segunda notificação não deve criar uma segunda cópia do mesmo lote.

Escolha um modelo de atualização explícito. Um histórico de «apenas adição» preserva as observações ao longo do tempo; um instantâneo de substituição mostra o estado mais recente; um «upsert» atualiza registos utilizando chaves estáveis. Nenhuma opção é universalmente correta. Decida com base na questão a jusante e faça com que o importador aplique essa decisão.

Se a transferência exigir código de pedido personalizado, a comparação de clientes HTTP em Python pode ajudar a sua equipa a escolher a camada de integração. As aplicações de extração de dados reduzem o trabalho de recolha, mas a propriedade e a aceitação dos dados continuam a pertencer à equipa que utiliza os resultados.

Realize um projeto-piloto que inclua a manutenção e o custo total

Atribua a cada aplicação pré-selecionada a mesma tarefa delimitada. Utilize as mesmas fontes, campos obrigatórios, destino e condições de paragem. Inclua uma página normal, uma página com dados opcionais em falta, uma lista de várias páginas e uma página de detalhes com vários valores relacionados. Mantenha o âmbito suficientemente pequeno para que uma pessoa possa inspecionar o resultado completo.

Registe o esforço de configuração separadamente do esforço contínuo. Anote quanto tempo o operador gasta a configurar a navegação, a corrigir associações de campos, a exportar e a limpar o conjunto de dados entregue. Estas observações são mais úteis do que considerar o tempo até à primeira linha visível como o custo total da adoção.

Repita a tarefa utilizando o modo de execução pretendido. Se o plano de produção depender de agendamento na nuvem, uma execução local bem-sucedida não constitui prova suficiente. Se a tarefa continuar a ser manual e ocasional, avalie diretamente o fluxo de trabalho do operador, em vez de adicionar automatização de que a tarefa não necessita.

Introduza um exercício de manutenção realista. Peça a um segundo operador para alterar um campo obrigatório ou diagnosticar uma entrada deliberadamente excluída. Avalie se a configuração, o histórico de execuções e a documentação tornam a causa compreensível. As aplicações de extração de dados podem poupar esforço de codificação, mas continuam a deixar um problema substancial de transferência de conhecimento.

Estime o custo mensal utilizando o número planeado de execuções, o volume de páginas esperado, quaisquer encargos aplicáveis de execução ou resultados, necessidades de exportação e tempo de manutenção humana. Registe quais os valores que provêm da utilização piloto medida e quais permanecem como suposições. Evite projetar um custo universal por registo a partir de um pequeno teste com páginas invulgarmente simples.

Se a aplicação não conseguir expressar a lógica necessária sem uma coleção crescente de exceções, compare a carga de manutenção com um fluxo de trabalho baseado em código. O nosso guia sobre extração de dados com o Scrapy descreve essa alternativa. A decisão deve refletir quem pode manter o sistema e com que frequência o seu comportamento tem de mudar.

Pontos-chave

  • Compare o modelo operacional da aplicação, não apenas o seu editor visual ou o número de funcionalidades.
  • Teste a execução local e na nuvem separadamente quando a entrega recorrente depender da nuvem.
  • Abra as exportações no destino real e verifique os identificadores, os valores aninhados e o tratamento de duplicados.
  • Avalie o projeto específico ou o «Actor» em conjunto com a plataforma que o executa.
  • Inclua a transferência de responsabilidades para o operador, a manutenção e a aceitação a jusante na fase piloto.

Perguntas frequentes

Uma aplicação de scraping pode recolher dados de um PDF digitalizado?

Um scraper de páginas web pode recuperar um link para um PDF sem extrair o conteúdo do documento. As páginas digitalizadas requerem normalmente uma etapa de OCR, e as informações tabulares podem necessitar de processamento adicional do documento. Considere isso como uma capacidade separada a verificar. Inclua PDFs representativos nos seus requisitos, em vez de partir do princípio de que a extração de páginas web abrange automaticamente todos os ficheiros ligados.

Devo recolher todos os campos que uma aplicação deteta?

Não. Recolha os campos necessários para o objetivo definido e documente a razão pela qual cada um é necessário. Os campos adicionais aumentam o trabalho de limpeza, armazenamento e revisão e podem introduzir informações que a sua equipa não pretendia tratar. Remova os campos desnecessários da configuração e do esquema a jusante, para que não reapareçam despercebidos em execuções posteriores.

Posso utilizar a mesma aplicação para vários idiomas?

Possivelmente, mas teste cada idioma e localização relevantes com páginas reais. Os rótulos dos campos, os formatos numéricos, os formatos de data e a direção de leitura podem diferir, mesmo quando o site utiliza um layout partilhado. Preserve os valores originais a par dos campos normalizados quando a ambiguidade for relevante. Considere uma execução bem-sucedida em inglês como prova para essa amostra, e não para todas as versões localizadas.

Escolha o fluxo de trabalho que pode manter em funcionamento

Comece com dois candidatos cujos modelos operacionais correspondam à sua equipa. Atribua-lhes a mesma tarefa simples e avalie o resultado entregue, a execução repetida e o exercício de manutenção. Tome notas sobre o trabalho manual que permanece após a aplicação indicar sucesso. Esse é o trabalho de que a sua equipa se encarregará ao longo do tempo.

Um projeto em ambiente de trabalho pode ser adequado para tarefas ocasionais de análise. Um fluxo de trabalho na nuvem pode fazer sentido quando a execução deve continuar independentemente do computador de um operador. Uma plataforma baseada em atores pode adequar-se a uma integração de aplicações mais abrangente. Estas escolhas são úteis quando se alinham com a tarefa real e com as pessoas responsáveis pela sua manutenção.

Se já dispõe de lógica de aplicação e o componente em falta é a recuperação fiável de páginas, avalie a API Scraper da WebScrapingAPI como uma alternativa baseada em API. Baseie a comparação nas mesmas páginas de origem, nos campos obrigatórios e nas verificações de aceitação. Selecione o caminho que produza dados rastreáveis e utilizáveis com uma carga operacional que a sua equipa consiga suportar.

Sobre o autor

Mihnea-Octavian Manolache, Desenvolvedor Full Stack @ WebScrapingAPI

Mihnea-Octavian Manolache

Desenvolvedor Full Stack

Mihnea-Octavian Manolache é engenheiro Full Stack e DevOps na WebScrapingAPI, onde desenvolve funcionalidades do produto e mantém a infraestrutura que garante o bom funcionamento da plataforma.

Web Scraping com AWS Lambda: Guia para Python e Java 2026
Guias

Web Scraping com AWS Lambda: Guia para Python e Java 2026

TL;DR: Resumo: A extração de dados da Web com o AWS Lambda funciona melhor quando cada invocação é curta, delimitada e pode ser repetida de forma independente. Comece com HTTP direto, AWS SAM e S3 e, só depois, adicione SQS, contentores, renderização no navegador, proxies ou uma camada de recuperação gerida, apenas quando a carga de trabalho demonstrar que precisa deles.

Suciu Dan32 min read
Ler artigo
Como utilizar o GoSpider: rastrear, limpar URLs e extrair dados
Guias

Como utilizar o GoSpider: rastrear, limpar URLs e extrair dados

TL;DR: Resumo: O GoSpider é um rastreador de linha de comandos destinado a descobrir URLs, não um extrator completo de dados estruturados. Este guia sobre como utilizar o GoSpider mostra como realizar um rastreio limitado, gerir resultados de forma organizada, fazer a transferência de dados do Colly para CSV e seguir um percurso de diagnóstico para respostas 403 ou páginas que exijam renderização em JavaScript.

Suciu Dan23 min read
Ler artigo
Como fazer o Scrape Redfin: Guia Python para Dados de Propriedade
Guias

Como fazer o Scrape Redfin: Guia Python para Dados de Propriedade

TL;DR: A Redfin expõe pontos de extremidade de API ocultos que retornam JSON estruturado para listagens de propriedades, tornando possível ignorar totalmente a análise HTML frágil. Este guia orienta-o na construção de um scraper Python que extrai dados de aluguer e venda, pesquisa por localização, monitoriza novas listagens através de sitemaps XML e exporta resultados limpos para CSV ou JSON.

Suciu Dan14 min read
Ler artigo

Comece a construir

Pronto para expandir a sua recolha de dados?

Junte-se a mais de 2.000 empresas que utilizam a WebScrapingAPI para extrair dados da Web à escala empresarial, sem quaisquer custos de infraestrutura.
