Saltar para o conteúdo
Comece grátis
Voltar ao blogue

Como lidar com URLs de redirecionamento do Google /goto e tokens CAES num scraper de SERP

Suciu DanÚltima atualização em 13 min read
Como lidar com URLs de redirecionamento do Google /goto e tokens CAES num scraper de SERP
Resumo: Os URLs /goto do Google com um token CAES, e os wrappers /url mais antigos, são camadas de redirecionamento, não destinos, por isso um scraper de SERP que trata cada href como final estraga o acompanhamento de posições e as bases de links. Prefira uma API de SERP estruturada quando devolve os links de destino. Quando tiver de analisar HTML, classifique cada href, elimine redirecionamentos duplicados e resolva-os com um GET simples. Não desencripte o CAES.

A Pesquisa do Google pode inserir um redirecionamento opaco entre um resultado da SERP e o destino. Em vez de https://example.com/page no href, poderá ver https://www.google.com/goto?url=CAES...—ou um /url que contenha o mesmo tipo de token. Para os utilizadores, um clique continua a direcioná-los para o site correto. Para um scraper que trate cada href como definitivo, isso compromete o acompanhamento de classificações, os registos de links externos e os rastreios a jusante.

Trata-se de um pipeline de URLs de produção, não de um artigo sobre criptografia. Dá preferência a uma API estruturada do Google Search (SERP) quando esta devolver links de destino. Quando for necessário analisar HTML, classifica cada href, elimine redirecionamentos duplicados, resolva com um GETe monitorizar falhas. Não descodifique CAES.

Pontos-chave

  • Trate /goto?url=CAES... e /url?... como camadas de redirecionamento, não como destinos.
  • Não descodifique CAES. Resolva com GET e allow_redirects=False, depois ler Location.
  • Preferir o Caminho A: JSON estruturado da API SERP da WebScrapingAPI quando os link são destinos.
  • Utilize a Opção B: API do Scraper ou API do Navegador (apenas HTML) quando precisar de código-fonte bruto — depois classifique → elimine duplicados → resolva.
  • HTTP 200 não é uma SERP utilizável. Valide os contentores de resultados antes da análise.
  • Desduplique /goto dentro de uma mesma página; reutilize ligações; limite a concorrência.
  • Armazene uma impressão digital do pedido (consulta, gl, hl, device, domínio, hora) com cada observação.
  • O formato de ligação do Google não é um contrato permanente. Conceba para URLs diretas, /gotoe /url.

O que o Google /goto é (e em que difere de /url )

/goto é (e em que difere de /url)

Historicamente, os scrapers costumavam ler o destino diretamente da âncora orgânica. Hoje, o mesmo resultado conceptual pode apresentar-se de várias formas:

Forma

Padrão de exemplo

O que fazer

Destino direto

https://example.com/page

Utilizar tal como está

/goto + CAES

https://www.google.com/goto?url=CAES...

Resolver através de GET → Location

/url wrapper

https://www.google.com/url?...&url=CAES... ou variantes url= / q= variantes

Classifique separadamente; resolva ou analise os parâmetros com cuidado

Outros servidores/caminhos do Google

Maps, contas, Chrome interno

Ignorar ou tratar fora do pipeline orgânico

/goto é um ponto final de redirecionamento alojado pelo Google. O url valor da consulta começa frequentemente com CAES—não porque «CAES» seja um nome de produto, mas porque é assim que um envelope binário comum fica após a codificação Base64URL. Ao abrir o link, solicita-se ao Google um redirecionamento para o destino real.

/url é um caminho de redirecionamento mais antigo (e ainda utilizado) do Google. Segundo relatos, alguns clientes recebem /url com uma CAES carga útil em vez de um destino em texto simples. A regra do scraper é a mesma em ambos os casos: classifique o link e, em seguida, mantenha um destino direto ou resolva o invólucro. Não presuma que os tokens opacos só aparecem em /goto.

O Google descreveu as camadas de redirecionamento como parte das medidas técnicas contra o abuso crescente da Pesquisa. A lógica exata de implementação não é de domínio público. Desenvolva para vários formatos.

Será mesmo necessário extrair HTML?

A maioria das tarefas de acompanhamento de posições e monitorização de SERP em produção requer URLs de destino + títulos + snippets + posições, e não o HTML de apresentação do Google. Escolha primeiro o caminho do produto.

Caminho A — API da SERP (preferível quando os destinos estão em JSON)

Envie uma consulta contextual do Google para o endpoint SERP da WebScrapingAPI e leia as coleções analisadas:

  • Ponto de extremidade: https://serpapi.webscrapingapi.com/v2
  • Obrigatório: api_key, engine=google, q
  • Controlos opcionais comuns: device, domain, uule, hl, gl, start, num, tbm, ibp
  • Alternativa assíncrona: engine=google_async, e, em seguida, recupere através da API Snapshot

Páginas do produto: API SERP · API
de Pesquisa do Google Documentação: Aceder à API · Motor de pesquisa do Google

O que a documentação pública mostra atualmente: os exemplos de resultados orgânicos utilizam link campos que se assemelham a URLs de destino final (por exemplo https://www.history.com/ ou https://en.wikipedia.org/wiki/History), e não google.com/goto envolturas. A documentação dos campos descreve link como sendo a URL de destino.

Verifique o link campo na sua própria resposta em tempo real:

  • Antes de se basear apenas no Caminho A, analise os link de uma consulta SERP antiga na sua conta.
  • Documentos públicos mostram exemplos que parecem indicar o destino link ; se as tuas respostas de produção em tempo real incluem algum resultado em /goto é algo que só a sua própria amostra poderá determinar — não tire conclusões precipitadas com base neste artigo.

Repare também na dupla nomenclatura do esquema de documentação: algumas páginas apresentam um organic matriz (link, display_link, rank), enquanto o documento sobre resultados orgânicos apresenta organic_results (link, displayed_link, position). Ambos os documentos link como destino. Analise de forma cautelosa ambas as formas e valide com base numa resposta em tempo real.

Caminho B — API de scraper / API do navegador HTML (quando for necessário analisar a página)

Utilize HTML quando precisar de seletores personalizados, análise de layout ou um fluxo de trabalho que o motor de SERP estruturado não abranja:

  • API do Scraper: https://api.webscrapingapi.com/v2 com api_key + url
  • Set render_js=1 quando o alvo necessitar de JavaScript do lado do cliente antes de receber o corpo da página
  • API do navegador: quando precisar de tempos de espera documentados, interações ou controlos do estado do navegador

Valide uma SERP utilizável. Um HTTP 200 pode ainda ser um intersticial, uma janela de consentimento, um CAPTCHA ou uma janela de «ativar JavaScript». Antes de extrair links, verifique se existem contentores de resultados reconhecíveis (por exemplo, âncoras sob #rso / #searchou marcadores equivalentes que utilize). Se a validação falhar, tente novamente com a renderização, ajuste o contexto de localização/dispositivo ou recorra ao Caminho A — não armazene silenciosamente classificações vazias.

Depois de extrair /goto URLs do HTML, resolva-as com HTTP simples (ver abaixo). Geralmente, não é necessário outro crédito de rastreamento renderizado por cada link orgânico.

Como resolver /goto (codificar antecipadamente)

/goto (codificar antecipadamente)

A resolução é o cerne do Caminho B — e uma rede de segurança caso algum wrapper venha a aparecer na saída estruturada.

import requests

def resolve_google_goto(url: str, timeout: float = 10.0) -> str:
    """Resolve a Google /goto (or similar) redirect without following to the destination site."""
    response = requests.get(
        url,
        allow_redirects=False,
        timeout=timeout,
        headers={"User-Agent": "Mozilla/5.0"},
    )
    if response.status_code != 302:
        raise RuntimeError(f"Expected 302, got {response.status_code} for {url[:80]}...")
    location = response.headers.get("Location")
    if not location:
        raise RuntimeError("Redirect response has no Location header")
    return location  # keep full value, including #:~:text= fragments when present

Regras importantes em produção:

  1. allow_redirects=False — o que se pretende é o URL do Google Location, e não um segundo salto para o editor.
  2. Prefira GET em vez de HEAD. Relatórios públicos indicam que HEAD pode devolver 200 sem um Location cabeçalho, enquanto GET retorna 302 com o destino. Considere isto como uma orientação do setor; confirme o comportamento de HEAD vs GET num /goto do seu próprio pipeline antes de codificar o método de forma rígida.
  3. Mantenha Location intacto. O Google pode devolver fragmentos de texto, tais como #:~:text=.... Remova-os apenas se o seu produto necessitar explicitamente de URLs canónicas.
  4. Resolva fora da API de scraping quando o token for portátil — recolha através do HTML do Scraper/Navegador e resolva com uma sessão de cliente normal.

Padrão cURL mínimo:

curl -sS -o /dev/null -D - \
  "https://www.google.com/goto?url=CAES..." \
  | grep -i '^location:'

Não utilize -L se precisar apenas do destino do redirecionamento.

Classifique cada href

href

Nunca construa o analisador em torno da substring CAES por si só. Classifique primeiro o URL absoluto:

from urllib.parse import parse_qs, urljoin, urlparse

GOOGLE_BASE_URL = "https://www.google.com/"

def is_google_host(host: str) -> bool:
    host = (host or "").lower()
    return host == "google.com" or host.endswith(".google.com")

def classify_google_link(href: str) -> tuple[str, str]:
    absolute = urljoin(GOOGLE_BASE_URL, href)
    parsed = urlparse(absolute)
    host = parsed.hostname or ""

    if is_google_host(host) and parsed.path == "/goto":
        token = parse_qs(parsed.query).get("url", [""])[0]
        if token.startswith("CAES"):
            return "goto", absolute
        return "goto", absolute  # still a /goto wrapper even if token shape changes

    if is_google_host(host) and parsed.path == "/url":
        return "google_url", absolute

    if parsed.scheme in {"http", "https"} and not is_google_host(host):
        return "direct", absolute

    return "other", absolute

Tratamento sugerido:

Tipo

Ação

direct

Manter

goto

Desduplicar → resolver → manter Location

google_url

Resolver ou analisar chaves de consulta conhecidas; não assumir texto simples

other

Eliminar de destinos orgânicos (ou encaminhar para um manipulador separado)

Pipeline de produção: deduplicação, concorrência, erros, impressão digital

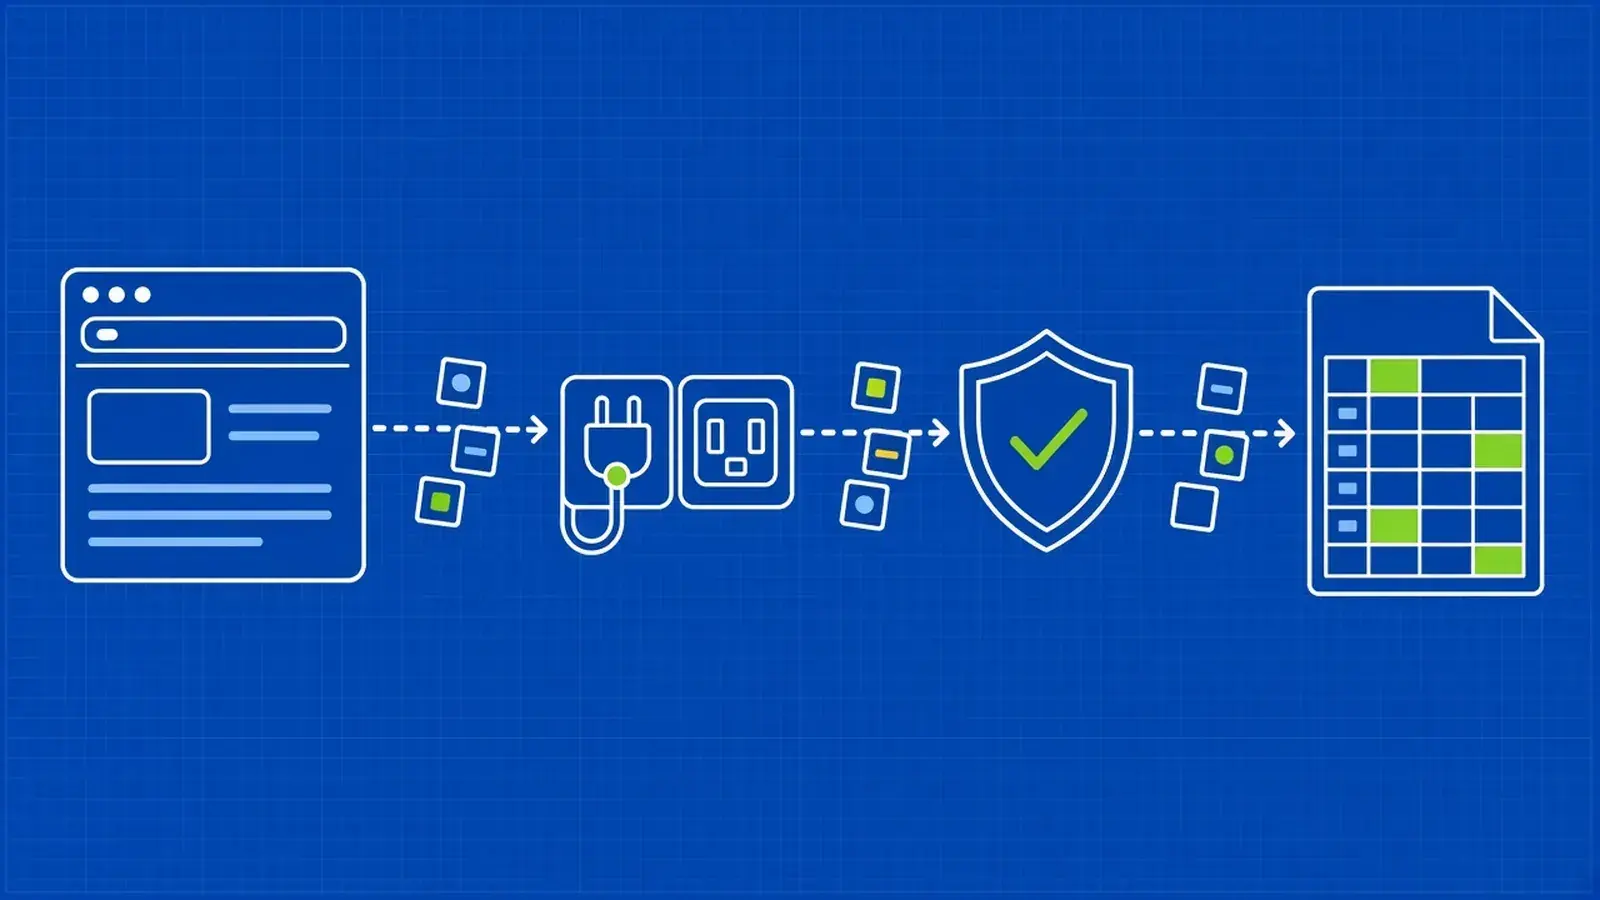
Pipeline HTML → URL:

SERP fetch (SERP API JSON or Scraper/Browser HTML)
        ↓
validate usable payload (JSON modules or SERP DOM)
        ↓
extract candidate hrefs / link fields
        ↓
classify → direct | goto | google_url | other
        ↓
dedupe wrappers (same token often repeats in one SERP)
        ↓
resolve with GET, bounded concurrency, connection reuse
        ↓
merge destinations + store request fingerprint + outcome codes

Desduplicar antes de resolver

Uma página de resultados de pesquisa (SERP) repete frequentemente o mesmo /goto token no título e nas âncoras dos links do site. Resolver todas as âncoras desperdiça pedidos. Preservar a ordem ao tornar único:

unique_goto_urls = list(dict.fromkeys(goto_urls))

Concorrência limitada e reutilização de ligações

Utilize um pequeno conjunto de trabalhadores e um requests.Session por trabalhador, para que o TCP/TLS possa ser reutilizado. O número exato de trabalhadores depende do ambiente — ajuste-o de acordo com a sua latência e taxas de erro, em vez de copiar os valores de referência de outro fornecedor.

Taxonomia de erros (implemente-os)

Código / classe

Significado

Tratamento sugerido

http_non_302

Estado inesperado de /goto

Contagem; URL de amostra; recuar se 429/5xx

missing_location

302 sem Location

Falha nesse resultado; não invente um URL

timeout / rede

Transitório

Refaça a tentativa com recuo com jitter

invalid_token

Falha persistente para um token

Marcar como falha; não tentar novamente nunca mais

serp_unusable

200 O corpo não é um SERP

Corrija o caminho de obtenção (render_js, escolha do produto) antes de analisar

wrapper_unresolved

/url caminho que ainda não é suportado

Colocar na fila para revisão; não baixar classificações silenciosamente sem uma métrica

Armazene uma «impressão digital» da observação

Os dados comparáveis da SERP necessitam de contexto para além dos URLs:

  • q, gl, hl, device, domain, uule (se utilizado), start, num, tbm/ibp
  • data e hora da observação e versão do esquema
  • Caminho de obtenção (serp_api vs scraper_html vs browser_html)
  • Contagens: direta / goto / google_url / resolvida / falhada

Isso está em consonância com as orientações da WebScrapingAPI sobre dados web responsáveis: preservar o contexto da observação para que as equipas a jusante possam interpretar cada registo.

Quando é que o Google devolve /goto ?

/goto?

Resposta curta: trate isto como condicional, não como uma regra fixa.

Artigos de terceiros (incluindo a análise aprofundada da ScrapingBee de setembro de 2026) relataram /goto no Chrome e no Edge operados manualmente, em sessões do Playwright e em HTML obtido através de APIs de scraping, enquanto alguns navegadores orientados para a privacidade ainda mostravam destinos diretos e o Safari, por vezes, mostrava /url com CAES. Trata-se de observações relatadas por concorrentes, não de novas execuções da WebScrapingAPI, e não constituem um compromisso do Google. As alterações de IP ou de país, por si só, foram consideradas insuficientes para forçar links diretos nesses testes — mais uma vez, avalie com cuidado e não extrapole.

Pressupostos seguros de produção:

  • A automatização não é o único fator desencadeante.
  • O motor do navegador, por si só, não é um fator determinante fiável.
  • A geolocalização, por si só, não é um fator fiável.
  • O seu scraper deve aceitar links diretos, /gotoe /url ao longo do tempo.

Se precisares de uma matriz de navegadores para a tua própria estratégia de conformidade, realiza um pequeno teste interno e data-o — não publiques regras não verificadas como se fossem factos.

O que contém um CAES token? (apêndice breve)

CAES token? (apêndice breve)

Não precisa desta secção para lançar um scraper funcional. Ela existe para que as equipas deixem de desperdiçar tempo em becos sem saída.

A um nível geral, as análises do setor descrevem:

  1. A descodificação Base64URL do CAES... parâmetro → binário
  2. Um envelope compacto semelhante ao protobuf (normalmente um campo constante mais um blob delimitado pelo comprimento)
  3. Uma carga útil protegida cujos bytes externos se assemelham a um prefixo de saída de uma biblioteca de criptografia
  4. Nenhum destino de texto simples recuperável para fins práticos de scraping

Política de «resolver primeiro»: descodifique por curiosidade ou para investigação de malware, se for necessário; para produtos SERP, chame /goto e leia Location. Tentar reverter o blob protegido é o problema errado.

Percurso de ponta a ponta A — API SERP

Python:

import os
import requests

api_key = os.environ["WSA_API_KEY"]

response = requests.get(
    "https://serpapi.webscrapingapi.com/v2",
    params={
        "api_key": api_key,
        "engine": "google",
        "q": "best trail shoes",
        "gl": "us",
        "hl": "en",
        "device": "mobile",
    },
    timeout=120,
)
response.raise_for_status()
payload = response.json()

# Docs may use organic or organic_results — support both.
organic = payload.get("organic") or payload.get("organic_results") or []

for row in organic:
    link = row.get("link")
    title = row.get("title")
    # Check link on your live response; if it looks like google.com/goto or /url, classify + resolve.
    print(title, "→", link)

Node.js:

const apiKey = process.env.WSA_API_KEY;
if (!apiKey) throw new Error("WSA_API_KEY is required");

const parameters = new URLSearchParams({
  api_key: apiKey,
  engine: "google",
  q: "best trail shoes",
  gl: "us",
  hl: "en",
  device: "mobile",
});

const response = await fetch(
  "https://serpapi.webscrapingapi.com/v2?" + parameters,
  { signal: AbortSignal.timeout(120_000) }
);
if (!response.ok) {
  throw new Error("Google Search API status " + response.status);
}
const payload = await response.json();
const organic = payload.organic || payload.organic_results || [];
for (const row of organic) {
  console.log(row.title, "→", row.link);
}

cURL:

: "${WSA_API_KEY:?WSA_API_KEY is required}"
curl --get --fail-with-body --max-time 120 \
  "https://serpapi.webscrapingapi.com/v2" \
  --data-urlencode "api_key=$WSA_API_KEY" \
  --data-urlencode "engine=google" \
  --data-urlencode "q=best trail shoes" \
  --data-urlencode "gl=us" \
  --data-urlencode "hl=en" \
  --data-urlencode "device=mobile"

Para cargas de trabalho em fila, utilize engine=google_async e o fluxo de recuperação de Snapshots documentado, em vez de bloquear no motor síncrono.

Percurso de ponta a ponta B — HTML → classificar → resolver

from __future__ import annotations

import os
import threading
from concurrent.futures import ThreadPoolExecutor
from urllib.parse import urlencode

import requests
from bs4 import BeautifulSoup

# reuse classify_google_link + resolve_google_goto from earlier sections

SCRAPER_API = "https://api.webscrapingapi.com/v2"
GOOGLE_SEARCH = "https://www.google.com/search"
_thread_local = threading.local()


def fetch_google_html(query: str, api_key: str) -> str:
    target = GOOGLE_SEARCH + "?" + urlencode({"q": query, "hl": "en"})
    response = requests.get(
        SCRAPER_API,
        params={
            "api_key": api_key,
            "url": target,
            "render_js": "1",  # enable when Google returns a JS shell instead of a SERP
        },
        timeout=120,
    )
    response.raise_for_status()
    return response.text


def assert_usable_serp(html: str) -> None:
    soup = BeautifulSoup(html, "html.parser")
    if not soup.select("#rso a[href], #search a[href]"):
        raise RuntimeError("No recognizable Google search results found (unusable SERP body)")


def extract_links(html: str) -> tuple[list[str], list[str], list[str]]:
    soup = BeautifulSoup(html, "html.parser")
    direct, goto, google_url = [], [], []
    for anchor in soup.select("#rso a[href], #search a[href]"):
        href = anchor.get("href") or ""
        kind, url = classify_google_link(href)
        if kind == "direct":
            direct.append(url)
        elif kind == "goto":
            goto.append(url)
        elif kind == "google_url":
            google_url.append(url)
    return direct, goto, google_url


def get_worker_session() -> requests.Session:
    session = getattr(_thread_local, "session", None)
    if session is None:
        session = requests.Session()
        _thread_local.session = session
    return session


def resolve_goto(url: str) -> tuple[str, str | None]:
    session = get_worker_session()
    try:
        response = session.get(url, allow_redirects=False, timeout=10)
    except requests.RequestException:
        return url, None
    if response.status_code != 302:
        return url, None
    return url, response.headers.get("Location")


def resolve_many(urls: list[str], workers: int = 5) -> dict[str, str]:
    unique_urls = list(dict.fromkeys(urls))
    with ThreadPoolExecutor(max_workers=workers) as executor:
        results = executor.map(resolve_goto, unique_urls)
    return {src: dest for src, dest in results if dest}


def main() -> None:
    api_key = os.environ["WSA_API_KEY"]
    html = fetch_google_html("best trail shoes", api_key)
    assert_usable_serp(html)

    direct, goto, google_url = extract_links(html)
    direct = list(dict.fromkeys(direct))
    goto = list(dict.fromkeys(goto))

    resolved = resolve_many(goto, workers=5)
    # Optionally add handlers for google_url wrappers here.

    destinations = list(dict.fromkeys(direct + list(resolved.values())))
    for url in destinations:
        print(url)

    # Persist fingerprint + counts in your store:
    # path=scraper_html, q, hl, render_js=1, n_direct, n_goto, n_resolved, n_failed


if __name__ == "__main__":
    main()

Instalação: pip install requests beautifulsoup4. Mantenha WSA_API_KEY no ambiente — nunca o codifique diretamente.

Utilização responsável

Os URLs públicos das SERP continuam a ser dados da Web. Antes de expandir a recolha:

  1. Defina o objetivo comercial (monitorização de posições, visibilidade da concorrência, pesquisa).
  2. Defina o âmbito das fontes públicas (domínios do Google, mercados, dispositivos, exclusões).
  3. Mantenha um registo mínimo útil — nem todos os campos são apresentados pelo Google.
  4. Designe responsáveis a jusante pelo acesso, retenção e tomadas de decisão.
  5. Preserve o contexto de observação para que os resultados permaneçam interpretáveis.

Leia o resumo operacional da WebScrapingAPI: Dados da Web responsáveis. A sua equipa é responsável pela finalidade, pelo âmbito da fonte e pela utilização a jusante; a WebScrapingAPI opera o caminho da API selecionado. Este artigo não constitui aconselhamento jurídico nem um guia para contornar controlos de segurança — trata-se de um fluxo prático de tratamento de URLs para observação legítima de pesquisas públicas.

Perguntas frequentes

Preciso de descodificar CAES os tokens?

CAES os tokens?

Não. Para a recolha de dados e o acompanhamento de classificações, GET o /goto URL com redirecionamentos desativados e a leitura Location. A descodificação local de Base64URL/protobuf não resulta num destino prático em texto simples.

Devo utilizar HEAD para resolver /goto ?

HEAD para resolver /goto?

Prefiro GET. Relatórios públicos indicam que HEAD pode devolver 200 sem Location enquanto GET retorna 302 com o destino. Confirme HEAD vs GET num /goto do seu próprio pipeline antes de definir o comportamento do cliente.

Qual é a diferença entre /goto e /url ?

/goto e /url?

Ambos são pontos finais de redirecionamento do Google que podem situar-se entre a SERP e o destino. /goto normalmente inclui um CAES... url parâmetro. /url é um wrapper de estilo mais antigo que ainda pode aparecer (por vezes com tokens opacos). Classifique ambos; resolva o que não conseguir analisar como um destino direto.

Devo usar a API da SERP ou extrair o HTML do Google?

Dá preferência à API da SERP da Pesquisa do Google quando os resultados orgânicos estruturados corresponderem ao teu esquema — menor fragilidade do HTML, impressão digital da solicitação mais clara. Usa a API do Scraper ou a API do Navegador quando precisares de marcação bruta ou interação personalizada. Os exemplos da documentação mostram link ; verifica o link campo na sua própria resposta em tempo real e registe a data antes de assumir o formato ao abrigo da /goto lançamento do Google.

Os CAES os tokens expiram?

CAES os tokens expiram?

Relatórios de terceiros sugerem que os tokens podem permanecer ativos durante mais de um dia e podem funcionar fora da sessão original do navegador. O tempo de vida máximo é desconhecido. Trate-os como redirecionamentos temporários opacos, não como IDs permanentes. (Informação fornecida por concorrentes; não verificada aqui.)

O Playwright (ou a automação) causa /goto ?

/goto?

Não de forma fiável como causa única. Testes relatados pela concorrência observaram /goto tanto no Chrome manual como no Chromium automatizado. Não incorpore a regra «Playwright = /goto, Brave = direto» na lógica de produção.

Os tokens estão ligados a cookies, ao IP ou à sessão de scraping?

Relatórios do setor descrevem tokens que poderiam ser recolhidos num ambiente e resolvidos posteriormente com um cliente HTTP simples. Útil para separar a obtenção de HTML da resolução de redirecionamentos — mas não é uma garantia para todas as variantes futuras de tokens. Monitorize as falhas.

Por que razão é que a Google está a utilizar /goto ?

/goto?

O Google enquadrou as medidas de redirecionamento como parte da proteção da Pesquisa contra abusos em constante evolução. A lógica exata de seleção não é totalmente pública. Do ponto de vista de um scraper, os destinos já não são sempre texto simples em HTML.

200 mas não tiver links orgânicos?

Trate-a como um corpo de SERP inutilizável. Ative render_js=1 quando for adequado, confirme o URL de destino e a localização, ou mude para a API de SERP estruturada. Nunca confie apenas nos códigos de estado.

Como devo armazenar os resultados para comparações de classificações?

Armazene os destinos com a impressão digital do pedido (q, gl, hl, device, domínio, deslocamentos, caminho de obtenção, carimbo de data/hora). Isso está de acordo com as práticas de observação responsáveis e evita falsas «alterações de classificação» causadas pela mistura de localizações ou dispositivos.

Próximos passos

  1. Chame o motor síncrono do Google em https://serpapi.webscrapingapi.com/v2 com api_key, engine=google, e q.
  2. Inspecione os link numa resposta em tempo real da sua conta e registe a data.
  3. Se optar por continuar a utilizar HTML, execute a classificação → deduplicação → resolução antes de expandir o volume de palavras-chave.
  4. Analise os dados da Web responsáveis com os responsáveis pelos dados.

Comece com a API de Pesquisa do Google, compare motores da API SERP ou recupere o HTML da página através da API Scraper / API do Navegador quando os resultados estruturados não forem suficientes.

Sobre o autor

Suciu Dan, Co-fundador @ WebScrapingAPI

Suciu Dan

Co-fundador

Suciu Dan é cofundador da WebScrapingAPI e escreve guias práticos, voltados para programadores, sobre web scraping em Python, web scraping em Ruby e infraestruturas de proxy.

Tutorial de Python do Nodriver: Extração discreta de dados da Web — Do primeiro script à produção
A ciência da extração de dados da Web

Tutorial de Python do Nodriver: Extração discreta de dados da Web — Do primeiro script à produção

TL;DR: Resumo: O Nodriver é uma biblioteca Python assíncrona que controla o Chromium através do Chrome DevTools Protocol, sem Selenium nem o binário chromedriver. Utilize-o quando um navegador furtivo auto-hospedado, mais próximo de uma sessão real do Chrome, é melhor do que uma stack WebDriver, mas saiba que, por si só, não elimina riscos de IP, TLS ou comportamento. Este tutorial vai de um primeiro script à produção em contentores e a uma Browser API alojada.

Suciu Dan15 min read
Ler artigo
Cabeçalhos de resposta HTTP no cURL: Cada flag, técnica e receita de scripting
A ciência da extração de dados da Web

Cabeçalhos de resposta HTTP no cURL: Cada flag, técnica e receita de scripting

TL;DR: O cURL esconde os cabeçalhos de resposta por padrão. Use -i para ver os cabeçalhos junto com o corpo, -I para uma solicitação HEAD que retorna apenas cabeçalhos, -v para depuração completa de solicitação/resposta e -D para salvar cabeçalhos em um arquivo. Para scripts modernos, o cURL 7.83+ permite extrair cabeçalhos individuais ou despejar todos eles como JSON com a opção -w write-out.

Suciu Dan12 min read
Ler artigo
O que é um navegador sem cabeça? Arquitetura, casos de utilização e principais ferramentas
A ciência da extração de dados da Web

O que é um navegador sem cabeça? Arquitetura, casos de utilização e principais ferramentas

TL;DR: Um navegador sem cabeça é um navegador web que funciona sem uma interface gráfica visível, controlado inteiramente através de código ou instruções de linha de comando. Os desenvolvedores usam navegadores headless para testes automatizados, raspagem da Web, monitoramento de desempenho e, cada vez mais, para alimentar agentes de IA. Este guia aborda como eles funcionam internamente, quando escolher um em vez de um navegador normal e quais estruturas valem o seu tempo.

Suciu Dan15 min read
Ler artigo

Comece a construir

Pronto para expandir a sua recolha de dados?

Junte-se a mais de 2.000 empresas que utilizam a WebScrapingAPI para extrair dados da Web à escala empresarial, sem quaisquer custos de infraestrutura.