Saltar para o conteúdo
Comece grátis

Blog · Artigos

A ciência da extração de dados da Web

Análises técnicas aprofundadas sobre os fundamentos científicos por trás do rastreamento, da análise sintática, dos sistemas anti-bot e dos desafios de engenharia da extração de dados à escala da Web.

Artigos publicados

34

Artigos

A ciência da extração de dados da Web

34 artigos

Tutorial de Python do Nodriver: Extração discreta de dados da Web — Do primeiro script à produção
A ciência da extração de dados da Web

Tutorial de Python do Nodriver: Extração discreta de dados da Web — Do primeiro script à produção

TL;DR: Resumo: O Nodriver é uma biblioteca Python assíncrona que controla o Chromium através do Chrome DevTools Protocol, sem Selenium nem o binário chromedriver. Utilize-o quando um navegador furtivo auto-hospedado, mais próximo de uma sessão real do Chrome, é melhor do que uma stack WebDriver, mas saiba que, por si só, não elimina riscos de IP, TLS ou comportamento. Este tutorial vai de um primeiro script à produção em contentores e a uma Browser API alojada.

Suciu Dan15 min read
Ler artigo
Como lidar com URLs de redirecionamento do Google /goto e tokens CAES num scraper de SERP
A ciência da extração de dados da Web

Como lidar com URLs de redirecionamento do Google /goto e tokens CAES num scraper de SERP

TL;DR: Resumo: Os URLs /goto do Google com um token CAES, e os wrappers /url mais antigos, são camadas de redirecionamento, não destinos, por isso um scraper de SERP que trata cada href como final estraga o acompanhamento de posições e as bases de links. Prefira uma API de SERP estruturada quando devolve os links de destino. Quando tiver de analisar HTML, classifique cada href, elimine redirecionamentos duplicados e resolva-os com um GET simples. Não desencripte o CAES.

Suciu Dan13 min read
Ler artigo
Cabeçalhos de resposta HTTP no cURL: Cada flag, técnica e receita de scripting
A ciência da extração de dados da Web

Cabeçalhos de resposta HTTP no cURL: Cada flag, técnica e receita de scripting

TL;DR: O cURL esconde os cabeçalhos de resposta por padrão. Use -i para ver os cabeçalhos junto com o corpo, -I para uma solicitação HEAD que retorna apenas cabeçalhos, -v para depuração completa de solicitação/resposta e -D para salvar cabeçalhos em um arquivo. Para scripts modernos, o cURL 7.83+ permite extrair cabeçalhos individuais ou despejar todos eles como JSON com a opção -w write-out.

Suciu Dan12 min read
Ler artigo
O que é um navegador sem cabeça? Arquitetura, casos de utilização e principais ferramentas
A ciência da extração de dados da Web

O que é um navegador sem cabeça? Arquitetura, casos de utilização e principais ferramentas

TL;DR: Um navegador sem cabeça é um navegador web que funciona sem uma interface gráfica visível, controlado inteiramente através de código ou instruções de linha de comando. Os desenvolvedores usam navegadores headless para testes automatizados, raspagem da Web, monitoramento de desempenho e, cada vez mais, para alimentar agentes de IA. Este guia aborda como eles funcionam internamente, quando escolher um em vez de um navegador normal e quais estruturas valem o seu tempo.

Suciu Dan15 min read
Ler artigo
Scrapy vs Selenium: Quem ganha?
A ciência da extração de dados da Web

Scrapy vs Selenium: Quem ganha?

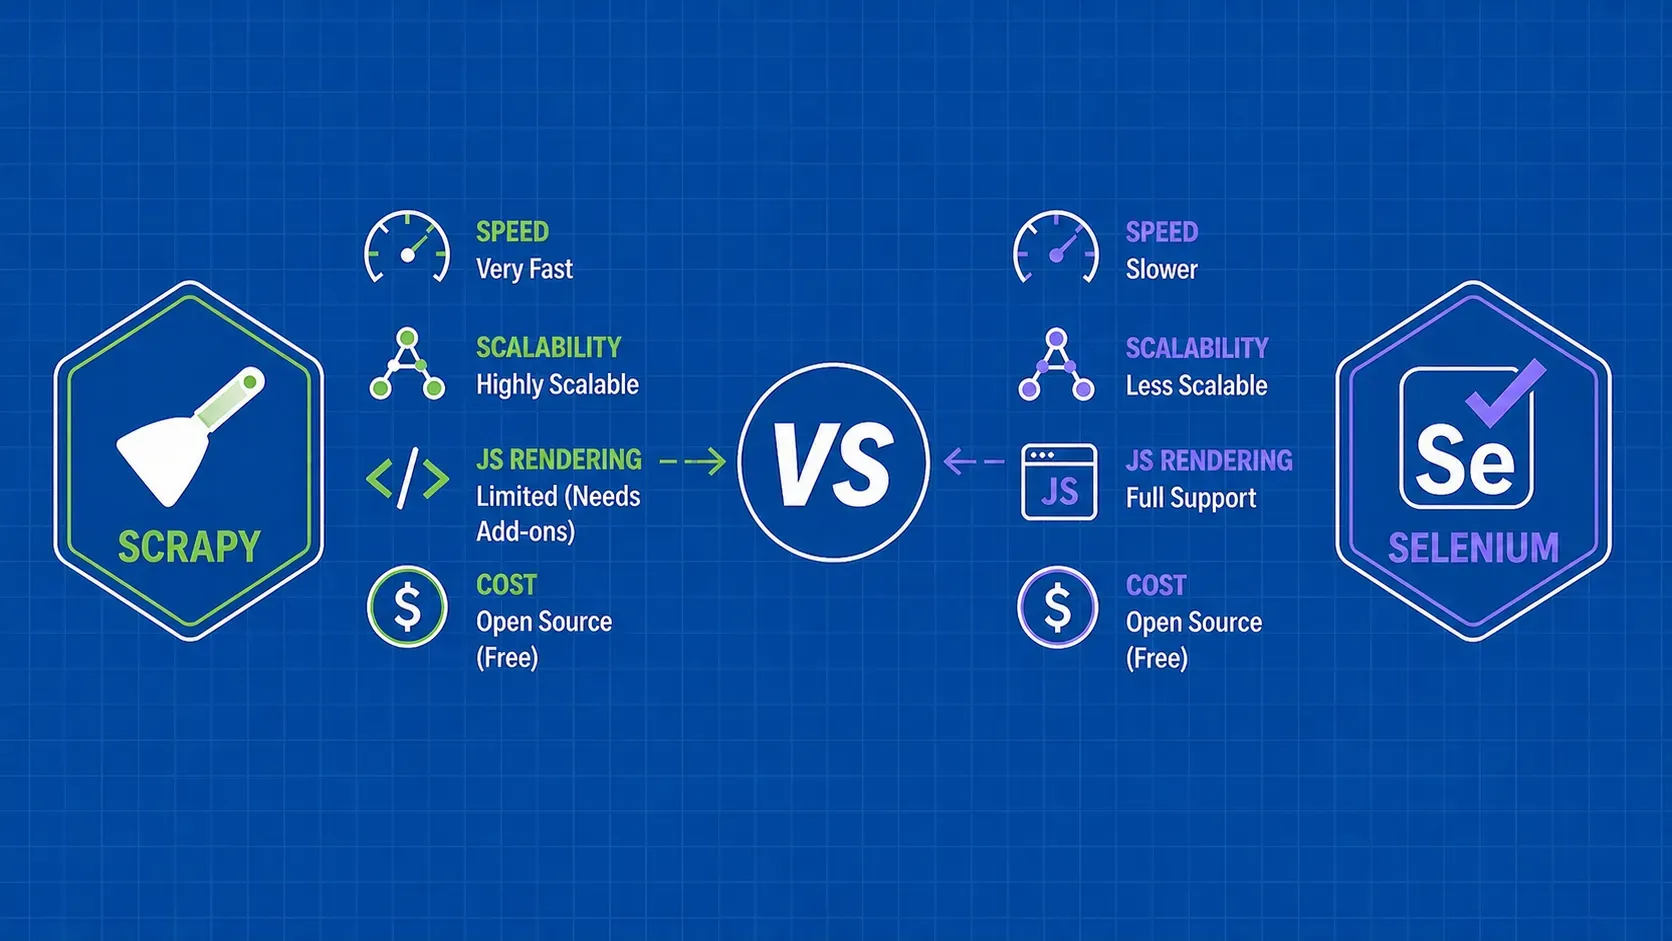
TL;DR: O Scrapy é uma estrutura de rastreamento assíncrona e de alta velocidade criada para extrair dados estruturados de páginas estáticas em escala. O Selenium automatiza navegadores reais e lida com sites com muito JavaScript, mas com um custo de recursos muito maior. A maioria dos projetos de raspagem de produção se beneficia de saber quando usar cada um, ou quando combiná-los.

Gabriel Cioci11 min read
Ler artigo
Explicação da análise de dados: Ferramentas, técnicas e código (2026)
A ciência da extração de dados da Web

Explicação da análise de dados: Ferramentas, técnicas e código (2026)

TL;DR: A análise de dados converte conteúdo bruto (HTML, JSON, XML, PDFs) em campos estruturados que seu código pode realmente usar. Este guia mostra como a análise de dados funciona passo a passo, compara as principais técnicas e bibliotecas e fornece uma estrutura prática para decidir se deve criar ou comprar sua camada de análise.

Suciu Dan16 min read
Ler artigo
O que é a automatização do navegador? Um guia prático
A ciência da extração de dados da Web

O que é a automatização do navegador? Um guia prático

TL;DR: A automação do navegador é a prática de conduzir um navegador da Web real ou sem cabeça a partir do código para que ele clique, digite, navegue e leia páginas em seu nome. Este guia explica o que é automação de navegador nos bastidores, compara Selenium, Playwright, Puppeteer e Cypress, e mostra quando não se deve usar um navegador completo.

Ștefan Răcilă13 min read
Ler artigo
Web Scraping vs Data Mining: Diferenças, pipelines e quando usar cada um
A ciência da extração de dados da Web

Web Scraping vs Data Mining: Diferenças, pipelines e quando usar cada um

TL;DR: O Web scraping recolhe dados em bruto de páginas Web públicas. A extração de dados analisa dados estruturados para obter padrões, previsões e segmentos. São fases diferentes do mesmo ciclo de vida e a maioria dos sistemas de produção combinam-nas num pipeline de scrape-then-normalize-then-mine.

Ștefan Răcilă15 min read
Ler artigo
Melhores cursos de Web Scraping para desenvolvedores
A ciência da extração de dados da Web

Melhores cursos de Web Scraping para desenvolvedores

TL;DR: Os melhores cursos de web scraping dependem do seu idioma, nível e caso de uso alvo. Este guia compara cinco opções pagas na Udemy, Coursera, DataCamp e Packt, aponta para suplementos gratuitos, como documentos oficiais, e mostra como fazer a ponte entre a conclusão de um curso e a execução de scrapers de produção.

Ștefan Răcilă12 min read
Ler artigo
10 perguntas sobre raspagem que toda equipe de dados deve responder antes de escrever um raspador
A ciência da extração de dados da Web

10 perguntas sobre raspagem que toda equipe de dados deve responder antes de escrever um raspador

TL;DR: Um projeto de web scraping falha no planeamento muito antes de falhar no código. Estas dez perguntas sobre scraping orientam-no através da legalidade, alternativas de API, defesas anti-bot, custo, cadência de atualização, qualidade dos dados e governação, para que possa definir o âmbito do trabalho, escolher a stack certa e evitar os modos de falha que matam silenciosamente os scrapers em produção.

Mihai Maxim12 min read
Ler artigo
15 melhores navegadores antidetecção em 2026: comparação honesta para profissionais de marketing, scrapers e gerentes de várias contas
A ciência da extração de dados da Web

15 melhores navegadores antidetecção em 2026: comparação honesta para profissionais de marketing, scrapers e gerentes de várias contas

TL;DR: Os navegadores antidetecção permitem-lhe executar vários perfis de navegador isolados, cada um com uma impressão digital única, para que as plataformas não possam ligar as suas contas. Este guia classifica os 15 melhores navegadores antidetecção de 2026 em termos de qualidade de impressão digital, suporte à automação, preço e integração de proxy. Também abordamos como essas ferramentas realmente funcionam, quando uma API de raspagem é a escolha mais inteligente e qual tipo de proxy deve ser combinado com cada caso de uso.

Mihnea-Octavian Manolache32 min read
Ler artigo
O que são Proxies ISP? Guia para Web Scraping e Automação
A ciência da extração de dados da Web

O que são Proxies ISP? Guia para Web Scraping e Automação

TL;DR: O que são proxies ISP? São IPs residenciais estáticos alojados num centro de dados. Os sistemas de deteção vêem um ASN residencial; você obtém rendimento do datacenter. Eles são a escolha certa quando as sessões, a vinculação de contas e o preço previsível por IP são mais importantes do que o alcance geográfico bruto.

Mihnea-Octavian Manolache11 min read
Ler artigo
HTTP Headers Web Scraping: Deixar de ser bloqueado
A ciência da extração de dados da Web

HTTP Headers Web Scraping: Deixar de ser bloqueado

TL;DR: Os cabeçalhos HTTP são normalmente a razão pela qual o seu scraper recebe um 403 enquanto o seu browser carrega o mesmo URL sem problemas. Este guia mostra quais cabeçalhos os sistemas anti-bot realmente inspecionam, como capturar o conjunto de cabeçalhos de um navegador real do DevTools, como enviá-los e girá-los corretamente em Python e Node.js, e quando o ajuste manual deixa de valer a pena e uma API de raspagem gerenciada é a melhor opção.

Raluca Penciuc14 min read
Ler artigo
Melhores proxies residenciais rotativos em 2026 para raspagem da Web
A ciência da extração de dados da Web

Melhores proxies residenciais rotativos em 2026 para raspagem da Web

TL;DR: Os melhores proxies residenciais rotativos em 2026 não são os que têm o maior tamanho de pool de outdoors. Eles são aqueles cujo controle de sessão, segmentação geográfica, fornecimento ético e economia por GB realmente correspondem aos alvos que você raspa. Este guia fornece uma estrutura de avaliação neutra do fornecedor, uma tabela de comparação de 11 fornecedores e um mapa de casos de uso para que você possa selecionar dois ou três antes de tocar em um cartão de crédito.

Anda Miuțescu45 min read
Ler artigo
Web Scraping com Node-Unblocker: Um guia prático
A ciência da extração de dados da Web

Web Scraping com Node-Unblocker: Um guia prático

TL;DR: O Node-unblocker transforma um aplicativo Express em um proxy HTTP com prefixo de URL que você pode hackear. Este guia de desbloqueio de nó de raspagem da web percorre a instalação, conectando middlewares de solicitação e resposta, instâncias rotativas, implantando no Docker ou Heroku e reconhecendo o ponto em que uma API de raspagem gerenciada é a resposta mais limpa.

Sorin-Gabriel Marica12 min read
Ler artigo
O que são proxies rotativos? Guia de rotação de IP para Web Scraping
A ciência da extração de dados da Web

O que são proxies rotativos? Guia de rotação de IP para Web Scraping

TL;DR: Então, o que são proxies rotativos, em uma linha? Servidores proxy que atribuem um IP diferente a cada solicitação de um pool gerenciado, que é como os scrapers passam pelos limites de taxa por IP, CAPTCHAs e filtros geográficos. Este guia aborda como a rotação funciona, os quatro tipos de pool, o código de configuração em três idiomas e como escolher um provedor.

Raluca Penciuc12 min read
Ler artigo
Guia rápido de seletores CSS para web scraping
A ciência da extração de dados da Web

Guia rápido de seletores CSS para web scraping

TL;DR: Use esta ficha de referência de seletores CSS quando quiser fazer scraping na Web como um profissional

Ștefan Răcilă6 min read
Ler artigo
Como construir um rastreador da Web em Python: Do início à escala
A ciência da extração de dados da Web

Como construir um rastreador da Web em Python: Do início à escala

TL;DR: Um web crawler python automatiza o trabalho tedioso de seguir links em um site para descobrir e coletar conteúdo. Este guia orienta-o na construção de um de raiz com pedidos e BeautifulSoup, passando depois para Scrapy para rastreio concorrente, pipelines de itens e exportações de dados estruturados. Você também aprenderá como rastrear de forma responsável, girar proxies para evitar bloqueios e lidar com páginas renderizadas em JavaScript.

Suciu Dan31 min read
Ler artigo
Lista de proxies premium de 2026: classificação dos 9 serviços de proxy pagos
A ciência da extração de dados da Web

Lista de proxies premium de 2026: classificação dos 9 serviços de proxy pagos

TL;DR: Resumo: Para a maioria das equipas de scraping, a Oxylabs e a Decodo são os serviços de proxy premium mais fortes e versáteis, a Bright Data adequa-se a orçamentos empresariais e a Webshare é a forma mais barata de começar com uma lista estática. Escolha uma lista estática quando quer IPs que continuam seus durante o período de aluguer, e um gateway rotativo quando cada pedido ou sessão deve sair por um IP diferente.

Gabriel Cioci27 min read
Ler artigo
Estilos de API: Comparação entre cinco modelos práticos de integração
A ciência da extração de dados da Web

Estilos de API: Comparação entre cinco modelos práticos de integração

TL;DR: Distinga cinco abordagens comuns de API sem confundir arquitetura, protocolos e padrões de implementação. Compare os respetivos contratos utilizando um cenário prático de catálogo.

Robert Munceanu15 min read
Ler artigo
As melhores listas de proxies gratuitos para web scraping, classificadas (2026)
A ciência da extração de dados da Web

As melhores listas de proxies gratuitos para web scraping, classificadas (2026)

TL;DR: Resumo: As melhores listas de proxies gratuitos para web scraping são a da ProxyScrape para scripts, a da Geonode para tempo de atividade e filtros ASN, e a monosans/proxy-list no GitHub para alimentar pipelines em texto simples. Trate cada lista como um conjunto de candidatos, porque só uma pequena parte dos proxies listados funciona num dado dia, e nunca envie logins ou páginas de pagamento através de um proxy gratuito.

Robert Munceanu26 min read
Ler artigo
Os melhores proxies de centro de dados partilhados e dedicados em 2026
A ciência da extração de dados da Web

Os melhores proxies de centro de dados partilhados e dedicados em 2026

TL;DR: Os proxies de centro de dados partilhados, semidedicados e dedicados têm preços e formas de faturação tão diferentes que, muitas vezes, o preço de tabela mais baixo acaba por ser o mais caro. Este guia compara 11 fornecedores com base nos preços de tabela atuais, seleciona um para cada tarefa, explica a diferença entre a faturação por IP e por GB e o uso justo, e inclui scripts em Python para estimar os custos e verificar se os seus IPs são realmente dedicados.

Anda Miuțescu25 min read
Ler artigo
Web Scraping vs. Web Crawling: Guia para Principiantes
A ciência da extração de dados da Web

Web Scraping vs. Web Crawling: Guia para Principiantes

TL;DR: Saiba como os rastreadores encontram páginas e como os extratores de dados recolhem informações úteis. Siga o exemplo de uma livraria, compare os resultados obtidos e escolha o fluxo de trabalho adequado para o seu primeiro projeto.

Anda Miuțescu13 min read
Ler artigo
Melhores proxies móveis para web scraping em 2026: 9 provedores ranqueados
A ciência da extração de dados da Web

Melhores proxies móveis para web scraping em 2026: 9 provedores ranqueados

TL;DR: Compare 9 provedores de proxies móveis para scraping por preço por GB ou por porta, segmentação por operadora e ASN, 5G, sessões fixas e testes, em outubro de 2026.

Sergiu Inizian26 min read
Ler artigo
Melhores práticas de web scraping: um guia do ciclo de vida com dicas e código funcional
A ciência da extração de dados da Web

Melhores práticas de web scraping: um guia do ciclo de vida com dicas e código funcional

TL;DR: Melhores práticas de web scraping para cada fase do ciclo de vida de um scraper: planear os dados, respeitar o ficheiro robots.txt tal como definido pela RFC 9309, controlar o ritmo de cada host e respeitar o cabeçalho Retry-After, analisar de forma defensiva, validar cada registo, monitorizar as execuções, verificar o progresso e acompanhar o custo por registo válido. Cada fase inclui um pequeno fragmento de código Python funcional.

Anda Miuțescu33 min read
Ler artigo
Raspagem da Web sem ser bloqueado: Manual 2026
A ciência da extração de dados da Web

Raspagem da Web sem ser bloqueado: Manual 2026

TL;DR: Os bloqueios modernos ocorrem em quatro camadas: rede, assinatura do pedido, navegador e comportamento. Diagnostique a camada primeiro usando códigos de status e páginas de desafio e, em seguida, corrija-a com a combinação certa de proxies residenciais rotativos, cabeçalhos de nível de navegador, personificação de TLS, navegadores furtivos e tempo semelhante ao humano. Quando o volume ou a sofisticação anti-bot torna a bricolage pouco económica, transfira a camada de pedido para uma API gerida.

Sergiu Inizian38 min read
Ler artigo
Bloqueios de IP no web scraping: diagnostique antes de tentar novamente
A ciência da extração de dados da Web

Bloqueios de IP no web scraping: diagnostique antes de tentar novamente

TL;DR: Identifique as causas subjacentes a uma falha na recolha de dados antes de a classificar como um bloqueio de IP. Diagnostique limites de taxa, problemas de sessão e recusas de acesso e, em seguida, verifique se a recuperação foi bem-sucedida.

Anda Miuțescu15 min read
Ler artigo
Vantagens da API de Web Scraping: O que realmente externaliza
A ciência da extração de dados da Web

Vantagens da API de Web Scraping: O que realmente externaliza

TL;DR: Veja quais as responsabilidades que uma API de extração pode assumir e quais continuam a ser da sua responsabilidade. Avalie a renderização, a saída estruturada, a recuperação e o custo por registo utilizável.

Anda Miuțescu15 min read
Ler artigo
Melhores tipos de proxies para Web Scraping em 2026
A ciência da extração de dados da Web

Melhores tipos de proxies para Web Scraping em 2026

TL;DR: Os proxies de raspagem da Web ficam entre o seu raspador e o site alvo, mascaram o seu IP e permitem-lhe sobreviver a limites de taxa, geo-walls e defesas anti-bot. O tipo certo (centro de dados, residencial, ISP ou móvel) e o protocolo certo (HTTP/HTTPS ou SOCKS5, IPv4 ou IPv6) dependem das defesas do alvo, das suas necessidades geográficas e do peso de cada página. Este guia apresenta as soluções de compromisso e termina com uma lista de verificação neutra em termos de fornecedor.

Raluca Penciuc15 min read
Ler artigo
Gestão de proxies para a extração de dados da Web: um projeto prático
A ciência da extração de dados da Web

Gestão de proxies para a extração de dados da Web: um projeto prático

TL;DR: Conceba a atribuição de proxies tendo em conta os requisitos de trabalho, os períodos de validade das sessões, a integridade em camadas e os limites a nível da fonte. Avalie os registos aceites em vez das rotações de endereços.

Raluca Penciuc16 min read
Ler artigo
Os melhores proxies para web scraping em 2026: escolha consoante a tarefa e o custo
A ciência da extração de dados da Web

Os melhores proxies para web scraping em 2026: escolha consoante a tarefa e o custo

TL;DR: Os melhores proxies para web scraping são os mais baratos que o seu alvo aceita. Este guia associa proxies de centros de dados, ISP, residenciais e móveis a tarefas de web scraping, compara nove fornecedores com base nos preços publicados, mostra como calcular o custo por pedido bem-sucedido e fornece-lhe um conjunto de ferramentas em Python para testar os fornecedores nas suas próprias URLs antes de comprar.

Robert Munceanu27 min read
Ler artigo
Scraper personalizado vs. ferramentas de extração de dados: criar ou comprar?
A ciência da extração de dados da Web

Scraper personalizado vs. ferramentas de extração de dados: criar ou comprar?

TL;DR: Decida se deve desenvolver, adquirir ou combinar ferramentas de extração de dados, recorrendo a um contrato de dados, a uma comparação de propriedade, a um modelo de custo total e a um projeto-piloto prático.

Sergiu Inizian16 min read
Ler artigo
As melhores ferramentas de Web Scraping de 2026
A ciência da extração de dados da Web

As melhores ferramentas de Web Scraping de 2026

TL;DR: As melhores ferramentas de raspagem da web de 2026 dividem-se em três grupos: APIs gerenciadas que escondem proxies, navegadores sem cabeça e CAPTCHAs por trás de uma chamada HTTP; estruturas de código aberto como Scrapy e Crawlee que lhe dão controle total se você puder hospedá-las; e raspadores visuais sem código para não desenvolvedores. Não existe um único vencedor. Comparamos mais de 22 opções em termos de modelos de preços, renderização de JavaScript, força anti-bot e casos de utilização ideais, para que possa selecionar duas ou três para testar nos seus sites-alvo reais.

Gabriel Cioci57 min read
Ler artigo
O que é Web Scraping? Um guia prático para programadores
A ciência da extração de dados da Web

O que é Web Scraping? Um guia prático para programadores

TL;DR: Web scraping é a extração automatizada de dados públicos da Web para um formato estruturado que pode realmente ser utilizado, como JSON ou uma folha de cálculo. Este guia aborda o que é Web scraping a um nível de definição, o pipeline de solicitação e análise por trás dele, onde as equipas o colocam a trabalhar, o espetro de ferramentas, desde APIs sem código a APIs geridas, e como se manter do lado certo das defesas anti-bot e da lei.

Sergiu Inizian21 min read
Ler artigo

Comece a construir

Pronto para expandir a sua recolha de dados?

Junte-se a mais de 2.000 empresas que utilizam a WebScrapingAPI para extrair dados da Web à escala empresarial, sem quaisquer custos de infraestrutura.