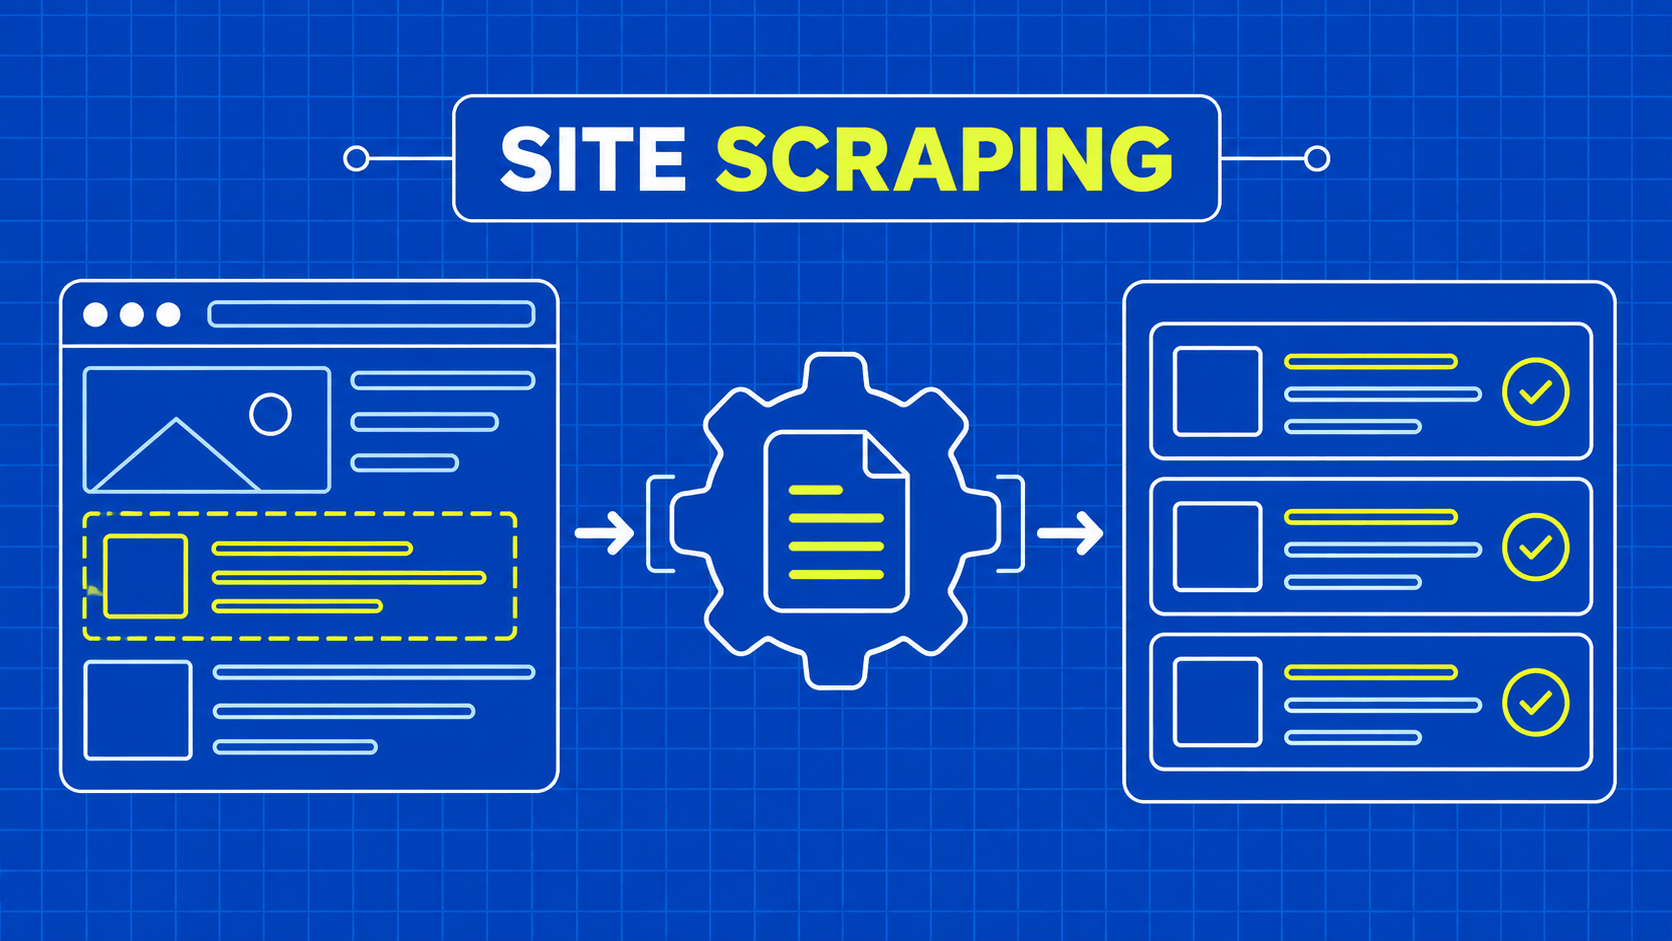
TL;DR: Um scraper de sites útil transforma um conjunto aprovado de páginas em registos com significado definido, verifica esses registos e fornece um lote identificável. Comece por definir o âmbito dos registos e da recolha, escolha um modelo de execução que aceda aos dados e teste a navegação, os valores em falta e a recuperação antes de agendar a tarefa.
Suponha que precise de um diretório semanal de organizações a partir de um site que está autorizado a recolher. Cada linha deve conter um nome, uma morada, um URL de origem e a hora em que foi observada. Um scraper de sites é o fluxo de trabalho de software que visita as páginas relevantes e extrai esses campos, mas um coletor fiável também verifica se as linhas resultantes são utilizáveis.
Extrair texto de uma página é apenas o primeiro desafio. É necessário decidir quais as páginas que se enquadram no âmbito, se várias entradas descrevem a mesma organização, como representar um endereço em falta e o que o utilizador deve fazer se a próxima execução for interrompida a meio. Essas decisões determinam se o resultado final pode servir de base para relatórios ou funcionalidades de aplicações.
Este guia acompanha o exemplo do diretório, desde a conceção do registo até à entrega. Trata-se de um guia prático de conceção e seleção, em vez de uma classificação de produtos intercambiáveis. Pode aplicar o método a uma ferramenta visual, a um coletor baseado em HTTP ou à automação do navegador, desde que a implementação escolhida disponibilize os controlos e as evidências de que o seu fluxo de trabalho necessita.
Comece com uma pequena amostra aprovada que alguém possa verificar manualmente. Expanda apenas depois de o coletor conseguir explicar o que visitou, o que aceitou e o que permanece incerto.