Saltar para o conteúdo
Comece grátis
Voltar ao blogue

Vantagens da API de Web Scraping: O que realmente externaliza

Anda MiuțescuÚltima atualização em 15 min read
Vantagens da API de Web Scraping: O que realmente externaliza
Resumo: Uma API de web scraping pode transferir a recolha de dados, a gestão de proxies ou a execução do navegador para fora da sua aplicação, dependendo do serviço. A extração estruturada é uma funcionalidade distinta, e nem uma solicitação bem-sucedida nem um JSON válido garantem dados utilizáveis. Avalie a responsabilidade que delega, os registos que aceita e o trabalho de recuperação que ainda lhe cabe.

Uma API de web scraping é uma interface de serviço através da qual a sua aplicação solicita conteúdo de páginas web ou dados extraídos. A sua vantagem mais importante é uma mudança na responsabilidade operacional: a sua equipa pode utilizar um serviço definido em vez de manter todos os componentes que obtêm a página.

Considere uma tarefa diária de catalogação. Ontem, ela recuperou todas as páginas, mas a execução de hoje passa o tempo a reiniciar navegadores. Contratar um serviço de extração pode ajudar, mas apenas se este assumir a responsabilidade que está a falhar. Um serviço que devolve HTML bruto continua a deixar a extração de campos a cargo de si. Uma resposta estruturada ainda requer verificações quanto ao produto, moeda e hora de observação corretos.

Este guia explica as vantagens das APIs de web scraping sem tratar uma API como uma plataforma de dados completa. Verá quais as tarefas que podem ser transferidas para um fornecedor, quais permanecem com a sua aplicação e como avaliar se a mudança vale a pena. Os exemplos servem de orientação arquitetónica, não são comparações entre fornecedores nem uma afirmação de que todos os serviços oferecem as mesmas funcionalidades.

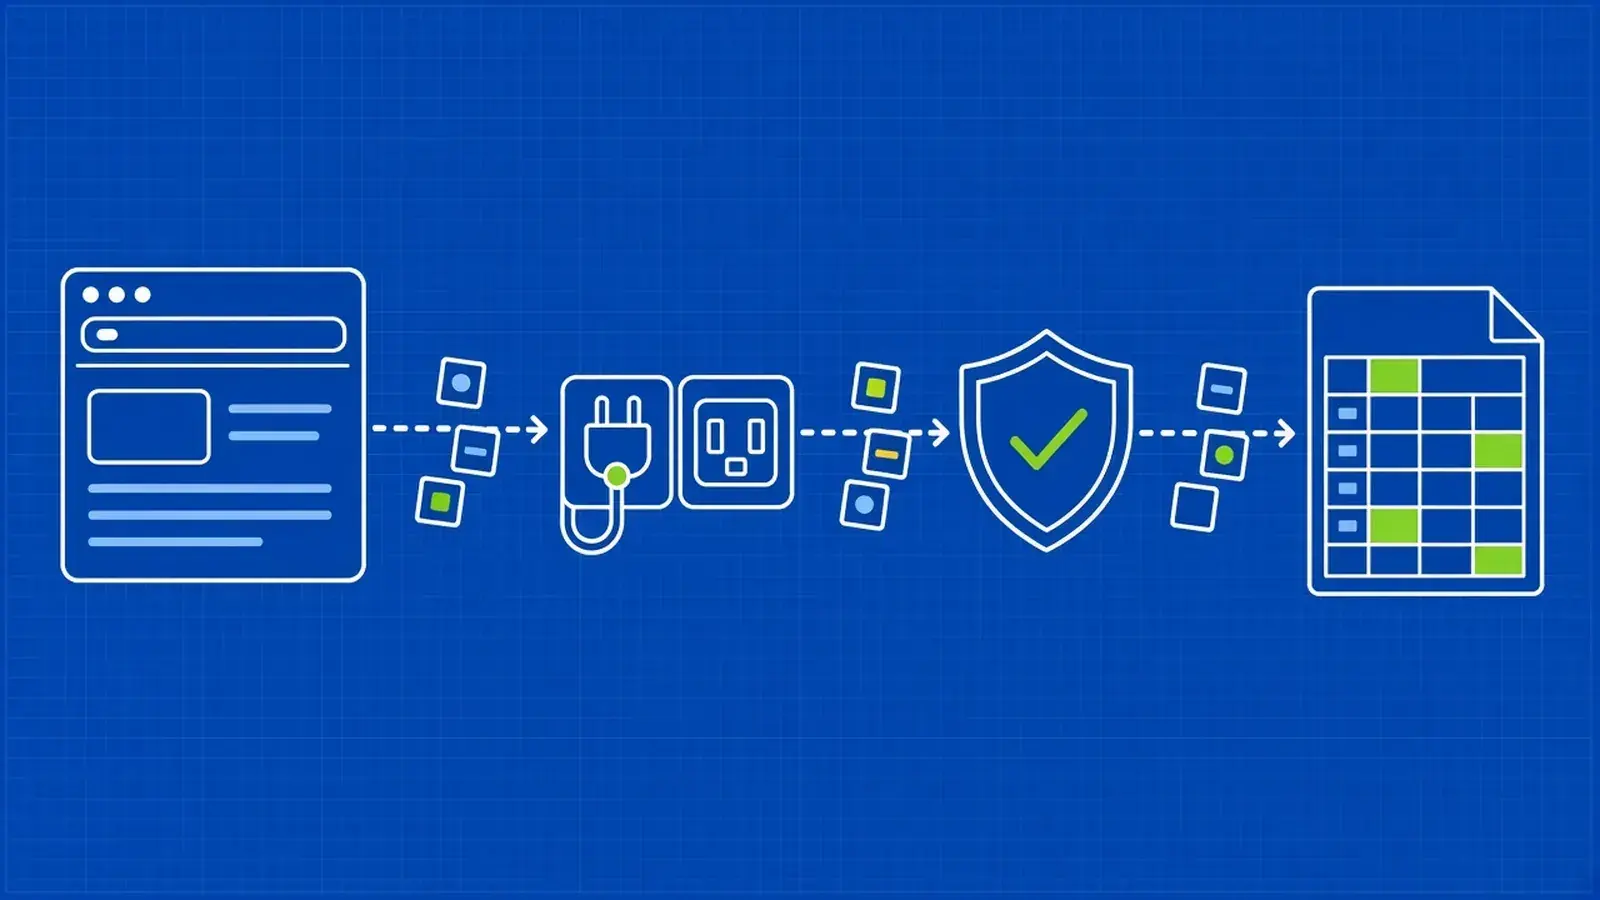
Relacione as vantagens das APIs de web scraping às responsabilidades

Comece por definir os limites do que o serviço realmente promete. A recolha obtém uma representação de uma página. A renderização executa um ambiente de navegador para obter conteúdo afetado por scripts e interações. A extração transforma o conteúdo de origem em campos. Um pipeline de produção agenda o trabalho, valida os resultados, gere o estado e entrega registos aos consumidores.

Estas responsabilidades podem ser agrupadas, mas não são sinónimos. Um ponto final de pedido gerido pode devolver HTML sem extrair campos. Um serviço de navegador pode permitir-lhe executar interações sem decidir quais os elementos que pertencem ao seu conjunto de dados. Uma API de extração pode reconhecer um tipo de registo suportado sem implementar as suas regras de aceitação empresarial.

Responsabilidade

Vantagem potencial da API

Responsabilidade de verificar ou reter

Recuperação HTTP

Infraestrutura de pedidos geridos

Alvos aprovados e validação de respostas

Execução no navegador

Menos trabalho de alojamento e gestão do ciclo de vida do navegador

Interações necessárias e critérios de conclusão

Extração de campos

Saída estruturada suportada

Significado, integridade e compatibilidade com o esquema

Recuperação

Erros documentados ou novas tentativas do lado do serviço

Prazos das tarefas, deduplicação, política de repetição

Entrega

Exportações opcionais ou integrações de armazenamento

Contratos com os utilizadores e política de retenção

Utilize esta tabela como uma lista de verificação para a aquisição. Assinale cada funcionalidade como incluída, opcional, não suportada ou desconhecida. Em seguida, atribua um responsável a cada tarefa restante. Um «desconhecido» explícito é mais saudável do que um diagrama que pressupõe silenciosamente que o fornecedor trata de tudo entre um URL e um painel de controlo.

Este limite também garante a imparcialidade de um período de avaliação. Compare um fetcher gerido com o trabalho de recolha de dados que substitui, e não com uma plataforma de análise inteira mantida manualmente. Compare uma plataforma mais completa com o seu conjunto mais amplo de responsabilidades, incluindo quaisquer novas restrições que introduza.

Reduza as operações de recolha de dados e do navegador onde estas causam problemas

A primeira vantagem prática é o menor número de componentes que a sua equipa tem de operar. Dependendo do produto, um fornecedor pode gerir o encaminhamento de pedidos, a capacidade do navegador ou o ambiente que executa as interações da página. A sua aplicação acede a um limite de serviço em vez de ter de provisionar e diagnosticar cada componente subjacente individualmente.

A renderização é um exemplo útil. A documentação de automatização do navegador para um serviço gerido descreve os pedidos e ações específicos do navegador separadamente da recuperação HTTP comum. Essa separação é importante porque recuperar o corpo de uma resposta e observar uma página após a execução de scripts são operações diferentes. O suporte ao navegador de um fornecedor deve ser avaliado em função da sua interação real, e não inferido a partir de uma afirmação de que suporta JavaScript.

Identifique a condição de conclusão para cada tipo de página. O aparecimento do título de um produto pode ser suficiente para um coletor; outro terá de aguardar uma interação de filtro permitida e uma tabela preenchida. Um período de espera arbitrariamente longo não constitui um contrato de aceitação. Verifique se o serviço consegue expressar e comunicar a condição exigida pelo seu fluxo de trabalho.

Mantenha as páginas leves. Se o conteúdo necessário já estiver na resposta inicial, a execução no navegador pode acrescentar trabalho sem acrescentar informação. A nossa comparação de clientes HTTP em Python para web scraping é útil quando um cliente convencional continua a ser suficiente para parte da carga de trabalho.

As operações geridas são mais valiosas quando eliminam um fardo recorrente que consiga identificar. Anote esse fardo antes do período de teste: falhas no arranque do navegador, manutenção da infraestrutura ou incidentes de encaminhamento de pedidos. Posteriormente, verifique se esse fardo diminuiu efetivamente ou se apenas passou a manifestar-se em tickets de suporte menos visíveis.

Obtenha resultados estruturados sem os confundir com a verdade

Uma API de extração estruturada pode reduzir a quantidade de análise específica do site que tem de manter. Isso é uma vantagem real quando os tipos de registos suportados se adequam à sua tarefa. Por exemplo, a documentação de extração automática descreve tipos estruturados para produtos, artigos e ofertas de emprego, com controlo sobre a fonte utilizada para a extração. Trata-se de uma capacidade documentada do produto, não de uma garantia de correção para todas as páginas.

Defina o seu próprio esquema de aceitação antes de testar um. Para uma observação de catálogo, exija um identificador de fonte, o URL canónico da fonte, o carimbo de data/hora observado, a moeda e os campos necessários para o cálculo a jusante. Decida quais os valores em falta que são aceitáveis e quais os que devem colocar o registo em quarentena. Um objeto sintaticamente válido pode ainda assim descrever a variante errada.

Mantenha as observações brutas distintas dos valores comerciais normalizados. Um preço apresentado pode incluir um intervalo, um desconto ou um formato decimal dependente da localização. Se o normalizar, preserve proveniência suficiente para explicar a transformação. Não transforme silenciosamente um preço ausente em zero nem um indicador de disponibilidade em falta numa afirmação positiva.

O mesmo princípio aplica-se se mantiver o seu próprio analisador. A documentação do pipeline de itens do Scrapy trata a validação, a limpeza e a persistência como responsabilidades explícitas de processamento. Transferir a recolha para uma API não faz com que essas responsabilidades desapareçam; apenas altera a origem dos seus dados de entrada.

Adicione fixtures de regressão para variações importantes da página. Quando a saída mudar, determine se a fonte mudou, se o fornecedor alterou o comportamento de extração ou se a sua própria normalização sofreu alterações. Separar estas camadas permite investigar sem declarar todo o pipeline como não fiável ou aceitar um erro de dados subtil apenas porque a resposta parecia bem formada.

Utilize erros de serviço para criar uma recuperação delimitada

Um contrato de erros documentado pode ser mais fácil de integrar do que um conjunto de exceções de baixo nível, mas continua a ser necessária uma política de recuperação. Distinga entre entradas inválidas, falhas de autenticação, limitação do fornecedor, respostas da fonte e extração falhada. Estas situações requerem ações diferentes. Repetir um pedido inválido com a mesma carga útil não é resiliência.

As APIs geridas podem expor o seu próprio estado e também descrever o resultado pretendido. Consulte ambos os níveis, sempre que disponíveis. O nosso guia de resolução de problemas de erros de proxy explica o problema geral de atribuir uma falha ao salto correto. A mesma disciplina aplica-se quando o intermediário é uma API, em vez de um proxy configurado.

A documentação do fornecedor deve especificar quais os erros que podem ser repetidos. Por exemplo, o guia de tratamento de erros de um serviço gerido distingue a limitação de tráfego das solicitações mal sucedidas e documenta o comportamento de recuo (backoff). A sua aplicação deve, ainda assim, impor um prazo de negócio e limites de despesas em torno da tarefa global. Uma solicitação que possa eventualmente ser bem-sucedida pode tornar-se inútil após o seu período de entrega.

Mantenha o estado do trabalho independentemente do processo que o está a executar. Registe os resultados em fila, tentados, aceites, em quarentena e com falha definitiva. Utilize identificadores de trabalho estáveis para que a reprodução possa atualizar ou deduplicar registos, em vez de acrescentar duplicados. Uma resposta da API não prova que a gravação na sua base de dados tenha sido concluída antes de um trabalhador ter falhado.

Teste a recuperação de forma deliberada com fixtures ou num ambiente de teste controlado. Interrompa um trabalhador após receber uma resposta, mas antes de confirmar a tarefa. Confirme que a nova tentativa produz um resultado de negócio aceite. A vantagem operacional não é que as falhas desapareçam; é que o limite do serviço dá à sua equipa um conjunto mais pequeno e documentado de falhas para gerir.

Escale dentro de limites, em vez de partir do princípio de um débito ilimitado

Um serviço pode reduzir o trabalho de gestão de capacidade sem fornecer capacidade ilimitada. Verifique os limites de taxa, os limites de tarefas simultâneas, os limites de tamanho de resposta, os prazos para pedidos e quaisquer restrições que variem consoante o destino ou a funcionalidade. Estes limites afetam tanto a taxa de transferência como a forma como o seu programador deve comportar-se.

Por exemplo, a documentação sobre limites de taxa de um serviço descreve limites relacionados com contas e websites. Isto ilustra por que razão a cota de uma conta não é a única restrição que importa. Não generalize as unidades ou limites de um único fornecedor a todas as API.

Utilize uma fila para suavizar picos de tráfego e um conjunto limitado de trabalhadores para impedir que o seu próprio sistema inicie tarefas impossíveis de gerir. Separe as fontes com orçamentos diferentes, para que uma fonte lenta não monopolize todos os trabalhadores. Propague a contrapressão proveniente do armazenamento e da validação, em vez de continuar a recuperar dados que não podem ser aceites.

Meça o tempo até aos dados aceites, não apenas a latência do pedido. Uma resposta rápida seguida de um longo atraso na validação não cumpre o mesmo prazo que uma resposta lenta. Acompanhe o item de trabalho pendente mais antigo e a antiguidade das observações aceites. Essas métricas ligam o comportamento da infraestrutura ao objetivo real da tarefa de recolha.

O nosso guia sobre web scraping automatizado aborda as tarefas recuperáveis como um fluxo de trabalho completo. Uma API pode simplificar uma etapa dentro desse fluxo de trabalho. Não substitui a necessidade de agendar adequadamente, respeitar as restrições das fontes ou interromper a recolha quando o consumidor a jusante não estiver disponível.

Compare os aspetos económicos utilizando registos aceites

As vantagens das APIs de web scraping incluem frequentemente um menor esforço de manutenção, mas isso é uma hipótese a ser avaliada, em vez de uma poupança automática de custos. Um pequeno coletor que atue em páginas estáveis e autorizadas pode continuar a ser mais barato e simples com um cliente comum. Uma carga de trabalho que exija manutenção recorrente do navegador pode beneficiar muito mais de uma execução gerida.

Escolha um período de análise e defina um registo aceite: único, válido em termos de esquema, contextualmente correto e entregue antes do prazo. Em seguida, compare a fatura do fornecedor, a infraestrutura remanescente e o trabalho de engenharia incremental com o número de registos aceites. Utilize a mesma definição para o seu sistema atual e para o período de teste.

Calcule os efeitos das tentativas de repetição, da renderização opcional, da extração estruturada, do trabalho duplicado e dos compromissos mínimos ao abrigo dos termos comerciais atuais. Um preço nominal baixo por pedido não é significativo se as funcionalidades de que necessita utilizarem uma unidade de faturação diferente. Por outro lado, um preço por pedido mais elevado pode ser razoável se eliminar um volume substancial de trabalho operacional.

Não atribua valores monetários inventados a cada inconveniente. Registe o tempo real gasto em tarefas recorrentes, sempre que possível, e identifique as estimativas. Separe o trabalho de migração pontual das operações recorrentes, para que a avaliação não oculte o investimento inicial nem o cobre indefinidamente.

Apresente um resultado ao nível da carga de trabalho, em vez de uma média global. Páginas estáticas, páginas interativas e formatos não suportados podem ter resultados diferentes. Uma arquitetura híbrida pode ser a solução mais sensata: clientes comuns para fontes simples e um serviço gerido para o subconjunto que beneficia disso. A complexidade adicional de encaminhamento e suporte também deve ser incluída nessa comparação.

Mantenha explícita a governança dos dados e a responsabilidade pela entrega

Uma API adiciona outra organização ao percurso dos dados. Analise o que envia: URLs, cabeçalhos, cookies, corpos de pedidos e qualquer conteúdo de origem submetido para extração. Utilize credenciais de serviço no lado do servidor e mantenha-as fora de repositórios públicos, pacotes de navegadores e capturas de ecrã de diagnóstico.

Informe-se sobre a retenção, os controlos de acesso, os locais de processamento e os subcontratantes do produto selecionado. Se o fluxo de trabalho incluir dados privados ou regulamentados, envolva os revisores internos relevantes antes de um período de teste. Comece com dados não sensíveis, sempre que possível. Evite partir do princípio de que uma integração técnica bem-sucedida concluiu o processo de aprovação da organização.

A autoridade de recolha continua a ser da sua responsabilidade. Dê preferência a uma API de origem autorizada ou a um feed licenciado, quando estes satisfaçam os requisitos. Respeite as instruções publicadas para os rastreadores e o âmbito de acesso acordado. O Protocolo de Exclusão de Robôs (Robots Exclusion Protocol) estabelece que as regras dos rastreadores não constituem autorização de acesso, pelo que o tratamento por parte dos robôs não deve ser considerado como uma decisão de permissão completa.

As funcionalidades de entrega também necessitam de inspeção. Uma plataforma pode oferecer um conjunto de dados ou uma interface de exportação; por exemplo, a documentação do conjunto de dados descreve o armazenamento de registos estruturados e as formas de os recuperar. Isso não estabelece a sua política de retenção, o esquema do consumidor nem as garantias de recuperação. Confirme o comportamento da exportação, as permissões de acesso e o procedimento para transferir dados antes de tornar o serviço central no seu pipeline.

Designe um responsável pela eliminação, pelas reclamações da fonte e pela revogação de credenciais. Estes aspetos raramente aparecem num exemplo de início rápido, mas uma tarefa de produção não supervisionada precisa deles tanto quanto precisa de uma função de pedido.

Execute um projeto-piloto com um contrato de saída

Escolha uma carga de trabalho representativa e um período de avaliação curto e acordado. Registe a carga de manutenção do sistema existente e o resultado dos registos aceites utilizando as mesmas métricas que aplicará à API. Mantenha o orçamento de pedidos de origem fixo para que o projeto-piloto não crie uma carga extra indesejada.

Crie um adaptador específico entre a sua aplicação e o serviço. Mapeie a resposta do fornecedor para o seu formato de observação interno antes da validação empresarial. Mantenha os metadados do fornecedor disponíveis para fins de diagnóstico, mas não faça com que todos os consumidores dependam de campos de resposta incidentais. Controle as versões do mapeamento para que as alterações sejam passíveis de revisão.

Decida o que acontece quando o serviço estiver indisponível ou já não for adequado. O seu contrato de saída deve identificar os registos exportáveis, a configuração retida, as regras de extração portáteis, quando aplicável, e o trabalho que teria de ser reconstruído. Nem todas as capacidades são portáteis; registe a parte não portátil em vez de a esconder por trás de uma abstração.

No final do projeto-piloto, inspecione os registos rejeitados com o mesmo cuidado que os aceites. Um fornecedor que silenciosamente descarta páginas difíceis pode parecer excelente se o denominador incluir apenas os resultados devolvidos. Calcule o trabalho originalmente previsto e explique cada categoria de resultado.

Promova a integração apenas se o benefício operacional, a qualidade dos dados e os termos comerciais cumprirem os critérios predefinidos. Caso contrário, guarde as provas e ajuste os limites que está a considerar. Um projeto-piloto bem conduzido que rejeita um serviço inadequado ainda assim evitou uma decisão arquitetónica dispendiosa.

Pontos-chave

  • Trate as operações de recuperação, execução no navegador, extração e processamento em pipeline como responsabilidades separadas.
  • Valide o significado e a atualidade dos registos, mesmo quando uma API devolve dados estruturados com sucesso.
  • Mantenha o estado de trabalho duradouro, a recuperação delimitada e a deduplicação no contrato da aplicação.
  • Avalie o custo por registo aceite, juntamente com o esforço de manutenção e os prazos de entrega.
  • Analise o percurso dos dados e teste um plano de saída antes de tornar um fornecedor uma dependência de produção.

Perguntas frequentes

É possível utilizar uma API de scraping a partir de um fluxo de trabalho em folha de cálculo?

Sim, se a integração circundante puder efetuar pedidos autenticados e transformar a resposta nas linhas necessárias. Mantenha as credenciais num conector aprovado ou num componente do lado do servidor, em vez de as distribuir numa folha partilhada. Decida como as atualizações identificam as linhas existentes, uma vez que acrescentar repetidamente a mesma observação pode criar totais enganadores, mesmo quando cada pedido funciona.

Os campos em falta devem bloquear todo o conjunto de dados?

Não necessariamente. Classifique os campos de acordo com os requisitos da aplicação consumidora. A ausência de uma descrição opcional pode ser aceitável, enquanto a ausência de um identificador pode impedir uma deduplicação segura. Mantenha os registos rejeitados ou incompletos separados, indicando os motivos explícitos. Evite estabelecer uma regra geral que descarte observações úteis ou inclua registos incompletos em cálculos que pressupõem que todos os campos estão presentes.

É possível reconstruir páginas de origem históricas a partir dos resultados atuais da API?

Normalmente, não apenas a partir dos resultados atuais. Uma nova recolha descreve o que era observável naquele momento, não todos os estados anteriores da página. Se forem necessárias comparações históricas, conceba uma estratégia de observação e retenção permitida antes do início da recolha. Armazene carimbos temporais e proveniência juntamente com os registos e evite apresentar observações posteriores como prova do que uma fonte exibia anteriormente.

Conclusão

As vantagens mais significativas das APIs de web scraping resultam da transferência de uma carga operacional claramente definida para um serviço que a gere adequadamente em função da sua carga de trabalho. A recolha gerida pode reduzir o trabalho de rede. Os navegadores geridos podem reduzir a manutenção da execução. A extração estruturada pode reduzir o trabalho do analisador sintático. Trata-se de benefícios distintos, e cada um merece o seu próprio teste de aceitação.

Mantenha as responsabilidades restantes visíveis. A sua aplicação ainda precisa de saber o que pretendia recolher, quais os resultados válidos, quando os dados se tornam obsoletos e como o trabalho inacabado é recuperado. A governação, os contratos com os utilizadores e um plano de saída devem fazer parte do projeto desde o início, e não após o primeiro pedido bem-sucedido.

Realize um projeto-piloto restrito com páginas representativas, gastos limitados e uma definição comum dos dados aceites. Utilize os resultados para decidir se deve externalizar mais, manter um cliente leve ou combinar ambas as abordagens. Se a recuperação gerida corresponder à responsabilidade que pretende delegar, avalie a API Scraper da WebScrapingAPI em relação a esse mesmo contrato antes de expandir a integração.

Sobre o autor

Anda Miuțescu, Redator de conteúdos técnicos @ WebScrapingAPI

Anda Miuțescu

Redator de conteúdos técnicos

Anda Miuțescu é redatora de conteúdos técnicos na WebScrapingAPI, criando conteúdos claros e úteis que ajudam os programadores a compreender o produto e as suas funcionalidades.

Tutorial de Python do Nodriver: Extração discreta de dados da Web — Do primeiro script à produção
A ciência da extração de dados da Web

Tutorial de Python do Nodriver: Extração discreta de dados da Web — Do primeiro script à produção

TL;DR: Resumo: O Nodriver é uma biblioteca Python assíncrona que controla o Chromium através do Chrome DevTools Protocol, sem Selenium nem o binário chromedriver. Utilize-o quando um navegador furtivo auto-hospedado, mais próximo de uma sessão real do Chrome, é melhor do que uma stack WebDriver, mas saiba que, por si só, não elimina riscos de IP, TLS ou comportamento. Este tutorial vai de um primeiro script à produção em contentores e a uma Browser API alojada.

Suciu Dan15 min read
Ler artigo
Como lidar com URLs de redirecionamento do Google /goto e tokens CAES num scraper de SERP
A ciência da extração de dados da Web

Como lidar com URLs de redirecionamento do Google /goto e tokens CAES num scraper de SERP

TL;DR: Resumo: Os URLs /goto do Google com um token CAES, e os wrappers /url mais antigos, são camadas de redirecionamento, não destinos, por isso um scraper de SERP que trata cada href como final estraga o acompanhamento de posições e as bases de links. Prefira uma API de SERP estruturada quando devolve os links de destino. Quando tiver de analisar HTML, classifique cada href, elimine redirecionamentos duplicados e resolva-os com um GET simples. Não desencripte o CAES.

Suciu Dan13 min read
Ler artigo
Cabeçalhos de resposta HTTP no cURL: Cada flag, técnica e receita de scripting
A ciência da extração de dados da Web

Cabeçalhos de resposta HTTP no cURL: Cada flag, técnica e receita de scripting

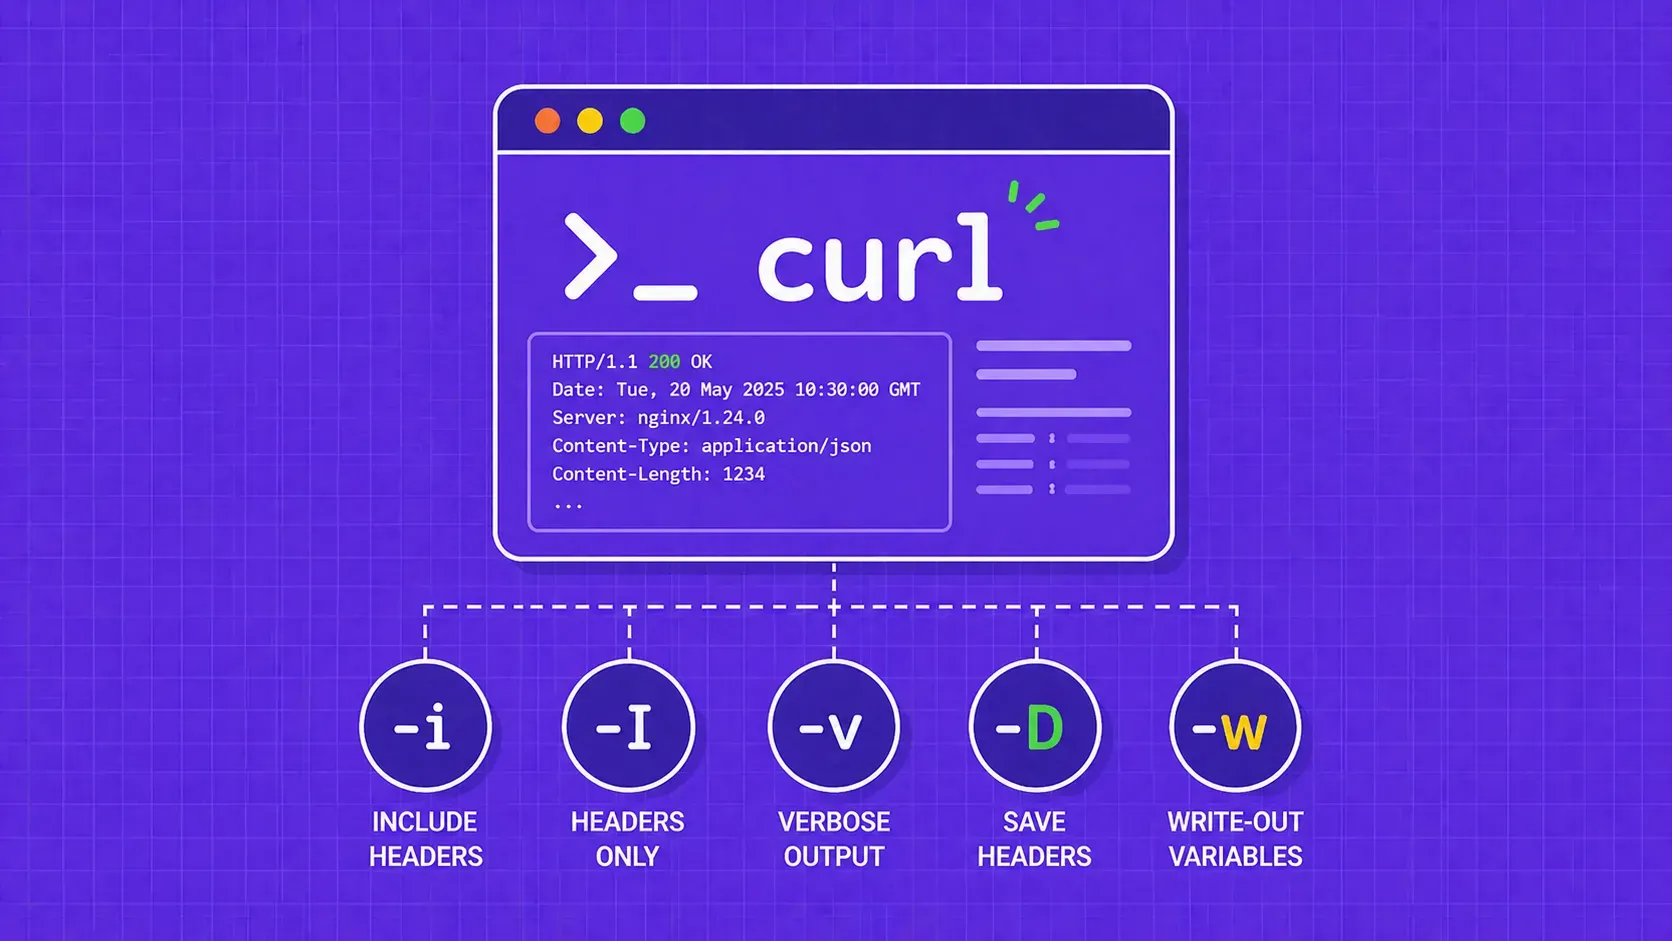
TL;DR: O cURL esconde os cabeçalhos de resposta por padrão. Use -i para ver os cabeçalhos junto com o corpo, -I para uma solicitação HEAD que retorna apenas cabeçalhos, -v para depuração completa de solicitação/resposta e -D para salvar cabeçalhos em um arquivo. Para scripts modernos, o cURL 7.83+ permite extrair cabeçalhos individuais ou despejar todos eles como JSON com a opção -w write-out.

Suciu Dan12 min read
Ler artigo

Comece a construir

Pronto para expandir a sua recolha de dados?

Junte-se a mais de 2.000 empresas que utilizam a WebScrapingAPI para extrair dados da Web à escala empresarial, sem quaisquer custos de infraestrutura.