Resumo: Uma tentativa de scraping mal sucedida não prova que haja um bloqueio de IP. Identifique se a falha se deve ao transporte, à autenticação do proxy, à limitação de taxa, ao acesso à fonte ou a conteúdo inválido da página antes de alterar qualquer coisa. Suspenda as restrições de acesso, respeite os limites da fonte e retome apenas depois de um teste controlado produzir o resultado autorizado esperado.
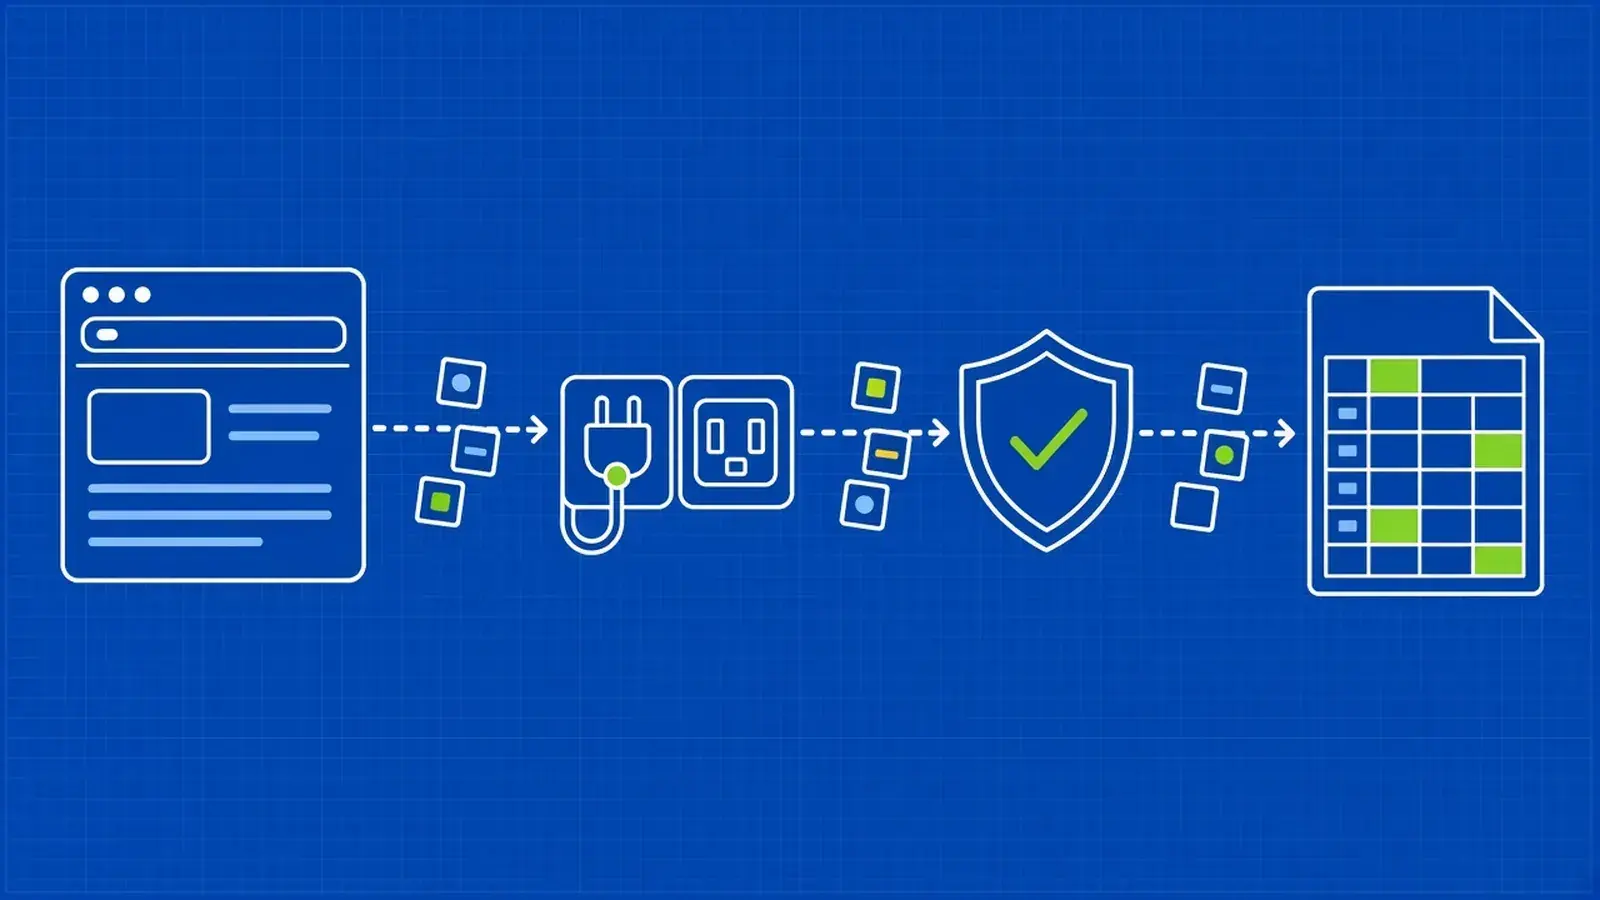
Um bloqueio de IP na extração de dados da Web é uma restrição associada ao endereço de rede de um pedido, mas a expressão é frequentemente utilizada para falhas que não foram, de todo, atribuídas a um IP. Um tempo limite esgotado, uma resposta 403 e uma página de início de sessão devolvida com o estado 200 são observações diferentes.
Imagine um coletor de catálogos que funciona num navegador manual, mas falha na sua tarefa agendada. O navegador tem uma sessão autenticada, a tarefa não, e ambos utilizam a mesma rede. Chamar a isso um bloqueio de IP direciona a investigação para o componente errado.
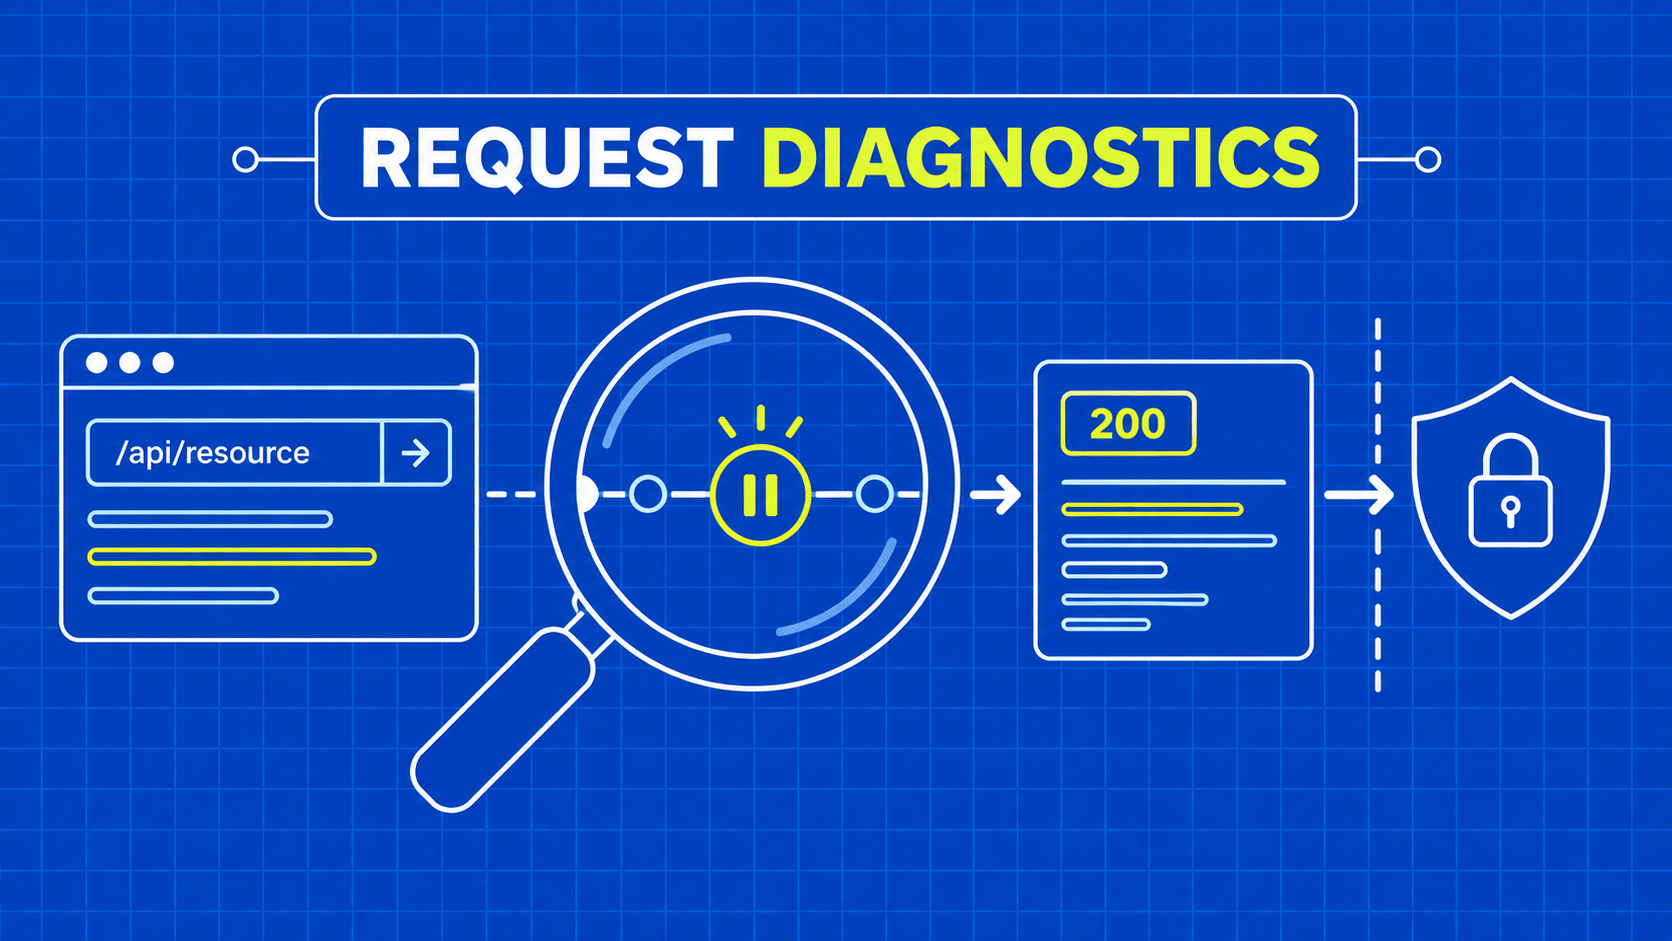
A primeira tarefa não é alternar endereços. É determinar o que mudou, qual a camada que produziu a resposta e se a recolha solicitada continua a ser permitida. Só então é possível escolher uma ação de recuperação proporcionada.
Este guia fornece aos programadores um fluxo de trabalho de diagnóstico e recuperação para a recolha autorizada. Não promete isenção permanente de bloqueios nem ensina uma estratégia de escalonamento contra os controlos de acesso. O objetivo é uma tarefa fiável e explicável, capaz de distinguir uma falha técnica recuperável de um pedido que deva ser interrompido para revisão.