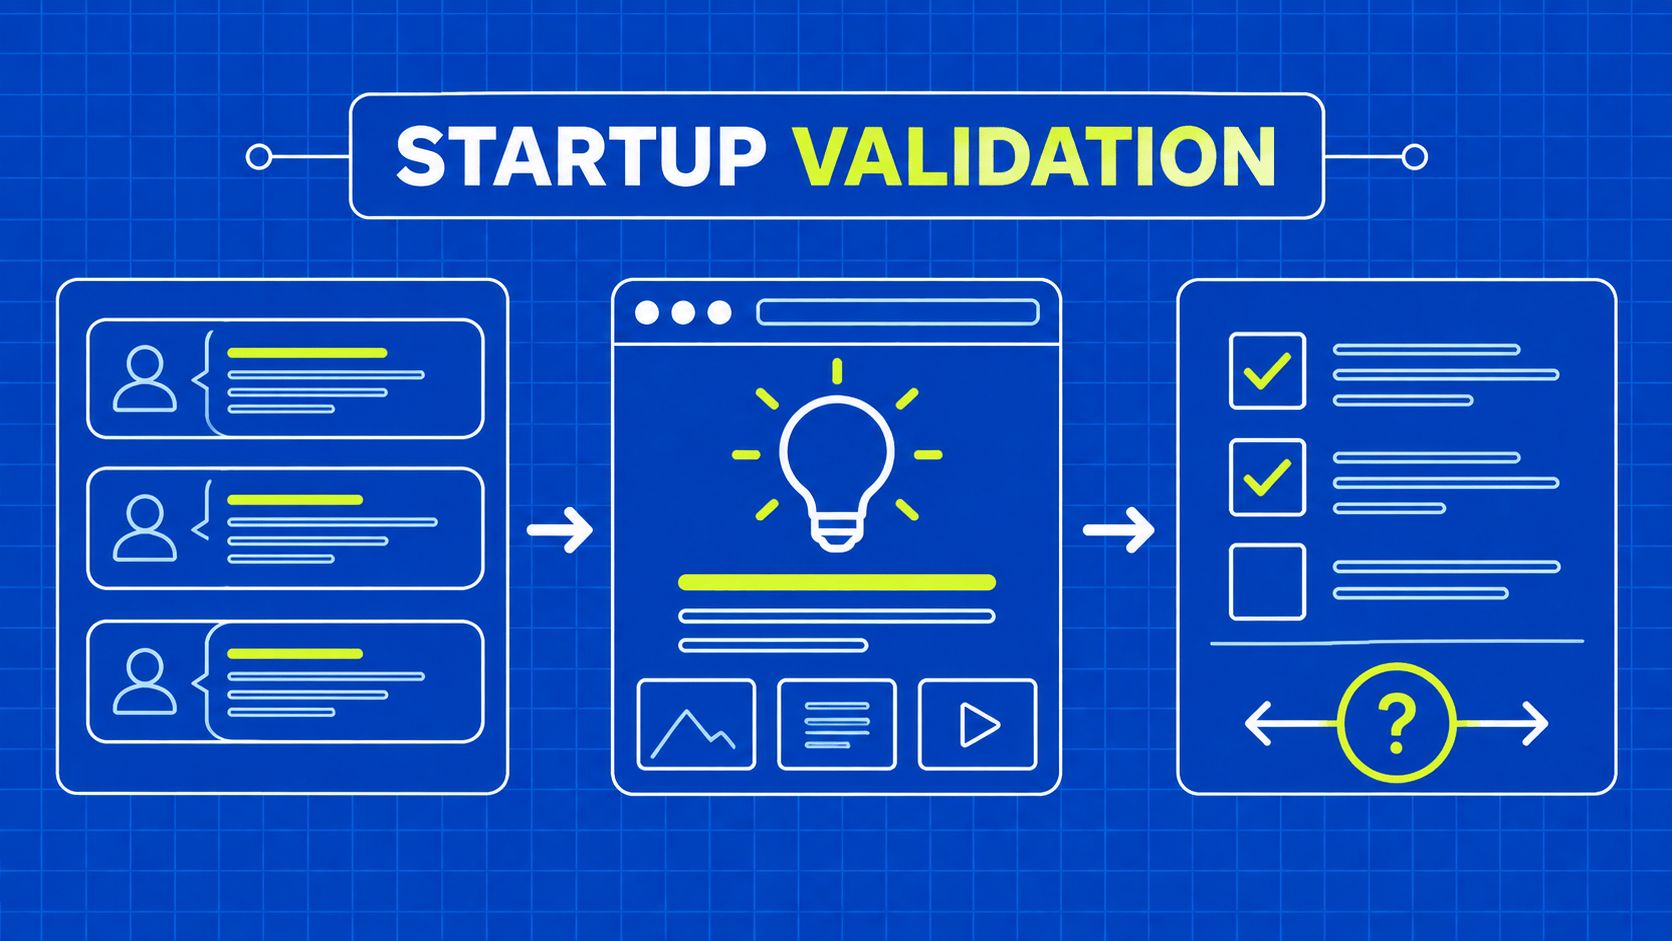
Resumo: A extração de dados da Web (web scraping) para startups é útil quando as evidências recolhidas podem alterar uma decisão específica relativa ao lançamento. Defina primeiro essa decisão, crie um conjunto de dados autorizado e restrito, teste a sua fiabilidade e combine as conclusões com a investigação junto dos utilizadores, em vez de tratar a atividade pública na Web como prova de procura.
Imagine uma pequena equipa a considerar um serviço que ajude oficinas de reparação a comparar a disponibilidade de peças de substituição publicamente divulgada. Os fundadores acreditam que os funcionários perdem tempo a consultar várias páginas de fornecedores. Antes de criarem uma plataforma, precisam de saber se as fontes disponibilizam informações comparáveis e se uma visão consolidada melhoraria efetivamente o trabalho da oficina.
Essa é uma função útil do web scraping para as startups: recolher evidências delimitadas para testar pressupostos antes de se comprometerem com um produto de maior dimensão. Não se trata de um atalho para provar a adequação do produto ao mercado. Os dados disponíveis na Web podem mostrar o que os fornecedores publicam, mas não conseguem determinar quem irá pagar, em que fluxo de trabalho os utilizadores confiam ou se a sua equipa consegue sustentar o serviço.
Este guia transforma esse cenário hipotético de peças de reparação num processo prático de validação. O cenário e os testes propostos são ilustrativos, não constituindo um resultado relatado por uma startup. Não estão implícitos quaisquer resultados relativos a receitas, conversão ou dimensão do mercado.
O resultado final é um pacote de decisão: um pequeno conjunto de dados revisto, um registo das suas limitações, conclusões da investigação com utilizadores e um critério de lançamento claro. Uma experiência útil pode levar a um âmbito mais restrito, a uma estratégia de fontes diferente ou à decisão de não lançar. Descobrir uma limitação numa fase inicial é um resultado válido.