Saltar para o conteúdo
Comece grátis

Blog

Perspetivas e Engenharia

Análises aprofundadas sobre a infraestrutura de dados da Web, técnicas de extração e o futuro dos dados estruturados em grande escala.

Artigos mais recentes

156 artigos

As 10 melhores ferramentas de web scraping com IA para 2026
Guias

As 10 melhores ferramentas de web scraping com IA para 2026

TL;DR: Não existe um único scraper de IA que seja ideal para todas as tarefas. Compare 10 ferramentas com base no método de extração, tipo de utilizador, operações e custo e, em seguida, recorra a um plano de teste prático para escolher a opção mais adequada.

Suciu Dan24 min read
Ler artigo
XPath Web Scraping: Um guia prático com exemplos em Python
Guias

XPath Web Scraping: Um guia prático com exemplos em Python

TL;DR: XPath é uma linguagem de consulta para navegar em árvores HTML/XML por caminho, atributo ou conteúdo de texto. Este guia aborda a sintaxe, os eixos e as funções XPath e, em seguida, mostra scrapers Python funcionais com lxml e Selenium. Você também terá uma folha de dicas consolidada e uma seção de solução de problemas para os erros mais comuns do XPath.

Suciu Dan11 min read
Ler artigo
Cabeçalhos de resposta HTTP no cURL: Cada flag, técnica e receita de scripting
A ciência da extração de dados da Web

Cabeçalhos de resposta HTTP no cURL: Cada flag, técnica e receita de scripting

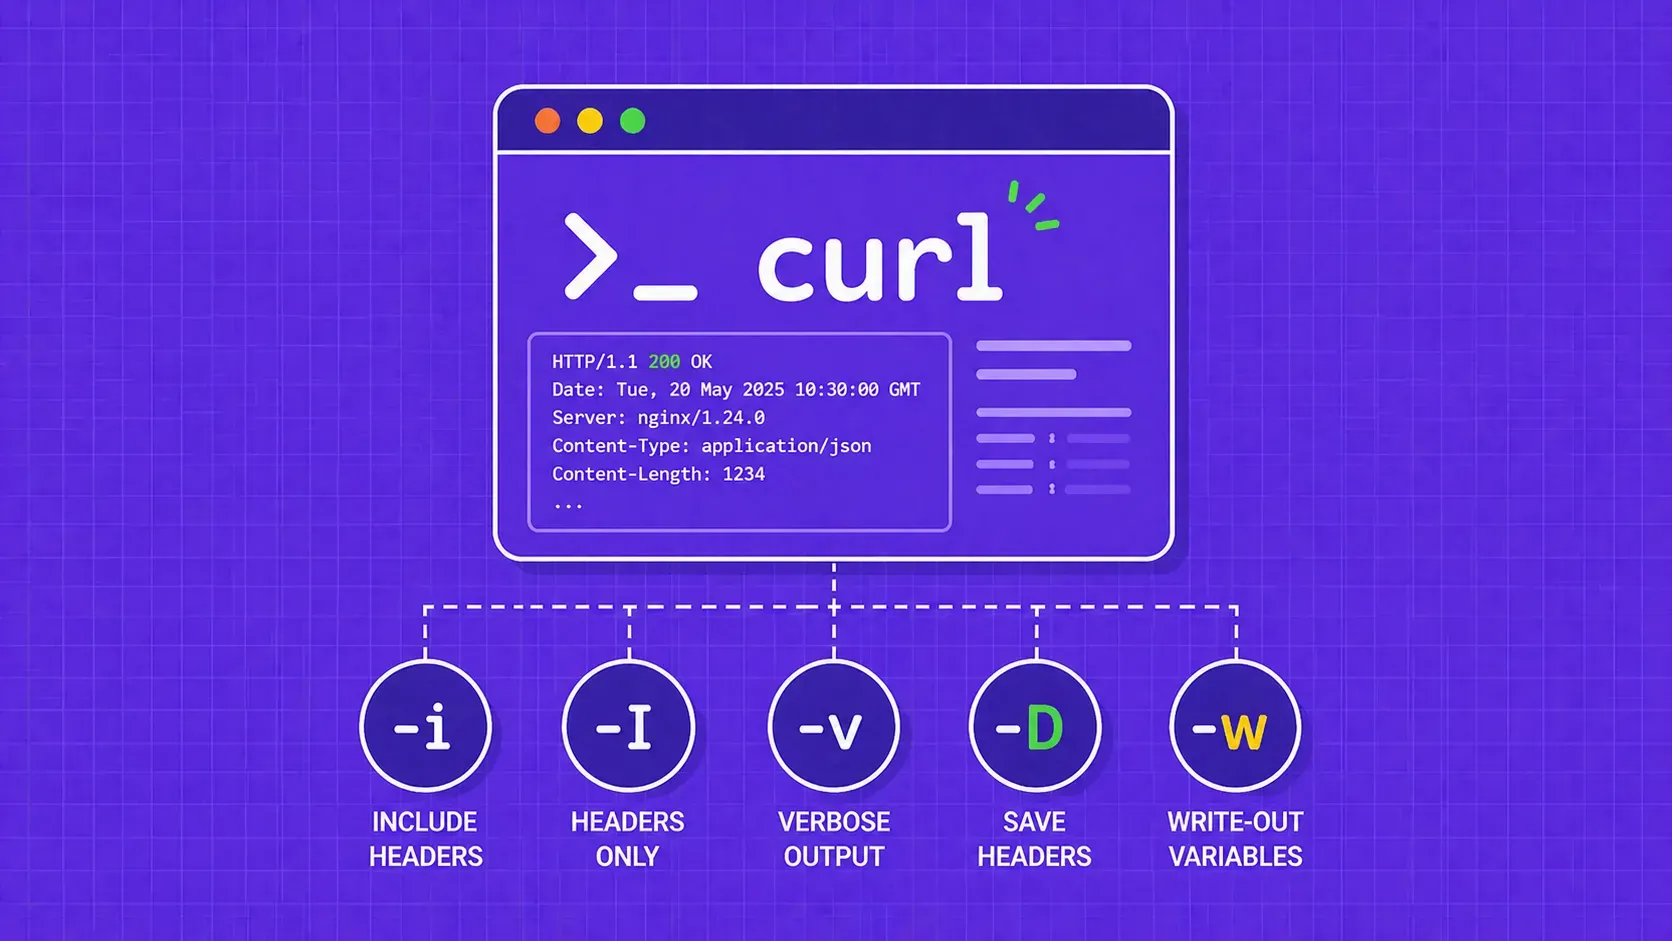
TL;DR: O cURL esconde os cabeçalhos de resposta por padrão. Use -i para ver os cabeçalhos junto com o corpo, -I para uma solicitação HEAD que retorna apenas cabeçalhos, -v para depuração completa de solicitação/resposta e -D para salvar cabeçalhos em um arquivo. Para scripts modernos, o cURL 7.83+ permite extrair cabeçalhos individuais ou despejar todos eles como JSON com a opção -w write-out.

Suciu Dan12 min read
Ler artigo
O que é um navegador sem cabeça? Arquitetura, casos de utilização e principais ferramentas
A ciência da extração de dados da Web

O que é um navegador sem cabeça? Arquitetura, casos de utilização e principais ferramentas

TL;DR: Um navegador sem cabeça é um navegador web que funciona sem uma interface gráfica visível, controlado inteiramente através de código ou instruções de linha de comando. Os desenvolvedores usam navegadores headless para testes automatizados, raspagem da Web, monitoramento de desempenho e, cada vez mais, para alimentar agentes de IA. Este guia aborda como eles funcionam internamente, quando escolher um em vez de um navegador normal e quais estruturas valem o seu tempo.

Suciu Dan15 min read
Ler artigo
Tutorial do Scrapy Playwright: Extrair sites com muito JavaScript em escala
Guias

Tutorial do Scrapy Playwright: Extrair sites com muito JavaScript em escala

TL;DR: O Scrapy-Playwright permite renderizar páginas pesadas em JavaScript diretamente dentro de spiders Scrapy, controlando navegadores reais Chromium, Firefox ou WebKit através do Playwright. Este tutorial guia-o através da instalação, configuração, interações de páginas, interceção AJAX, anti-deteção, e uma estrutura de projeto pronta a produzir para que possa fazer scraping de sites dinâmicos sem sair do ecossistema Scrapy.

Raluca Penciuc20 min read
Ler artigo
Extrair dados do Expedia com Python: hotéis e preços
Guias

Extrair dados do Expedia com Python: hotéis e preços

TL;DR: Extraia os anúncios de hotéis da Expedia com Python, utilizando renderização em JS, proxies, seletores CSS e paginação; em seguida, limpe e exporte os dados para CSV.

Mihai Maxim13 min read
Ler artigo

Comece a construir

Pronto para expandir a sua recolha de dados?

Junte-se a mais de 2.000 empresas que utilizam a WebScrapingAPI para extrair dados da Web à escala empresarial, sem quaisquer custos de infraestrutura.