Saltar para o conteúdo
Comece grátis

Blog

Perspetivas e Engenharia

Análises aprofundadas sobre a infraestrutura de dados da Web, técnicas de extração e o futuro dos dados estruturados em grande escala.

Artigos mais recentes

156 artigos

Guia da API de extração de resultados de pesquisa (SERP): Google, Bing, DuckDuckGo, Yandex
Guias

Guia da API de extração de resultados de pesquisa (SERP): Google, Bing, DuckDuckGo, Yandex

TL;DR: Envie o seu primeiro pedido à API SERP da WebScrapingAPI com a chave definida numa variável de ambiente; em seguida, filtre os resultados do Google por país, idioma e dispositivo; leia os ficheiros JSON do Google e do Bing de forma defensiva; extraia você mesmo o HTML do DuckDuckGo e do Yandex; execute tarefas assíncronas do Google; repita a tentativa de acordo com os códigos de erro documentados e defina um plano com base nos preços do Google a partir de outubro de 2026.

Suciu Dan25 min read
Ler artigo
Como utilizar a API do Amazon Scraper: Guia de início rápido
Guias

Como utilizar a API do Amazon Scraper: Guia de início rápido

TL;DR: Comece a utilizar a API Amazon Scraper da WebScrapingAPI: envie o seu primeiro pedido, escolha entre nove tipos de pedidos (produto, pesquisa, mais vendidos, promoções, avaliações de vendedores e muito mais), selecione 20 mercados da Amazon, analise todas as respostas JSON, lide com erros e novas tentativas e escolha um plano.

Robert Sfichi24 min read
Ler artigo
Scrapy vs Selenium: Quem ganha?
A ciência da extração de dados da Web

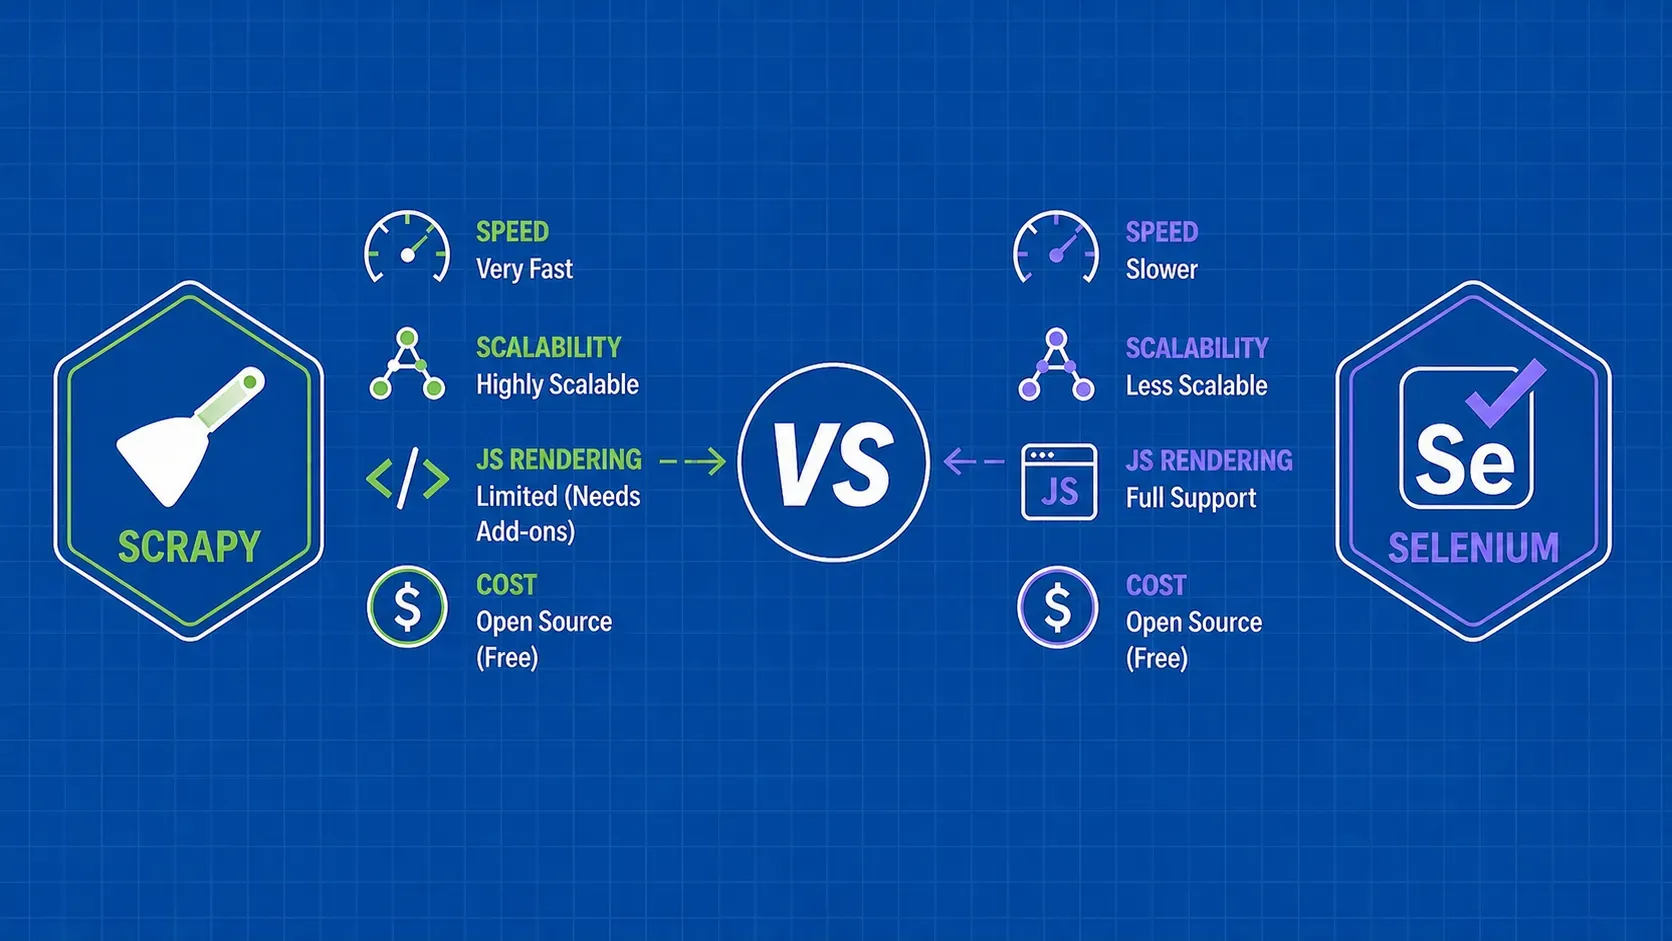
Scrapy vs Selenium: Quem ganha?

TL;DR: O Scrapy é uma estrutura de rastreamento assíncrona e de alta velocidade criada para extrair dados estruturados de páginas estáticas em escala. O Selenium automatiza navegadores reais e lida com sites com muito JavaScript, mas com um custo de recursos muito maior. A maioria dos projetos de raspagem de produção se beneficia de saber quando usar cada um, ou quando combiná-los.

Gabriel Cioci11 min read
Ler artigo
Scrapy vs Beautiful Soup: Que raspador Python escolher
Guias

Scrapy vs Beautiful Soup: Que raspador Python escolher

TL;DR: Scrapy é uma estrutura de rastreamento completa que lida com solicitações, análise e exportação de dados em um único pacote. Beautiful Soup é uma biblioteca de análise leve que pode ser emparelhada com um cliente HTTP, como os pedidos. Escolha o Scrapy quando precisar de rastreamento simultâneo em grande escala com pipelines integrados. Escolha Beautiful Soup quando quiser uma configuração rápida e mínima para analisar um punhado de páginas.

Mihnea-Octavian Manolache12 min read
Ler artigo
Tutorial do Scrapy Splash: Renderizar páginas JavaScript
Guias

Tutorial do Scrapy Splash: Renderizar páginas JavaScript

TL;DR: O Scrapy Splash emparelha o mecanismo de rastreamento rápido do Scrapy com o navegador sem cabeça Splash para renderizar páginas pesadas em JavaScript. Este tutorial do Scrapy Splash guia você através da configuração do Docker, configuração do projeto Scrapy, noções básicas do SplashRequest, scripts Lua para rolagem e clique, integração de proxy e correção dos erros mais comuns que você encontrará.

Ștefan Răcilă13 min read
Ler artigo
Extrair dados de produtos da Amazon com Python: Guia Prático
Guias

Extrair dados de produtos da Amazon com Python: Guia Prático

TL;DR: As páginas de produtos da Amazon estão repletas de dados valiosos (preços, classificações, avaliações, ASINs), mas extraí-los de forma confiável requer mais do que uma solicitação HTTP básica. Este guia o orienta na construção de um scraper Python com Requests e BeautifulSoup, lidando com paginação e defesas anti-bot, exportando para CSV ou JSON e alimentando os resultados em fluxos de trabalho LLM. Você também aprenderá quando usar uma API de raspagem em vez de desenvolver sua própria solução.

Raluca Penciuc18 min read
Ler artigo

Comece a construir

Pronto para expandir a sua recolha de dados?

Junte-se a mais de 2.000 empresas que utilizam a WebScrapingAPI para extrair dados da Web à escala empresarial, sem quaisquer custos de infraestrutura.