Saltar para o conteúdo
Comece grátis
Voltar ao blogue

Como extrair dados do Twitter (X) para análise de sentimentos

Raluca PenciucÚltima atualização em 24 min read
Como extrair dados do Twitter (X) para análise de sentimentos

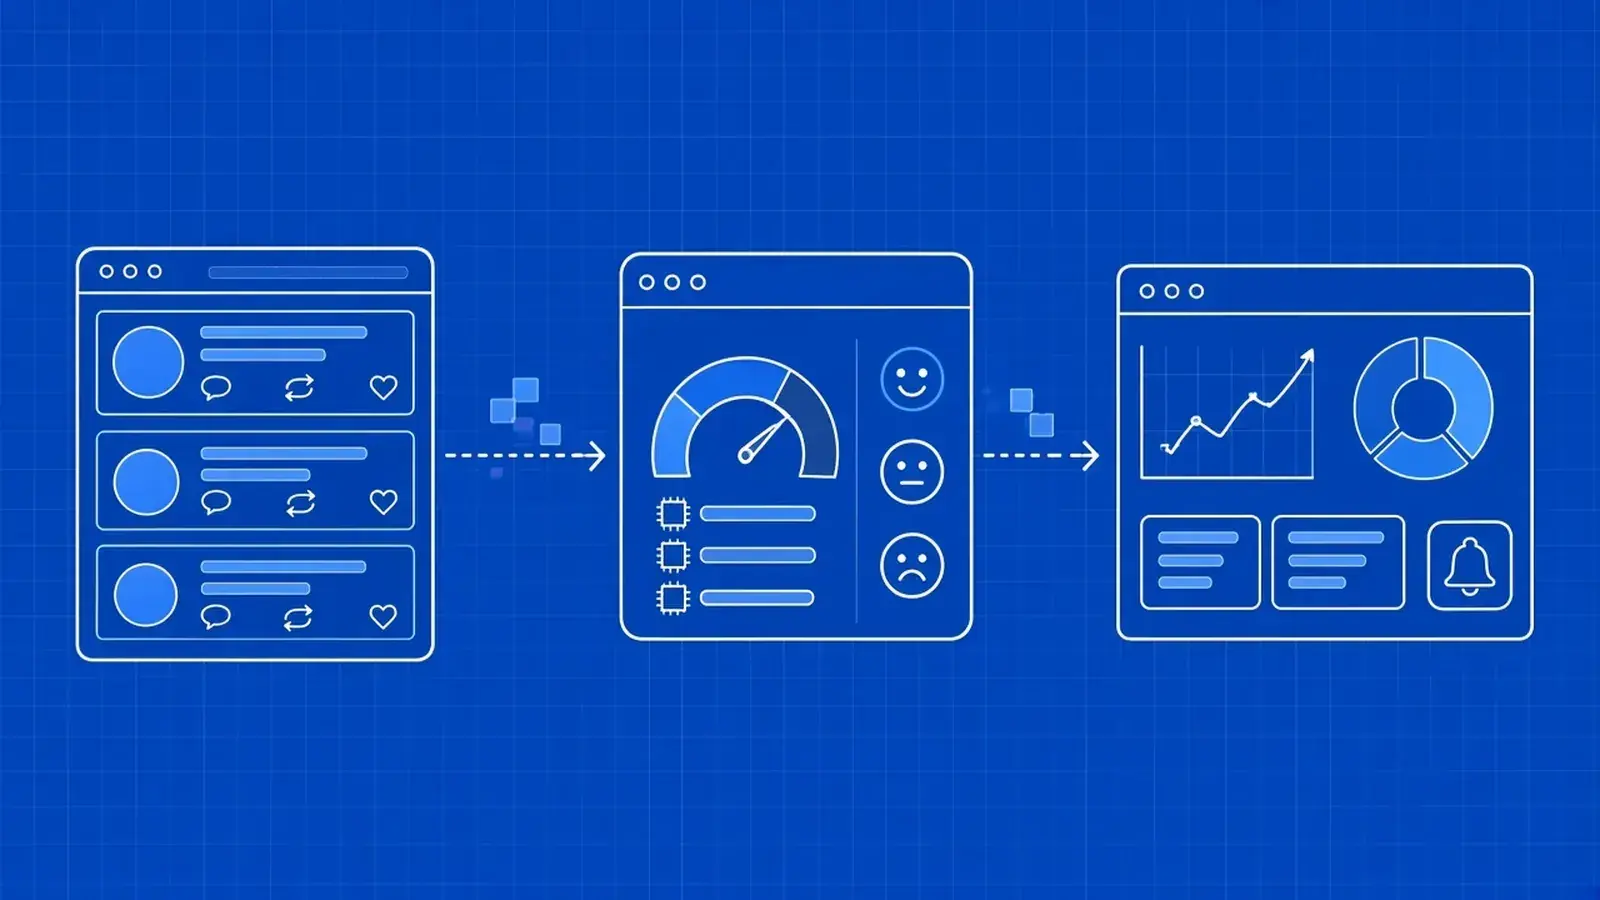
Uma equipa de marketing quer saber o que as pessoas no X (Twitter) pensam sobre a sua marca, um lançamento ou um concorrente, e alguém tem de recolher as publicações e classificá-las. A extração de dados do Twitter (X) consiste em recolher publicações públicas, perfis e contagens de interação do X de forma programática, para que possa analisá-los em massa. Antes de extrair dados do Twitter, saiba que o X restringe a extração nos seus próprios termos. Este guia começa por explicar o que pode recolher e o que dizem as regras do X, compara a API oficial, os dados geridos e as páginas públicas renderizadas e, em seguida, aborda a parte que a maioria dos guias ignora: limpar as publicações, classificar o sentimento em Python e transformar as pontuações em métricas que uma equipa de marketing possa utilizar.

Resumo: Os termos do X proíbem o rastreamento ou a extração de dados sem o seu consentimento prévio por escrito; por isso, escolha a sua via de acesso antes de escrever código. A API oficial do X é o caminho documentado para a pesquisa por palavras-chave e a monitorização. Guarde cada publicação com o seu ID e dois registos de data e hora. Classifique-a com o VADER e, depois, com um modelo Transformer otimizado para o Twitter, e agregue os resultados em sentimento líquido e quota de voz.

Pontos-chave

  • Os termos do X proíbem o rastreamento ou a extração de dados sem o seu consentimento prévio por escrito; por isso, escolha a sua via de acesso antes de escrever código.
  • A API oficial do X é o caminho documentado para a pesquisa por palavras-chave e a monitorização contínua.
  • As páginas sem sessão iniciada apresentam dados limitados. A pesquisa, as cronologias completas e as listas de seguidores só estão disponíveis após o início de sessão.
  • Armazene cada publicação com o seu ID e dois registos de data e hora: quando foi publicada e quando a recolheu.
  • Comece com uma linha de base do VADER, passe para um transformador otimizado para o Twitter e, em seguida, agregue os resultados para obter o sentimento líquido e a quota de voz.
Que dados do X (Twitter) pode recolher?

O Twitter foi renomeado para X em 2023, e o twitter.com redireciona agora para o x.com. A plataforma, os dados e a maioria das ferramentas para programadores mantiveram-se inalterados, razão pela qual os caminhos da API e as bibliotecas ainda referem «tweet». Este guia utiliza a publicação (tweet) como unidade de dados e, daqui em diante, refere-se a ela como «publicação».

O que pode aceder depende de estar a consultar o site sem sessão iniciada ou a utilizar a API oficial:

Dados

Site sem sessão iniciada

API oficial do X

Notas

Publicação pública única (texto, hora, contagens, multimédia)

Normalmente visível

Sim

As contagens são instantâneos que estão em constante mudança.

Perfil público (biografia, localização, URL, data de registo, número de seguidores)

Normalmente visível

Sim

Os campos do perfil são dados pessoais.

Últimas publicações num perfil

Um conjunto limitado

Sim (linha do tempo do utilizador)

As visualizações sem sessão iniciada mostram apenas algumas.

Respostas e conversas

Parcialmente

Sim (pesquisa por conversation_id)

Apenas as primeiras respostas costumam aparecer quando não se está a iniciar sessão.

Pesquisa por palavra-chave ou hashtag

Não (restrição de acesso)

Pesquisa recente (últimos 7 dias), arquivo completo para planos de pagamento por utilização e Enterprise

A pesquisa é o cerne do trabalho de análise de sentimentos.

Listas de seguidores e de pessoas seguidas

Não

Sim (faturado por recurso)

Raramente necessário para a análise de sentimentos.

Contas privadas e mensagens diretas

Não

Não se aplica a este caso de utilização

Fora do âmbito deste guia.

O X altera o que os visitantes que não estão a iniciar sessão podem ver sem aviso prévio, pelo que deve considerar a coluna do meio como uma tendência e não como uma garantia. Na prática, a análise de sentimento requer pesquisa, e a pesquisa no site exige uma conta. Isso leva a maioria dos projetos reais a recorrer à API ou a uma fonte de dados gerida.

Por que razão as equipas recolhem dados do X: da análise de sentimentos ao marketing

O X é um dos poucos locais onde clientes, críticos, jornalistas e concorrentes falam em público e em tempo real, o que o torna uma fonte comum de dados públicos das redes sociais para equipas de marketing e de investigação. A tabela associa cada objetivo a uma métrica e aos campos de que essa métrica necessita.

Objetivo

Métrica

Campos necessários

Sentimento em relação à marca e à campanha

Sentimento líquido por dia

text, created_at, lang

Pesquisa sobre a concorrência e o mercado

Quota de voz, combinação de tópicos

texto, ID do autor, consulta

Sinais de apoio e de crise

Pico de volume negativo vs. valor de referência

texto, data de criação, número de respostas

Descoberta de criadores e parceiros

Taxa de interação por conta

métricas do autor, número de publicações

Conjuntos de dados para PLN e IA

Tamanho do corpus rotulado, equilíbrio de classes

texto, idioma, URL de origem

Começar pela métrica mantém a recolha de dados reduzida. Se precisar apenas do sentimento líquido por dia, não precisa de listas de seguidores nem de biografias de perfis, e recolher menos dados é mais barato e mais fácil de justificar.

Sentimento em relação à marca e à campanha

A tarefa mais comum: acompanhar como o tom das publicações sobre a sua marca evolui de dia para dia e se uma campanha, alteração de preço ou lançamento de produto o altera. Precisa do texto da publicação, da hora em que foi publicada e do idioma, para poder classificar cada publicação e agrupar os resultados por dia.

Pesquisa sobre concorrentes e mercado

Execute as mesmas consultas para a sua marca e para dois ou três concorrentes, e poderá comparar o volume e o tom lado a lado. A quota de voz (a sua quota de todas as publicações entre as marcas monitorizadas) e os tópicos que as pessoas levantam sobre cada marca alimentam diretamente o trabalho de pesquisa de mercado e de posicionamento.

Apoio ao cliente e sinais de crise

Um aumento repentino de publicações negativas surge frequentemente no X antes de chegar à fila de apoio ao cliente. Compare o volume negativo de hoje com uma linha de base contínua e emita um alerta quando este for ultrapassado. A mesma monitorização revela contas falsas de apoio ao cliente e impostores que respondem aos seus clientes, sendo aqui que os dados do X se sobrepõem à proteção da marca.

Descoberta de criadores e conjuntos de dados de PLN

As equipas de marketing utilizam as taxas de envolvimento por conta para selecionar criadores e parceiros que já falam sobre a sua categoria. As equipas de dados utilizam as publicações públicas como texto de treino e avaliação para classificadores. Em ambos os casos, mantenha o URL de origem e o idioma em cada registo para que possa verificar de onde vieram os dados.

Esta secção contém informações gerais, não constitui aconselhamento jurídico. Os termos do X estabelecem que «é expressamente proibido rastrear ou extrair dados dos Serviços sob qualquer forma, para qualquer finalidade, sem o nosso consentimento prévio por escrito», pelo que as vias mais seguras são a API oficial, uma fonte licenciada ou gerida, ou uma utilização que tenha sido analisada pelo seu advogado.

Termos do X. Os Termos de Serviço do X (em vigor a partir de 9 de outubro de 2026, à data da redação deste artigo) limitam o acesso a «interfaces publicadas e atualmente disponíveis», e a cláusula acima consta da lista de utilizações proibidas. O resumo no início dos termos acrescenta que, «salvo se exigido pela legislação aplicável», não é permitido fazer scraping dos serviços sem a autorização expressa por escrito do X nem «tentar contornar quaisquer limitações técnicas que imponhamos».

robots.txt. O ficheiro robots.txt da X proíbe todos os caminhos para rastreadores genéricos (User-agent: * seguido de Disallow: /) e inclui uma linha separada de preferências de treino de IA que exclui a utilização para fins de treino. O robots.txt é uma convenção para indicar aos rastreadores quais os caminhos que podem aceder, descrita na RFC 9309. Não é uma lei, mas é uma declaração clara dos desejos do proprietário do site.

Tribunais. Os tribunais dos EUA têm tratado o acesso a dados públicos ao abrigo da legislação anti-hacking de forma diferente das alegações de que um scraper violou os termos contratuais de um site. As decisões no caso hiQ v. LinkedIn são o exemplo mais conhecido. Os resultados dependem dos factos, das alegações e da jurisdição, pelo que nada disto significa que o scraping do X seja permitido.

Dados pessoais. As publicações e os perfis descrevem pessoas identificáveis, pelo que, na UE e no Reino Unido, constituem dados pessoais ao abrigo do RGPD. É necessária uma base legal nos termos do artigo 6.º do RGPD, como interesses legítimos, e deve recolher apenas os campos necessários para a sua métrica e definir um período de retenção. A visibilidade pública não isenta dessas obrigações.

Conclusão prática. Utilize a API oficial ou uma fonte licenciada ou gerida sempre que possível. Para qualquer outra situação, solicite uma análise jurídica da sua finalidade, fonte e volume antes de começar e planeie uma recolha responsável de dados da Web com base numa finalidade clara e no mínimo de registos de que necessita.

Quatro formas de obter dados do X (Twitter)

Existem quatro vias realistas, que diferem mais em termos de posicionamento e manutenção do que em termos de código:

Via

O que obtém

Esforço

Posição nos termos

Ideal para

API X oficial

Publicações JSON, utilizadores e resultados de pesquisa

Low-code, pagamento por utilização

Interface documentada do X

Pesquisa e monitorização contínua

Dados do X geridos (API de dados WebScrapingAPI)

Registos estruturados e com âmbito definido: IDs, texto, contagens, tópicos, perfis

Não é necessário executar nada

Âmbito acordado por projeto

Equipas que pretendem registos, não coletores

Páginas públicas renderizadas (API Scraper ou API do navegador)

HTML ou campos selecionados de um URL público

Moderado

Sujeito aos termos da X. Obter consentimento ou uma análise jurídica

Verificações pontuais de URLs públicas específicas

Navegadores «faça você mesmo» ou bibliotecas de código aberto

Tudo o que criar e mantiver

Elevado, falhas frequentes

Frequentemente requer contas com sessão iniciada e entra em conflito com os termos do X

Raramente é a escolha certa atualmente

Para pesquisa e monitorização por palavras-chave, comece pela API oficial, que a secção seguinte aborda em código. Se a sua equipa preferir registos prontos a usar em vez de um coletor para manter, a API de Dados do X (Twitter) fornece publicações públicas estruturadas, perfis, threads, respostas e resultados de pesquisa, com a WebScrapingAPI a tratar do acesso à fonte, extração, atualizações do analisador e monitorização da qualidade. Acorda-se as páginas, os campos, o volume e a frequência de atualização após analisar uma amostra. Para um pequeno número de URLs públicas específicas abrangidas pela sua análise jurídica, a Scraper API recebe um URL e devolve HTML, JSON ou campos selecionados, com renderização opcional em JavaScript para páginas que necessitem disso.

Uma breve nota sobre bibliotecas gratuitas: os módulos X do snscrape deixaram de funcionar em 2023 e o twint está arquivado. As ferramentas que ainda funcionam dependem de contas com sessão iniciada e de cookies de sessão, o que acrescenta um risco à conta para além do problema dos termos de utilização. O Puppeteer e o Playwright também conseguem abrir o x.com, mas essa é a via «faça você mesmo», e este guia não a aborda.

Se não tiver a certeza de qual a opção mais adequada, responda a três perguntas. Precisa de uma pesquisa por palavra-chave em todo o X, ou apenas em contas e publicações específicas? A sua equipa pretende gerir um coletor, ou apenas receber registos? E com que frequência os dados precisam de ser atualizados? A pesquisa, aliada a uma pequena equipa de engenharia, aponta normalmente para a API. O trabalho recorrente e com múltiplas fontes, sem uma equipa para manter os coletores, aponta para dados geridos. Um conjunto reduzido de URLs públicas conhecidas é o único caso em que faz sentido renderizar páginas.

Pesquise publicações recentes com a API oficial do X

A API oficial do X é a interface documentada a que os termos do X se referem, e os seus pontos de extremidade de pesquisa foram concebidos exatamente para esta tarefa: a própria documentação do X enumera a monitorização de marcas, a análise de tendências e a investigação como casos de utilização.

Configure o acesso e compreenda o modelo de preços de pagamento por utilização

Crie um projeto e uma aplicação na Consola de Desenvolvedores do X e copie o token de portador da aplicação. Guarde-o numa variável de ambiente em vez de no seu código:

export X_BEARER_TOKEN="your-bearer-token"

A API do X utiliza um modelo de preços de pagamento por utilização: adquire-se créditos antecipadamente na Consola de Desenvolvedores, e os créditos são deduzidos à medida que os pedidos devolvem recursos, a taxas diferentes por ponto de extremidade. Solicitar a mesma publicação novamente no mesmo dia UTC não implica qualquer custo adicional, porque o X deduplica os recursos num intervalo de 24 horas UTC (o X denomina isto uma «garantia flexível»). Dois pontos de extremidade de pesquisa são relevantes neste contexto:

  • Pesquisa recente (GET /2/tweets/search/recent) abrange os últimos 7 dias e está disponível para todos os programadores, com um máximo de 100 publicações por pedido.
  • A pesquisa no arquivo completo (GET /2/tweets/search/all) remonta a 2006 e está disponível para clientes do modelo de pagamento por utilização e do plano Enterprise.

As tarifas variam, por isso verifique os valores atuais na Consola do Desenvolvedor antes de fazer uma estimativa para um projeto e defina um limite de gastos.

Antes de escrever qualquer código de recolha, decida como deve ser uma boa consulta, pois esta controla tanto os seus custos como a qualidade dos seus dados de sentimento. Alguns hábitos ajudam:

  • Abrange as formas como as pessoas realmente referem a sua marca: (AcmeCo OR "Acme Co" OR #acmeco).
  • Exclua as publicações da sua própria conta com -from:AcmeCo para que o seu texto de marketing não inflacione o sentimento positivo.
  • Adicione -is:retweet para ignorar repostagens e considere -is:reply se pretende apenas publicações originais.
  • Filtra por idioma com lang:en quando o seu modelo apenas processar inglês.

As consultas de pesquisa recentes podem ter até 512 caracteres, por isso mantenha listas longas de nomes de produtos em consultas separadas.

Pesquisar publicações com o Tweepy

O Tweepy envolve os endpoints da v2 numa Client classe. O script abaixo pesquisa publicações recentes em inglês que mencionem uma marca, ignora repostagens e percorre os resultados até um limite máximo, para que uma consulta abrangente não esgote os seus créditos:

import os
from datetime import datetime, timezone

import tweepy

client = tweepy.Client(
    bearer_token=os.environ["X_BEARER_TOKEN"],
    wait_on_rate_limit=True,  # sleep until the window resets on a 429
)

QUERY = '"AcmeCo" lang:en -is:retweet'
MAX_POSTS = 500  # hard cap: every returned post costs credits

records = []
collected_at = datetime.now(timezone.utc).isoformat()

for page in tweepy.Paginator(
    client.search_recent_tweets,
    query=QUERY,
    tweet_fields=["created_at", "lang", "public_metrics", "conversation_id", "author_id"],
    expansions=["author_id"],
    user_fields=["username", "public_metrics"],
    max_results=100,
):
    users = {user.id: user for user in (page.includes or {}).get("users", [])}
    for post in page.data or []:
        metrics = post.public_metrics or {}
        author = users.get(post.author_id)
        username = author.username if author else "i"
        records.append({
            "post_id": str(post.id),
            "author_id": str(post.author_id),
            "text": post.text,
            "lang": post.lang,
            "created_at": post.created_at.isoformat(),
            "collected_at": collected_at,
            "like_count": metrics.get("like_count", 0),
            "reply_count": metrics.get("reply_count", 0),
            "repost_count": metrics.get("retweet_count", 0),
            "quote_count": metrics.get("quote_count", 0),
            "conversation_id": str(post.conversation_id),
            "source": "x_api",
            "source_url": f"https://x.com/{username}/status/{post.id}",
            "query": QUERY,
        })
    if len(records) >= MAX_POSTS:
        break

records = records[:MAX_POSTS]
print(f"Collected {len(records)} posts")

Há três detalhes importantes. Os operadores de consulta (lang:en, -is:retweet, frases exatas entre aspas) são executados do lado do X, pelo que filtrar nessa fase custa menos do que filtrar após o download. Campos como created_at e public_metrics só são devolvidos quando solicitados em tweet_fields. E a author_id expansão devolve os objetos de utilizador correspondentes em page.includes, e é assim que se obtêm os nomes de utilizador sem necessidade de um segundo pedido por publicação.

Lidar com limites de taxa

Os limites de taxa são definidos por ponto de extremidade e por intervalo de tempo, normalmente 15 minutos ou 24 horas. Cada resposta contém três cabeçalhos: x-rate-limit-limit, x-rate-limit-remaining, e x-rate-limit-reset (um timestamp Unix que indica quando a janela é reiniciada). Se o limite for excedido, é devolvido um código de estado HTTP 429 até que a janela seja reiniciada.

O Tweepy wait_on_rate_limit=True trata disso por si. Se chamar o endpoint diretamente, leia os cabeçalhos por si próprio:

import os
import time

import requests

URL = "https://api.x.com/2/tweets/search/recent"
HEADERS = {"Authorization": f"Bearer {os.environ['X_BEARER_TOKEN']}"}


def get_page(params, max_retries=3):
    for _ in range(max_retries):
        resp = requests.get(URL, headers=HEADERS, params=params, timeout=30)
        if resp.status_code != 429:
            resp.raise_for_status()
            print("Requests left in this window:", resp.headers.get("x-rate-limit-remaining"))
            return resp.json()
        reset_at = int(resp.headers.get("x-rate-limit-reset", time.time() + 60))
        time.sleep(max(reset_at - time.time(), 1) + 1)
    raise RuntimeError("Still rate limited after retries")


page = get_page({"query": '"AcmeCo" lang:en -is:retweet', "max_results": 100})

A espera pela reinicialização é o comportamento documentado. Não distribua uma tarefa por várias aplicações ou tokens para contornar o limite. Esse é exatamente o tipo de solução alternativa que os termos da X excluem.

Por que razão um pedido HTTP simples devolve uma página vazia no X

Se solicitar um URL de publicação no x.com com um cliente HTTP simples, obterá uma página quase sem texto publicado. O x.com é uma aplicação renderizada pelo cliente: a primeira resposta HTML é um esqueleto, e as publicações chegam posteriormente através de pedidos JSON em segundo plano que o JavaScript da página efetua. Para ver o conteúdo, é necessário um motor de navegador real que execute os scripts — que é o que um navegador sem interface gráfica faz — e esperar até que o elemento da publicação exista.

Muitos tutoriais de scraping do X ignoram o navegador e chamam diretamente esses pontos finais JSON em segundo plano, utilizando tokens de convidado e IDs de consulta internos copiados do tráfego de rede do site. Este guia não faz isso. Esses pontos finais não constituem uma interface publicada, e a sua engenharia reversa é exatamente o tipo de solução alternativa para «limitações técnicas» que os termos do X proíbem. Se precisar de dados em grande escala, a API oficial e os dados geridos são as vias mais fiáveis.

Outras opções: dados geridos e páginas públicas renderizadas

Se a API oficial não for adequada, existem duas outras opções, e nenhuma delas requer código da sua parte. As equipas que pretendem registos completos podem solicitar dados geridos e com âmbito definido do X através da API de Dados do X (Twitter) abordada acima. Para URLs públicas específicas abrangidas pelo consentimento do X ou pela sua análise jurídica, a API do navegador renderiza a página e devolve os campos selecionados em formato JSON. Funciona como uma chamada de pedido/resposta, em vez de uma sessão de navegador ativa que se mantém aberta. Envia-se o URL, um wait_for_css seletor que deve aparecer antes de a página ser considerada pronta, e extract_rules que mapeia os nomes dos campos para seletores CSS. Recebe em resposta HTML renderizado, JSON, os campos selecionados ou uma captura de ecrã. A WebScrapingAPI executa o navegador.

A API do navegador destina-se apenas a páginas públicas elegíveis, e a WebScrapingAPI solicita que reveja os termos da fonte, os requisitos aplicáveis e o seu Acordo de Serviço antes de a utilizar. Os termos da X proíbem a extração de dados sem consentimento prévio por escrito; por isso, obtenha esse consentimento ou uma análise jurídica primeiro, mantenha o volume baixo e nunca inicie sessão nem transmita cookies. Para pesquisa e monitorização, volte à API.

Atributos data-testid do X (apenas para referência)

A par dos nomes de classes gerados que mudam frequentemente, a marcação do X inclui data-testid atributos, que são pontos de ligação mais estáveis. Se os encontrar, eis o que significam os mais comuns:

Campo

Atributo

Contentor de publicação

article[data-testid="tweet"]

Texto da publicação

[data-testid="tweetText"]

Nome e nome de utilizador do autor

[data-testid="User-Name"]

Hora da publicação

time[datetime]

Botões «Responder», «Partilhar» e «Gosto» (contagem em aria-label)

[data-testid="reply"], [data-testid="retweet"], [data-testid="like"]

Imagens

[data-testid="tweetPhoto"] img

Biografia do perfil

[data-testid="UserDescription"]

Localização do perfil, URL e data de registo

[data-testid="UserLocation"], [data-testid="UserUrl"], [data-testid="UserJoinDate"]

Estes são ganchos de teste internos do X, não constituem um contrato público e estão sujeitos a alterações sem aviso prévio. A hora da publicação encontra-se no datetime atributo porque o rótulo visível é relativo («2h») e está localizado. Para a sintaxe do seletor subjacente à correspondência de atributos, consulte a nossa ficha de referência de seletores CSS.

Armazene as publicações num registo organizado

Seja qual for a rota que utilizar, normalize todas as publicações no mesmo registo antes de analisar qualquer coisa. A maioria dos painéis de sentimentos que dão errado falham nesta etapa, devido a publicações contadas duas vezes ou carimbos de data/hora misturados, e não no modelo.

Campo

Significado

post_id

ID da publicação de X e a sua chave de deduplicação

author_id

ID estável da conta (os nomes de utilizador podem mudar)

text, lang

Texto da publicação e etiqueta de idioma do X

created_at

Data e hora em que a publicação foi publicada, em UTC

collected_at

Quando a recolheu, em UTC

like_count, reply_count, repost_count, quote_count

Instantâneo às collected_at. Estão sempre a mudar

conversation_id

Agrupa uma publicação com as suas respostas

source, source_url, query

De onde veio o registo e qual a consulta que o encontrou

Manter created_at e collected_at separar. O sentimento diário deve ser agrupado de acordo com a data de publicação das publicações, enquanto as contagens de interação só fazem sentido em relação ao momento em que as lê. Armazene os registos como linhas JSON, uma publicação por linha, e mantenha apenas o instantâneo mais recente de cada publicação:

import json
from pathlib import Path


def upsert_jsonl(path, new_records):
    path = Path(path)
    latest = {}
    if path.exists():
        with path.open(encoding="utf-8") as f:
            for line in f:
                rec = json.loads(line)
                latest[rec["post_id"]] = rec
    for rec in new_records:
        old = latest.get(rec["post_id"])
        if old is None or rec["collected_at"] >= old["collected_at"]:
            latest[rec["post_id"]] = rec
    with path.open("w", encoding="utf-8") as f:
        for rec in latest.values():
            f.write(json.dumps(rec, ensure_ascii=False) + "\n")
    return len(latest)


total = upsert_jsonl("posts.jsonl", records)
print(f"{total} unique posts stored")

Os carimbos de data/hora ISO 8601 em UTC comparam-se corretamente como cadeias de caracteres, o que simplifica a verificação do instantâneo. Se ainda não estiver familiarizado com o formato, veja aqui como analisar JSON em Python. Por fim, elimine os campos que a sua métrica não utiliza e defina um período de retenção, para que o conjunto de dados não se transforme silenciosamente num arquivo de perfis.

Executar análise de sentimento em X publicações

A análise de sentimento atribui a cada publicação um rótulo (positivo, negativo ou neutro) ou uma pontuação. Os exemplos abaixo utilizam publicações inventadas sobre uma marca fictícia, a AcmeCo, para que possa executá-los offline sem recolher quaisquer dados.

Limpe primeiro o texto

As publicações são curtas e contêm ruído. Uma pequena limpeza torna as pontuações mais consistentes:

  • Substitua os URLs por http e os @nomes de utilizador por @user. Isso corresponde ao pré-processamento com que o modelo otimizado para o Twitter, apresentado abaixo, foi treinado e mantém os nomes de utilizador fora do texto de análise.
  • Mantenha os emojis. Tanto o VADER como o modelo Transformer utilizam-nos como sinais.
  • Elimine duplicados exatos e repostagens puras, que repetem uma opinião várias vezes.
import re

URL_RE = re.compile(r"https?://\S+")
HANDLE_RE = re.compile(r"@\w+")


def clean_text(text):
    text = URL_RE.sub("http", text)
    text = HANDLE_RE.sub("@user", text)
    return " ".join(text.split())


samples = [
    "Just tried the new AcmeCo cold brew and wow, I'm hooked 😍",
    "@acmeco_help my refund request has been ignored for 9 days. Not great.",
    "AcmeCo is opening a store near the station next month https://example.com/news",
    "Oh great, another AcmeCo app update that logs me out. Love that for me.",
]
cleaned = [clean_text(s) for s in samples]

Comece com uma linha de base do VADER

O VADER é uma ferramenta de análise de sentimento baseada em regras, concebida para textos das redes sociais. É rápido, funciona em qualquer lugar e não necessita de dados de treino, o que o torna uma boa linha de base. A sua compound pontuação varia de -1 a 1, e a convenção na documentação do VADER é: 0,05 ou superior é positivo, -0,05 ou inferior é negativo e qualquer valor entre estes dois é neutro.

from vaderSentiment.vaderSentiment import SentimentIntensityAnalyzer

analyzer = SentimentIntensityAnalyzer()


def vader_label(text):
    compound = analyzer.polarity_scores(text)["compound"]
    if compound >= 0.05:
        return "positive", compound
    if compound <= -0.05:
        return "negative", compound
    return "neutral", compound


for text in cleaned:
    label, score = vader_label(text)
    print(f"{label:8} {score:+.3f}  {text}")

Execute-o e observe atentamente a quarta amostra. Expressões como «Oh, ótimo» e «Adoro isso» fazem com que uma pontuação baseada no léxico se incline para o positivo, mesmo que a publicação seja uma reclamação. Mantenha essa amostra no seu conjunto de teste: o sarcasmo é um desafio para todos os modelos, incluindo o transformador na próxima etapa, e é um lembrete útil de que nenhuma pontuação substitui a leitura de uma amostra das publicações.

Mude para um Transformer otimizado para o Twitter

O `cardiffnlp/twitter-roberta-base-sentiment-latest` é um modelo baseado no RoBERTa, treinado com cerca de 124 milhões de tweets de 2018 a 2021 e ajustado para a análise de sentimentos com o benchmark TweetEval. Ele devolve negative, neutralou positive com uma pontuação de confiança, e a ficha do modelo descreve-o como adequado para o inglês.

from transformers import pipeline

sentiment = pipeline(
    "sentiment-analysis",
    model="cardiffnlp/twitter-roberta-base-sentiment-latest",
    truncation=True,
)

for text, result in zip(cleaned, sentiment(cleaned, batch_size=32)):
    print(f"{result['label']:8} {result['score']:.3f}  {text}")

O transformador lê as palavras no contexto, pelo que normalmente lida melhor com expressões informais, gíria e emojis do que uma lista de palavras. A desvantagem é a velocidade: é muito mais lento do que o VADER numa CPU e, para lotes grandes, uma GPU ajuda. Um padrão comum é manter o VADER como uma verificação rápida de plausibilidade e utilizar o Transformer para os números que apresenta. Se os dois discordarem muito em relação aos teus dados, essa também é uma informação útil: analisa uma amostra das discordâncias, pois estas apontam frequentemente para sarcasmo, nomes de produtos que o léxico interpreta mal ou publicações que não têm nada a ver com a tua marca.

Onde os modelos de sentimento erram

Esteja atento a estes modos de falha antes de colocar números num painel de controlo:

  • Sarcasmo e ironia. «Adoro isso por mim» após uma reclamação é interpretado como positivo por muitos modelos.
  • Publicações com citações. Uma publicação com uma citação pode inverter o significado da publicação que cita, e a avaliação apenas do texto não detecta isso.
  • Bots e picos de spam. Sorteios, campanhas coordenadas e respostas copiadas e coladas podem sobrecarregar os resultados de um dia. Filtra as publicações quase duplicadas e analisa o volume por conta.
  • Publicações que não estejam em inglês. Ambos os modelos acima estão otimizados para o inglês. Filtra por lang campo ou utilize um modelo multilingue.
  • Amostras pequenas. Um dia com 12 publicações pode oscilar entre muito positivo e muito negativo. Apresente o volume ao lado do sentimento e utilize categorias mais amplas quando as contagens forem baixas.

Antes de confiar em qualquer um dos modelos para o seu tema, rotule manualmente cerca de 200 publicações a partir dos seus próprios dados e compare. Nomes de marcas, gíria relacionada com produtos e termos do setor alteram a forma como o texto é interpretado, e uma verificação rápida indica-lhe qual o modelo e quais os limiares mais adequados.

Transforme o sentimento em métricas de marketing

As pontuações de publicações individuais não ajudam uma equipa de marketing. Os agregados diários, sim. Partindo do princípio de que cada registo tem agora uma label coluna proveniente do modelo, este script em pandas calcula quatro métricas por consulta monitorizada: sentimento líquido, quota de voz, sentimento ponderado pelo envolvimento e um indicador de alerta para picos negativos.

import numpy as np
import pandas as pd

df = pd.read_json("posts_scored.jsonl", lines=True)
df["day"] = pd.to_datetime(df["created_at"], utc=True).dt.floor("D")
df["polarity"] = df["label"].map({"positive": 1, "neutral": 0, "negative": -1})
df["engagement"] = df[["like_count", "reply_count", "repost_count", "quote_count"]].sum(axis=1)
df["weight"] = 1 + np.log1p(df["engagement"])
df["weighted_polarity"] = df["polarity"] * df["weight"]

daily = df.groupby(["query", "day"]).agg(
    posts=("post_id", "count"),
    pos=("polarity", lambda s: (s == 1).sum()),
    neg=("polarity", lambda s: (s == -1).sum()),
    weighted_polarity=("weighted_polarity", "sum"),
    weight=("weight", "sum"),
)
daily["net_sentiment"] = (daily["pos"] - daily["neg"]) / daily["posts"]
daily["share_of_voice"] = daily["posts"] / daily.groupby(level="day")["posts"].transform("sum")
daily["weighted_sentiment"] = daily["weighted_polarity"] / daily["weight"]

daily["neg_share"] = daily["neg"] / daily["posts"]
by_query = daily.groupby(level="query")["neg_share"]
baseline = by_query.transform(lambda s: s.rolling(14, min_periods=7).mean().shift(1))
spread = by_query.transform(lambda s: s.rolling(14, min_periods=7).std().shift(1))
daily["alert"] = daily["neg_share"] > baseline + 2 * spread

print(daily[["posts", "net_sentiment", "share_of_voice", "weighted_sentiment", "alert"]].tail(10))

O sentimento líquido corresponde às publicações positivas menos as negativas, dividido pelo total de publicações, pelo que varia entre -1 e 1. A quota de voz só faz sentido quando todas as consultas na comparação foram recolhidas da mesma forma, com os mesmos filtros. A ponderação logarítmica impede que uma publicação viral ofusque tudo o resto, e o alerta compara cada dia com os 14 dias anteriores para essa consulta, em vez de o fazer com um número fixo. Lembre-se de que as contagens de interação são instantâneos: uma publicação recolhida uma hora após a publicação parecerá ter menos interação do que uma recolhida um dia depois; por isso, recolha os dados num horário fixo ou volte a recolher as contagens das publicações recentes antes de comparar dias.

Ao apresentar estes números, coloque a contagem de publicações ao lado de cada valor de sentimento e associe cada pico a uma amostra das publicações subjacentes, para que as pessoas possam perceber o que o motivou. Um painel que mostre «o sentimento líquido caiu 0,3» sem as publicações subjacentes leva a conclusões erradas. Anote eventos conhecidos, tais como lançamentos, interrupções de serviço, alterações de preços e campanhas, para que a equipa consiga distinguir uma reação do ruído. E volte a verificar a sua amostra rotulada manualmente a cada poucos meses, porque a forma como as pessoas falam sobre uma marca muda, e um modelo que se adequava às publicações do último trimestre pode desviar-se.

FAQ

Os termos do X proíbem o rastreio ou a extração de dados sem o seu consentimento prévio por escrito, e o seu ficheiro robots.txt não permite rastreadores genéricos. Os tribunais têm tratado de forma diferente o acesso a dados públicos e as reclamações contratuais, e os resultados dependem dos factos. Utilize a API oficial ou uma fonte licenciada sempre que possível e procure aconselhamento jurídico antes de tentar qualquer outra coisa.

É possível fazer scraping do X sem a API?

As páginas públicas renderizadas mostram algumas publicações e perfis, mas a pesquisa, as cronologias completas e as listas de seguidores estão protegidas por um login, e os termos do X restringem o scraping sem consentimento. Para pesquisa por palavras-chave e monitorização, a API oficial do X ou uma fonte de dados gerida é a via mais fiável, e proporciona-lhe campos estruturados em vez de HTML para analisar.

É possível ver publicações do X sem iniciar sessão?

Os visitantes que não estão a iniciar sessão podem, normalmente, abrir uma única publicação pública e um perfil público com um conjunto limitado de publicações recentes. A pesquisa e a maioria das listas exigem uma conta, e o X altera o que está visível sem aviso prévio. Verifique o que está efetivamente disponível antes de criar qualquer coisa que dependa do acesso sem iniciar sessão e prepare-se para que isso mude.

O snscrape ainda funciona para o Twitter?

Não. Os módulos do snscrape para o Twitter deixaram de funcionar em 2023 e o twint está arquivado. As alternativas mantidas dependem de contas com sessão iniciada e de cookies de sessão, o que acrescenta um risco à conta, para além do problema dos termos de utilização. A API oficial do X, com os seus pontos de extremidade de pesquisa de publicações recentes e do arquivo completo, é a substituição documentada para a pesquisa por palavra-chave.

O X é o mesmo que o Twitter para fins de scraping?

Sim. O Twitter foi renomeado para X em 2023, e o twitter.com redireciona para o x.com. A plataforma, os dados e a API são os mesmos, e muitos caminhos de pontos de extremidade, métodos de bibliotecas e nomes de modelos ainda utilizam «tweet». Procure ambos os nomes quando consultar a documentação, uma vez que os guias mais antigos utilizam «Twitter» em todo o texto.

Qual é o melhor modelo de sentimento para tweets?

Comece com o VADER para obter uma base de referência rápida e baseada em regras que funciona em qualquer lugar. Para obter melhores resultados em publicações informais, utilize um modelo treinado com tweets, como o Twitter RoBERTa da cardiffnlp. Seja qual for a sua escolha, verifique-o com base em algumas centenas de publicações rotuladas manualmente sobre o seu próprio tema antes de apresentar os resultados obtidos.

Quanto custa a API do X?

A API do X utiliza um modelo de preços de pagamento por utilização. Adquire-se créditos na Consola do Desenvolvedor e cada pedido deduz créditos com base nos recursos que devolve, a taxas diferentes por ponto de extremidade. As taxas variam, por isso consulte a página de preços para desenvolvedores do X e defina um limite de despesas antes de estimar o custo de um projeto.

Conclusão

Passar das publicações do X para uma resposta de marketing é um processo em cadeia: escolha uma via de acesso que cumpra os termos do X, armazene cada publicação como um registo limpo com um ID e dois carimbos de data/hora, atribua-lhe uma pontuação com base numa linha de referência e, em seguida, num modelo otimizado para o Twitter, e agregue as pontuações para obter o sentimento líquido diário, a quota de voz e os alertas. A API oficial abrange a pesquisa, os dados geridos destinam-se a equipas que pretendem registos finalizados e a renderização permanece limitada a páginas públicas específicas abrangidas pela sua análise jurídica. Os passos de análise são os mesmos independentemente da via que escolher, pelo que pode mudar de via posteriormente sem ter de reconstruir o seu painel de controlo.

Renderize páginas públicas e obtenha campos limpos

Envie um URL público para a API do Scraper e obtenha HTML ou campos selecionados em formato JSON, com renderização em JavaScript quando a página assim o exigir. Comece com 5 000 pedidos gratuitos. Os pedidos falhados não são faturados e não há créditos adicionais para a renderização em JavaScript ou a segmentação geográfica.

Consulte os preços da API do Scraper

Sobre o autor

Raluca Penciuc, Desenvolvedor Full-Stack @ WebScrapingAPI

Raluca Penciuc

Desenvolvedor Full-Stack

Raluca Penciuc é programadora Full Stack na WebScrapingAPI, onde desenvolve scrapers, aperfeiçoa estratégias de evasão e procura formas fiáveis de reduzir a deteção nos sites-alvo.

Web Scraping com AWS Lambda: Guia para Python e Java 2026
Guias

Web Scraping com AWS Lambda: Guia para Python e Java 2026

TL;DR: Resumo: A extração de dados da Web com o AWS Lambda funciona melhor quando cada invocação é curta, delimitada e pode ser repetida de forma independente. Comece com HTTP direto, AWS SAM e S3 e, só depois, adicione SQS, contentores, renderização no navegador, proxies ou uma camada de recuperação gerida, apenas quando a carga de trabalho demonstrar que precisa deles.

Suciu Dan32 min read
Ler artigo
Como utilizar o GoSpider: rastrear, limpar URLs e extrair dados
Guias

Como utilizar o GoSpider: rastrear, limpar URLs e extrair dados

TL;DR: Resumo: O GoSpider é um rastreador de linha de comandos destinado a descobrir URLs, não um extrator completo de dados estruturados. Este guia sobre como utilizar o GoSpider mostra como realizar um rastreio limitado, gerir resultados de forma organizada, fazer a transferência de dados do Colly para CSV e seguir um percurso de diagnóstico para respostas 403 ou páginas que exijam renderização em JavaScript.

Suciu Dan23 min read
Ler artigo
Como fazer o Scrape Redfin: Guia Python para Dados de Propriedade
Guias

Como fazer o Scrape Redfin: Guia Python para Dados de Propriedade

TL;DR: A Redfin expõe pontos de extremidade de API ocultos que retornam JSON estruturado para listagens de propriedades, tornando possível ignorar totalmente a análise HTML frágil. Este guia orienta-o na construção de um scraper Python que extrai dados de aluguer e venda, pesquisa por localização, monitoriza novas listagens através de sitemaps XML e exporta resultados limpos para CSV ou JSON.

Suciu Dan14 min read
Ler artigo

Comece a construir

Pronto para expandir a sua recolha de dados?

Junte-se a mais de 2.000 empresas que utilizam a WebScrapingAPI para extrair dados da Web à escala empresarial, sem quaisquer custos de infraestrutura.