
Saltar para o conteúdo
Comece grátis
Voltar ao blogue

Cheerio Web Scraping em Node.js: load() para um scraper testado

Raluca PenciucÚltima atualização em 20 min read
Cheerio Web Scraping em Node.js: load() para um scraper testado
Resumo: O Cheerio é um analisador de HTML rápido para Node.js com uma API ao estilo jQuery, por isso serve para web scraping quando os dados já estão no HTML bruto da página. Utilize fetch com o Cheerio para páginas estáticas, chame diretamente o JSON quando a página carrega os dados assim e renderize com um navegador apenas quando o JavaScript constrói o conteúdo. Este guia constrói um scraper testado com paginação, novas tentativas e exportação para JSON ou CSV.

No final deste guia, terá um scraper Cheerio que carrega uma página, extrai campos preenchidos, segue a paginação, tenta novamente de forma educada quando o servidor rejeita a solicitação, guarda os resultados em JSON e CSV e passa num teste offline. Os exemplos em tempo real utilizam os sites books.toscrape.com e quotes.toscrape.com, dois sites de treino criados para a extração de dados, pelo que pode executar o código tal como está. Também aprenderá a identificar as páginas que o Cheerio não consegue ler e a corrigir os erros do `cheerio.load` que mais causam dificuldades aos utilizadores. É novo no scraping com Node? Comece com o nosso guia sobre web scraping com JavaScript e Node.js.
O que é o Cheerio e quando deve utilizá-lo para a extração de dados da Web?

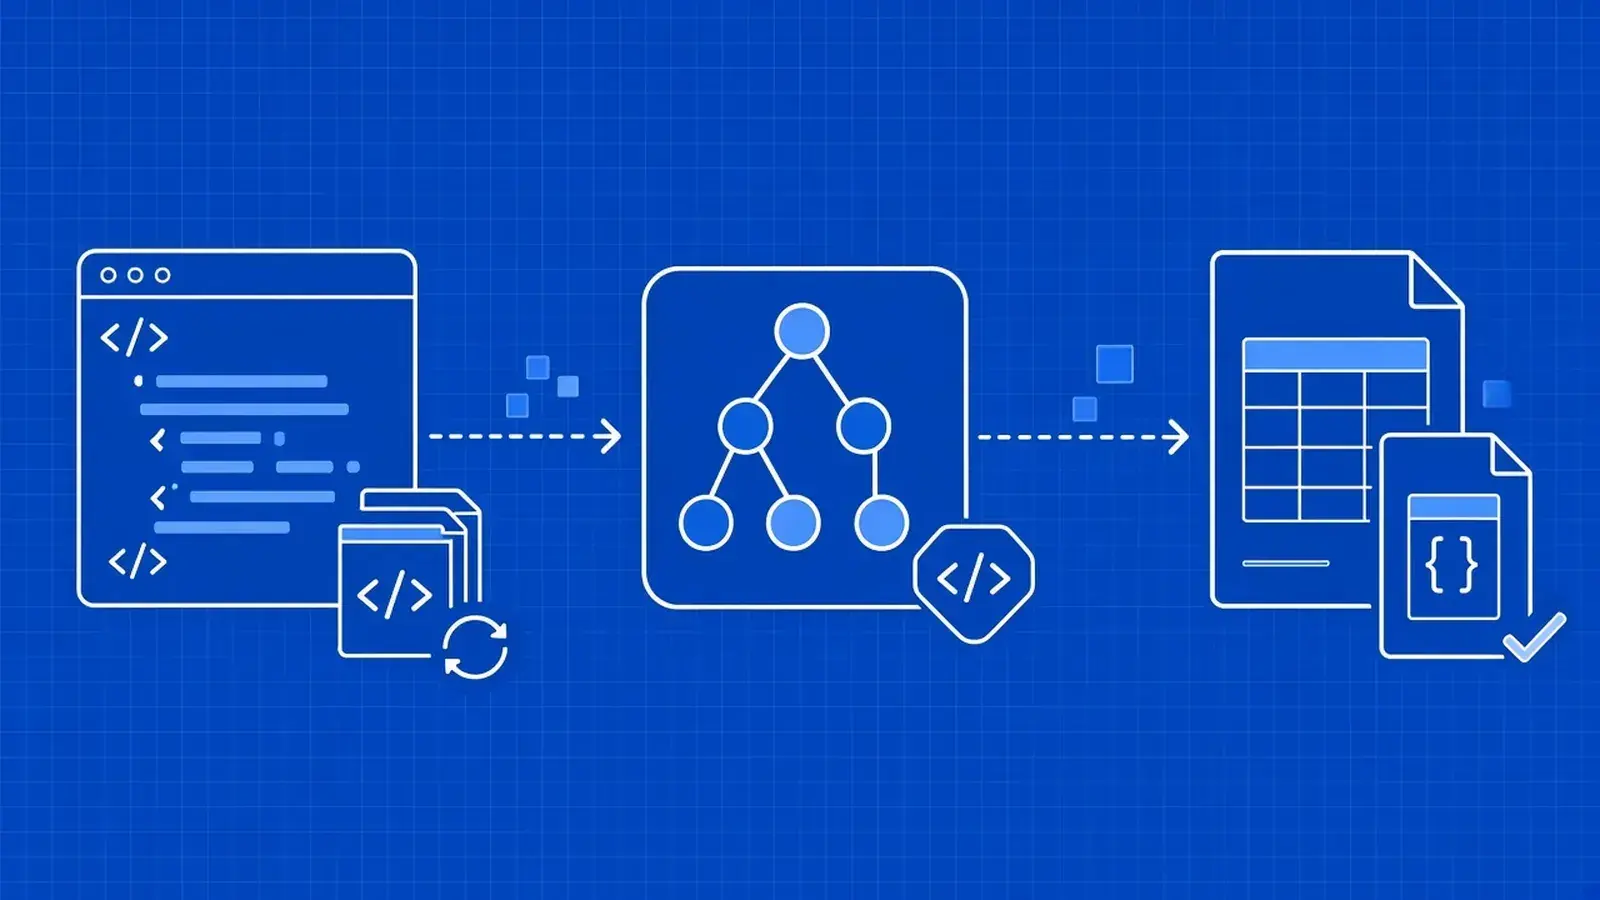
O Cheerio é um analisador rápido de HTML e XML para o Node.js com uma API ao estilo do jQuery. Ele lê a marcação que já tem e permite-lhe selecionar elementos com seletores CSS. Não executa JavaScript, não carrega CSS nem renderiza páginas, por isso utilize-o quando os dados de que necessita já se encontram no HTML bruto da página.

Pense no Cheerio como o oposto de um navegador. Você fornece-lhe uma sequência de código de marcação e ele constrói uma árvore de elementos que pode consultar. Nada é executado: nem layout, nem pedidos de imagens ou folhas de estilo, nem scripts que adicionem conteúdo posteriormente. É por isso que o Cheerio é rápido e leve, e é por isso que, por vezes, não encontra nada em páginas que parecem cheias de dados no Chrome.

Nos bastidores, o projeto Cheerio no GitHub analisa o HTML com o parse5 e pode alternar para o htmlparser2, que é mais tolerante. Por cima, encontra-se a familiar API ao estilo do jQuery: $('selector'), .find(), .text(), e .attr(). Para saber como se compara com outras ferramentas, consulte o nosso resumo das bibliotecas de web scraping para Node.js.

Primeiro, decide com que tipo de página estás a lidar:

Tipo de página

O que utilizar

Porquê

Dados em HTML bruto

fetch + Cheerio

É a opção mais rápida e económica. Não é executado nada

Dados em JSON solicitados pela página

Chamar o JSON diretamente

Sem análise do código de marcação

Conteúdo renderizado ou controlado por JavaScript

HTML renderizado (API do Scraper render_js ou API do navegador), seguido do Cheerio

O Cheerio não consegue executar scripts

Assim que tiver a certeza de que o Cheerio consegue ler a página, extraia os dados nesta ordem:

  • Procure primeiro por dados estruturados, tais como blocos JSON-LD ou um objeto de dados dentro de uma tag de script.
  • Recorra a seletores CSS na marcação visível quando não existirem dados estruturados.
  • Recorra à renderização apenas quando os dados nunca aparecerem no HTML enviado pelo servidor.

Se estiver a ponderar entre um analisador e um navegador completo, a nossa comparação entre o Cheerio e o Puppeteer apresenta as vantagens e desvantagens de cada um.

Como configurar um projeto Cheerio no Node.js?

Instale uma versão LTS atual do Node.js, crie um projeto com `npm init`, adicione «type»: «module» ao ficheiro `package.json` e execute `npm install cheerio`. Importe-o com `import * as cheerio from 'cheerio'`. O `fetch` integrado do Node descarrega páginas, pelo que não precisa do Axios nem de qualquer outro cliente HTTP para começar.

Utilize o Node.js 22 ou posterior; a versão LTS atual é a melhor escolha. Verifique a sua versão e, em seguida, crie o projeto:

node -v
mkdir cheerio-scraper && cd cheerio-scraper
npm init -y
npm pkg set type=module
npm install cheerio

A .mjs extensão indica ao Node para tratar cada ficheiro como um módulo ES. Num projeto CommonJS, const cheerio = require('cheerio') também funciona. O guia de instalação do Cheerio abrange os mesmos passos.

O `fetch` integrado do Node trata dos downloads. Baseia-se no undici, não requer nenhuma importação e suporta AbortSignal.timeout().

Já estás a usar o Axios? Mantém-no. Passa response.data para cheerio.load() em vez de await res.text(), e o resto deste guia aplica-se sem alterações. Veja aqui como definir cabeçalhos no Axios para scraping ou compare o `fetch` nativo e as suas alternativas.

Utilizar o Cheerio com TypeScript

O Cheerio inclui as suas próprias definições de tipos, pelo que não é necessário @types/cheerio pacote para instalar. Importa load e o CheerioAPI tipo, anota os teus tipos de retorno e o compilador verifica o teu analisador tal como qualquer outro código:

// TypeScript: Cheerio ships its own types, so no @types package is needed.
import { load, type CheerioAPI } from 'cheerio';

interface Book {
  title: string;
  price: number;
}

export function parseBooks($: CheerioAPI): Book[] {
  return $('article.product_pod')
    .map((_, el) => ({
      title: $(el).find('h3 a').attr('title') ?? '',
      price: Number($(el).find('.price_color').text().replace(/[^0-9.]/g, '')),
    }))
    .get();
}

const $ = load('<article class="product_pod"><h3><a title="Sample">S</a></h3><p class="price_color">£9.99</p></article>');
console.log(parseBooks($));

Execute-o com npx tsx 09-typed.ts:

[ { title: 'Sample', price: 9.99 } ]

Compilar com tsc em vez disso? Adicione @types/node como dependência de desenvolvimento, porque as definições de tipos do Cheerio fazem referência a elementos integrados do Node, tais como Buffer e node:stream. A lógica de análise é idêntica à versão em JavaScript.

Como funciona o `cheerio.load()`?

cheerio.load() analisa uma cadeia de caracteres HTML e devolve uma função $. Chame $ com um seletor CSS para obter os elementos correspondentes e, em seguida, leia-os com .text() ou .attr(). Utilize .find() para pesquisar dentro de um elemento, .map() com .get() para criar matrizes e .next() ou .parent() para navegar pela árvore do documento.

Comece com uma pequena página estática antes de aceder à rede. Esta abrange todos os métodos utilizados no resto do guia:

// Cheerio basics: load HTML, select elements, read text and attributes.
import * as cheerio from 'cheerio';

const html = `
<ul id="products">
  <li class="product" data-sku="A1"><a href="/p/a1">Desk lamp</a><span class="price">$24.00</span></li>
  <li class="product" data-sku="B2"><a href="/p/b2">Monitor arm</a><span class="price">$61.50</span></li>
  <li class="product sold-out" data-sku="C3"><a href="/p/c3">Cable tray</a><span class="price">$12.99</span></li>
</ul>`;

const $ = cheerio.load(html);

// One element: .text() and .attr()
console.log('First product:', $('li.product a').first().text());
console.log('First link:', $('li.product a').first().attr('href'));

// Many elements: .map() returns a Cheerio object, .get() turns it into an array
const products = $('li.product')
  .map((_, el) => {
    const item = $(el);
    return {
      sku: item.attr('data-sku'),
      name: item.find('a').text().trim(),
      price: Number(item.find('.price').text().replace(/[^0-9.]/g, '')),
      inStock: !item.hasClass('sold-out'),
    };
  })
  .get();
console.log(products);

// Traversal: move from one element to its neighbors
console.log('After A1:', $('li[data-sku="A1"]').next().find('a').text());
console.log('Parent id:', $('.price').first().parent().parent().attr('id'));

O resultado de node 01-basics.mjs:

First product: Desk lamp
First link: /p/a1
[
  { sku: 'A1', name: 'Desk lamp', price: 24, inStock: true },
  { sku: 'B2', name: 'Monitor arm', price: 61.5, inStock: true },
  { sku: 'C3', name: 'Cable tray', price: 12.99, inStock: false }
]
After A1: Monitor arm
Parent id: products

Seleção de elementos

A cadeia de caracteres que passa para $() é um seletor CSS padrão; por isso, nomes de tags, .class, #id, seletores de atributos como [data-sku="A1"]e combinadores como ul > li funcionam todos. O guia da MDN sobre seletores CSS é a melhor referência. O Cheerio adiciona algumas extensões ao estilo do jQuery, tais como :contains() e :first, mas não suporta XPath; eis quando cada linguagem de seletores é mais adequada.

Ler texto e atributos

.text() retorna o texto combinado de todos os elementos correspondentes e dos seus descendentes. .attr('name') retorna um atributo do primeiro elemento correspondente, exatamente como está escrito na marcação. .hasClass() verifica a existência de uma classe, útil para indicadores como «esgotado».

.map() é o passo que confunde a maioria dos novatos. No Cheerio, devolve outro objeto Cheerio em vez de um simples array, pelo que console.log() imprime um wrapper repleto de dados internos. Adicione .get() no final para obter o array de objetos simples que esperava.

Quando o elemento que pretende não tiver um seletor útil próprio, comece por um que tenha e percorra o caminho até lá. .find() procura descendentes, .parent() sobe um nível, .next() avança para o irmão seguinte e .first() mantém apenas a primeira correspondência. As duas últimas linhas do exemplo passam de um produto para o seguinte e de um preço para a respetiva lista.

Como se extrai uma página web real com o Cheerio?

Descarregue a página com o `fetch`, verifique o estado da resposta e passe o texto HTML para `cheerio.load()`. Em seguida, percorra cada cartão repetido com `.map()`, leia todos os campos necessários, converta os preços em números e resolva as ligações relativas com `new URL()` para que o resultado seja dados limpos e tipados, em vez de cadeias de caracteres em bruto.

O «Books to Scrape» apresenta 20 livros por página, cada um dentro de um article.product_pod cartão. Este script obtém a primeira página e transforma cada cartão num registo tipado:

// Fetch one page with Node's built-in fetch and parse it with Cheerio.
import * as cheerio from 'cheerio';

const START_URL = 'https://books.toscrape.com/';
const RATINGS = { One: 1, Two: 2, Three: 3, Four: 4, Five: 5 };

async function getHtml(url) {
  const res = await fetch(url, {
    headers: { 'User-Agent': 'cheerio-tutorial/1.0 (+https://www.webscrapingapi.com)' },
    signal: AbortSignal.timeout(15_000),
  });
  if (!res.ok) throw new Error(`HTTP ${res.status} for ${url}`);
  return res.text();
}

const html = await getHtml(START_URL);
const $ = cheerio.load(html);

const books = $('article.product_pod')
  .map((_, el) => {
    const card = $(el);
    const link = card.find('h3 a');
    const ratingWord = card.find('p.star-rating').attr('class').replace('star-rating', '').trim();
    return {
      title: link.attr('title'),
      price: Number(card.find('.price_color').text().replace(/[^0-9.]/g, '')),
      rating: RATINGS[ratingWord] ?? null,
      inStock: card.find('.availability').text().includes('In stock'),
      url: new URL(link.attr('href'), START_URL).href,
    };
  })
  .get();

console.log(`Found ${books.length} books`);
console.log(books.slice(0, 3));

Aqui estão os três primeiros registos de node 02-books-page.mjs:

Found 20 books
[
  {
    title: 'A Light in the Attic',
    price: 51.77,
    rating: 3,
    inStock: true,
    url: 'https://books.toscrape.com/catalogue/a-light-in-the-attic_1000/index.html'
  },
  {
    title: 'Tipping the Velvet',
    price: 53.74,
    rating: 1,
    inStock: true,
    url: 'https://books.toscrape.com/catalogue/tipping-the-velvet_999/index.html'
  },
  {
    title: 'Soumission',
    price: 50.1,
    rating: 1,
    inStock: true,
    url: 'https://books.toscrape.com/catalogue/soumission_998/index.html'
  }
]

Quatro pequenos truques transformam cadeias de caracteres em bruto em dados utilizáveis:

  • Preço: a página mostra «£51,77». Retire tudo, exceto os dígitos e o ponto decimal, chame Number()e obtém-se 51,77, que pode ser ordenado e somado.
  • Classificação: as estrelas são puramente CSS. O único indicador no HTML é uma classe como star-rating Three, pelo que o script retira star-rating e mapeia a palavra restante para um número.
  • Estoque: «Em estoque» torna-se um valor booleano, o que é mais fácil de filtrar do que texto livre.
  • URL: os href valores são relativos, como catalogue/a-light-in-the-attic_1000/index.html. O construtor de URLs resolve-os em relação ao endereço da página, transformando-os em links que funcionam em qualquer lugar.

Escolha os seletores na opção «Ver Código-fonte», e não no painel «Elementos» do DevTools. O DevTools mostra o DOM após a execução dos scripts, enquanto o Cheerio vê apenas o código-fonte bruto enviado pelo servidor. Um seletor que funcione no DevTools, mas não na opção «Ver Código-fonte», não corresponderá a nada no seu script.

A chamada fetch também define um tempo limite, para que uma resposta em espera não bloqueie a execução, e um User-Agent válido que identifique a sua ferramenta. Sem um, o Node identifica-se simplesmente como «node», como mostra o httpbin:

// See which User-Agent your scraper sends, then set an honest one.
const plain = await fetch('https://httpbin.org/user-agent').then((r) => r.json());
console.log('default:', plain['user-agent']);

const named = await fetch('https://httpbin.org/user-agent', {
  headers: { 'User-Agent': 'cheerio-tutorial/1.0 (+https://www.webscrapingapi.com)' },
}).then((r) => r.json());
console.log('custom:', named['user-agent']);
default: node
custom: cheerio-tutorial/1.0 (+https://www.webscrapingapi.com)

A extrair linhas e colunas em vez de cartões? Siga o nosso tutorial sobre extração de tabelas HTML em JavaScript.

Como é que se extraem várias páginas com o Cheerio?

Extraia a primeira página, leia o href do seu link «seguinte», resolva-o em relação ao URL atual e repita até não restarem mais links seguintes ou até atingir um limite de páginas. Aguarde entre os pedidos, tente novamente apenas em respostas 429 e 5xx com atrasos crescentes e grave os resultados em JSON ou CSV no final.

Este rastreador baseia-se no script anterior. Segue o botão «seguinte» pelo catálogo, repete tentativas em caso de falhas temporárias e guarda os resultados em dois ficheiros:

// Follow "next" links, retry politely, and save results to JSON and CSV.
import * as cheerio from 'cheerio';
import { writeFile } from 'node:fs/promises';
import { setTimeout as sleep } from 'node:timers/promises';

const START_URL = 'https://books.toscrape.com/catalogue/page-1.html';
const MAX_PAGES = Number(process.argv[2] ?? 3);
const DELAY_MS = 1_000;
const RATINGS = { One: 1, Two: 2, Three: 3, Four: 4, Five: 5 };

async function getHtml(url, attempts = 3) {
  for (let attempt = 1; attempt <= attempts; attempt++) {
    let waitMs = DELAY_MS * 2 ** attempt; // 2 s, then 4 s
    try {
      const res = await fetch(url, {
        headers: { 'User-Agent': 'cheerio-tutorial/1.0 (+https://www.webscrapingapi.com)' },
        signal: AbortSignal.timeout(15_000),
      });
      if (res.ok) return res.text();
      // Retry only on rate limits and server errors
      if (res.status !== 429 && res.status < 500) throw new Error(`HTTP ${res.status} for ${url}`);
      // Honor Retry-After when the server sends it in seconds
      const retryAfter = Number(res.headers.get('retry-after'));
      if (retryAfter > 0) waitMs = retryAfter * 1_000;
      console.warn(`HTTP ${res.status} on attempt ${attempt} for ${url}`);
    } catch (err) {
      if (attempt === attempts || err.message.startsWith('HTTP 4')) throw err;
      console.warn(`${err.name} on attempt ${attempt} for ${url}`);
    }
    if (attempt < attempts) await sleep(waitMs);
  }
  throw new Error(`Gave up on ${url}`);
}

function parseBooks($, pageUrl) {
  return $('article.product_pod')
    .map((_, el) => {
      const card = $(el);
      const link = card.find('h3 a');
      const ratingWord = card.find('p.star-rating').attr('class').replace('star-rating', '').trim();
      return {
        title: link.attr('title'),
        price: Number(card.find('.price_color').text().replace(/[^0-9.]/g, '')),
        rating: RATINGS[ratingWord] ?? null,
        inStock: card.find('.availability').text().includes('In stock'),
        url: new URL(link.attr('href'), pageUrl).href,
      };
    })
    .get();
}

function toCsv(rows) {
  const cols = Object.keys(rows[0]);
  const escape = (v) => {
    const s = String(v ?? '');
    return /[",\n]/.test(s) ? `"${s.replace(/"/g, '""')}"` : s;
  };
  return [cols.join(','), ...rows.map((r) => cols.map((c) => escape(r[c])).join(','))].join('\n');
}

const books = [];
let url = START_URL;
for (let page = 1; url && page <= MAX_PAGES; page++) {
  const $ = cheerio.load(await getHtml(url));
  const found = parseBooks($, url);
  books.push(...found);
  console.log(`Page ${page}: ${found.length} books`);

  const next = $('li.next a').attr('href');
  url = next ? new URL(next, url).href : null;
  if (url) await sleep(DELAY_MS);
}

await writeFile('out/books.json', JSON.stringify(books, null, 2));
await writeFile('out/books.csv', toCsv(books));
console.log(`Saved ${books.length} books to out/books.json and out/books.csv`);

Crie a pasta de saída e, em seguida, execute-o com um limite de três páginas:

mkdir out
node 03-crawl-books.mjs 3
Page 1: 20 books
Page 2: 20 books
Page 3: 20 books
Saved 60 books to out/books.json and out/books.csv

As primeiras linhas de out/books.csv:

title,price,rating,inStock,url
A Light in the Attic,51.77,3,true,https://books.toscrape.com/catalogue/a-light-in-the-attic_1000/index.html

Três medidas de segurança mantêm o rastreador «educado» e previsível:

  • Um limite de páginas. O primeiro argumento da linha de comandos define MAX_PAGES. O ciclo também termina quando uma página não tem o link «seguinte».
  • Um atraso fixo. O script espera um segundo entre páginas.
  • Uma política de repetição restrita. Apenas os erros HTTP 429 «Too Many Requests» e os erros de servidor 5xx são repetidos, após 2 segundos e depois 4 segundos, ou após o Retry-After valor que o servidor enviar em segundos. Qualquer outro erro 4xx, como um 404, falha imediatamente, porque repetir a solicitação não alterará a resposta.

O gravador de CSV coloca entre aspas qualquer campo que contenha uma vírgula, uma aspa dupla ou uma quebra de linha, e duplica as aspas no seu interior. Muitos títulos de livros contêm vírgulas, e uma vírgula sem aspas deslocaria todas as colunas seguintes.

Os atrasos e as tentativas de repetição são o mínimo. O nosso manual de melhores práticas de web scraping abrange limites de taxa, agendamento e monitorização.

Como se utilizam as funções fromURL() e extract() do Cheerio?

O fromURL() descarrega uma página e carrega-a numa única chamada com espera. O extract() mapeia, em seguida, um objeto simples de seletores para valores: uma string devolve o texto da primeira correspondência, um array devolve todas as correspondências e um objeto ou função aninhado cria registos estruturados. Juntos, substituem a maioria dos loops .map() escritos manualmente para páginas simples.

Eis a mesma ideia aplicada a «Quotes to Scrape», sem qualquer chamada fetch nem loop manual:

// Cheerio's fromURL() and extract(): fetch and map fields in one step.
import { fromURL } from 'cheerio';

const PAGE_URL = 'https://quotes.toscrape.com/';
const $ = await fromURL(PAGE_URL);

const data = $.extract({
  pageTitle: 'title',
  quotes: [
    {
      selector: 'div.quote',
      value: {
        text: 'span.text',
        author: 'small.author',
        authorUrl: {
          selector: 'a[href^="/author/"]',
          value: (el) => new URL($(el).attr('href'), PAGE_URL).href, // resolve relative links
        },
        tags: { selector: '.tags', value: (el) => $(el).find('a.tag').map((_, a) => $(a).text()).get() },
      },
    },
  ],
});

console.log(data.pageTitle.trim());
console.log(`Quotes on page: ${data.quotes.length}`);
console.log(data.quotes[0]);
Quotes to Scrape
Quotes on page: 10
{
  text: '“The world as we have created it is a process of our thinking. It cannot be changed without changing our thinking.”',
  author: 'Albert Einstein',
  authorUrl: 'https://quotes.toscrape.com/author/Albert-Einstein',
  tags: [ 'change', 'deep-thoughts', 'thinking', 'world' ]
}

Cada chave descreve um campo de saída. pageTitle: 'title' lê o texto do primeiro <title> elemento. Ao envolver um descritor num array, tal como quotes faz, devolve um resultado por correspondência, e a value propriedade pode ser um seletor, um objeto aninhado ou uma função que recebe o elemento. A referência do `extract()` lista todas as opções.

Resolva os links por si próprio. Dependendo da sua versão do Cheerio, href os valores lidos através de extract() ou .prop('href') ainda podem ser devolvidos como relativos após fromURL(), pelo que o fragmento de código passa cada um deles por new URL(). Essa pequena precaução garante que o resultado final esteja correto em qualquer dos casos.

A documentação do Cheerio sobre como o Cheerio carrega documentos acrescenta mais dois detalhes. fromURL() rejeita respostas que não sejam 2xx com um erro, em vez de te apresentar uma página de erro para analisar. E se passares requestOptions para definir cabeçalhos, tens de definir method você mesmo, porque não são preenchidos automaticamente.

Utilize fetch o «plus» load() em vez disso quando precisar de novas tentativas personalizadas, atrasos ou uma camada de proxy, como no rastreador acima.

Como se obtêm dados de JSON-LD e de tags de script?

Antes de escrever seletores, procure no HTML por blocos de script do tipo «type="application/ld+json"» e scripts embutidos que contenham dados. Selecione-os com o Cheerio, leia o seu texto e utilize o JSON.parse dentro de um try/catch. Os dados estruturados costumam resistir melhor às reformulações do que a marcação visível e, muitas vezes, incluem preços, SKUs e disponibilidade bem organizados.

Muitas páginas de lojas e artigos incorporam dados do schema.org para os motores de busca e, quando estão presentes, são frequentemente a fonte mais clara da página:

// Read structured data (JSON-LD) before writing selectors for visible text.
import { load } from 'cheerio';

const html = `<html><head>
<script type="application/ld+json">
{"@context":"https://schema.org","@type":"Product","name":"Desk lamp","sku":"A1",
 "offers":{"@type":"Offer","price":"24.00","priceCurrency":"USD","availability":"https://schema.org/InStock"}}
</script></head><body><h1>Desk lamp</h1></body></html>`;

const $ = load(html);
const items = $('script[type="application/ld+json"]')
  .map((_, el) => {
    try {
      return JSON.parse($(el).text());
    } catch {
      return null; // skip malformed blocks instead of crashing
    }
  })
  .get()
  .filter(Boolean);

const product = items.find((item) => item['@type'] === 'Product');
console.log({ name: product.name, price: Number(product.offers.price), currency: product.offers.priceCurrency });
{ name: 'Desk lamp', price: 24, currency: 'USD' }

O try/catch impede que um único bloco malformado interrompa a execução. Filtre pelo @type que precisar, como «Produto» ou «Artigo», porque uma página contém frequentemente vários blocos.

Alguns sites enviam todo o seu conjunto de dados num script incorporado e constroem a marcação visível com JavaScript. Esse caso parece não funcionar à primeira vista, pelo que tem a sua própria secção.

Porque é que o Cheerio não devolve nada em páginas renderizadas por JavaScript?

O Cheerio apenas vê o HTML que o servidor envia. Se uma página construir o seu conteúdo com JavaScript no navegador, os teus seletores não irão corresponder a nada, porque os elementos ainda não existem. Verifica primeiro o HTML bruto. Depois, procura os dados em scripts ou num endpoint JSON, ou obtém o HTML renderizado e analisa-o com o Cheerio.

O «Quotes to Scrape» tem uma versão em JavaScript em /js/ que parece idêntica num navegador. Este script mostra o que o Cheerio recebe efetivamente e onde os dados estão escondidos:

// Spot a JavaScript-rendered page, then look for the data inside a <script> tag.
import { fromURL } from 'cheerio';

const $ = await fromURL('https://quotes.toscrape.com/js/');

// 1. The selector that works on the static version finds nothing here
console.log('div.quote elements in raw HTML:', $('div.quote').length);

// 2. The quotes still ship in the HTML, inside an inline script
const script = $('script')
  .map((_, el) => $(el).text())
  .get()
  .find((code) => code.includes('var data ='));

// Capture the array literal between "var data =" and the first "];"
const json = script.match(/var data = (\[[\s\S]*?\]);/)[1];
const quotes = JSON.parse(json);

console.log(`Quotes found in <script>: ${quotes.length}`);
console.log({ author: quotes[0].author.name, tags: quotes[0].tags });
div.quote elements in raw HTML: 0
Quotes found in <script>: 10
{
  author: 'Albert Einstein',
  tags: [ 'change', 'deep-thoughts', 'thinking', 'world' ]
}

O seletor que encontrou 10 citações na página estática encontra 0 aqui, porque os div.quote elementos são criados no navegador. As citações ainda estão no HTML, dentro de uma var data = [...] atribuição, pelo que uma expressão regular e JSON.parse() recuperam todas as 10. É isto que significa, na prática, a diferença entre renderização do lado do servidor e do lado do cliente.

Quando os dados não estiverem num script, experimenta estas opções por ordem:

  1. Encontre o pedido JSON. No DevTools, abra o separador «Rede», filtre por «Fetch/XHR» e atualize a página. Muitas páginas carregam o seu conteúdo a partir de um ponto final JSON. Se for público e tiver permissão para o utilizar, chame-o diretamente e ignore a análise do HTML.
  2. Renderize primeiro, depois analise. Renderizar significa executar a página num motor real, normalmente um navegador headless, antes de a analisar. O seu código Cheerio não muda; apenas a fonte do HTML é que muda.

Podes executar um navegador tu mesmo ou deixar que uma API o faça por ti. A API do Scraper pode renderizar a página e devolver o HTML final, que passas diretamente para `cheerio.load()`. Adiciona render_js=1 à solicitação, e a resposta será o HTML após a execução dos scripts. A renderização de JavaScript e a segmentação geográfica não têm custo adicional, e as solicitações com falha não são cobradas.

// When a page needs a browser, fetch rendered HTML from Scraper API and keep parsing with Cheerio.
import { load } from 'cheerio';

const apiKey = process.env.WSA_API_KEY;
if (!apiKey) {
  console.error('Set WSA_API_KEY to run this example.');
  process.exit(1);
}

const params = new URLSearchParams({
  api_key: apiKey,
  url: 'https://quotes.toscrape.com/js/',
  render_js: '1',
});

const res = await fetch(`https://api.webscrapingapi.com/v2?${params}`, {
  signal: AbortSignal.timeout(120_000),
});
if (!res.ok) throw new Error(`Scraper API returned HTTP ${res.status}`);

const $ = load(await res.text());
console.log('div.quote elements after rendering:', $('div.quote').length);
console.log('First author:', $('div.quote small.author').first().text());

Execute-a com a sua chave numa variável de ambiente, para que esta nunca apareça no seu código:

WSA_API_KEY=your_key node 08-render-handoff.mjs

Quando os dados só aparecem após cliques, deslocamentos ou um período de espera, a API do Navegador executa esses passos por si. Descreve as esperas e ações, tais como clicar, deslocar, digitar e enviar, numa solicitação REST; o navegador é executado do nosso lado e o HTML que ele devolve é inserido cheerio.load() como qualquer outra página.

Porque é que o cheerio.load não está a funcionar? Erros comuns e soluções

A maioria dos problemas com o cheerio.load tem algumas causas: uma importação por predefinição que o Cheerio 1.x já não fornece, seletores escritos com base no DOM renderizado do navegador, fragmentos envoltos em tags html e body, XML analisado como HTML e links relativos ou espaços em branco desorganizados. Cada correção abaixo é uma alteração de uma linha que pode testar em segundos.

Este script mostra cinco das sete soluções abaixo, antes e depois:

// Fixes for the errors people hit most often with cheerio.load().
import * as cheerio from 'cheerio';
import { load } from 'cheerio';

// Fix 1: there is no default export in Cheerio 1.x.
// `import cheerio from 'cheerio'` fails; use a namespace or named import.
console.log('namespace load is a function:', typeof cheerio.load === 'function');
console.log('named load is a function:', typeof load === 'function');

// Fix 2: load() wraps fragments in <html><head><body> by default.
const fragment = '<li>Apples</li><li>Pears</li>';
console.log('document mode:', load(fragment).html());
console.log('fragment mode:', load(fragment, null, false).html());

// Fix 3: parse XML (RSS, sitemaps) with the xml option so tags like <link> keep their text.
const rss = `<rss><channel><item><title>Post</title><link>https://example.com/post</link></item></channel></rss>`;
console.log('HTML mode <link>:', JSON.stringify(load(rss)('item link').text()));
console.log('XML mode <link>:', JSON.stringify(load(rss, { xml: true })('item link').text()));

// Fix 4: .text() keeps whitespace and joins nested text. Normalize it yourself.
const $ = load('<p class="desc">\n  Fast,\n  <b>small</b>   and   tested.\n</p>');
console.log('raw text:', JSON.stringify($('.desc').text()));
console.log('clean text:', JSON.stringify($('.desc').text().replace(/\s+/g, ' ').trim()));

// Fix 5: .attr('href') returns the value as written. Resolve it against the page URL.
const page = 'https://books.toscrape.com/catalogue/page-2.html';
console.log('absolute URL:', new URL('../index.html', page).href);
namespace load is a function: true
named load is a function: true
document mode: <html><head></head><body><li>Apples</li><li>Pears</li></body></html>
fragment mode: <li>Apples</li><li>Pears</li>
HTML mode <link>: ""
XML mode <link>: "https://example.com/post"
raw text: "\n  Fast,\n  small   and   tested.\n"
clean text: "Fast, small and tested."
absolute URL: https://books.toscrape.com/index.html

«cheerio.load não é uma função» ou «cheerio.default não está definido»

Sintoma: o seu script falha na primeira chamada ao Cheerio, ou cheerio.default retorna como indefinido. Em módulos ES nativos, import cheerio from 'cheerio' falha ainda mais cedo com «não fornece uma exportação chamada 'default'».

Causa: o Cheerio 1.x não tem uma exportação predefinida. Tutoriais mais antigos e código anterior à versão 1.0 utilizavam uma.

Solução: utilize uma importação de namespace, import * as cheerio from 'cheerio'ou uma importação nomeada, import { load } from 'cheerio'. No CommonJS, const cheerio = require('cheerio') funciona.

Os teus seletores não devolvem nada

Sintoma: $('...').length é 0, e .text() retorna uma cadeia de caracteres vazia.

Causa: uma de três possibilidades. Copiou o seletor do DevTools, que mostra o DOM após a execução dos scripts; o conteúdo é renderizado por JavaScript, conforme abordado na secção sobre páginas renderizadas por JavaScript; ou o servidor devolveu uma página de bloqueio, uma página de login ou um erro.

Solução: registe res.status e os primeiros 200 caracteres do HTML com console.log(res.status, html.slice(0, 200)). Em seguida, compare o seu seletor com o «Ver Código-fonte», e não com o painel «Elementos».

Tags HTML, head e body adicionais na saída

Sintoma: carregas um snippet como <li>Apples</li>, e .html() este é devolvido envolto em <html><head></head><body>.

Causa: por predefinição, o load() trata a entrada como um documento completo e adiciona as tags de envoltório em falta, tal como um navegador faria.

Solução: carregue fragmentos no modo de fragmento com load(html, null, false). O terceiro argumento desativa o modo de documento.

Os feeds XML e RSS perdem dados

Sintoma: ao analisar um feed RSS ou um mapa do site, campos como <link> aparecem vazios.

Causa: no modo HTML, <link> é um elemento vazio e não pode conter texto, pelo que o URL no seu interior é omitido. Na saída acima, o modo HTML devolveu "" e o modo XML devolveu a URL.

Solução: utilize load(xml, { xml: true }). O modo XML também mantém as maiúsculas e minúsculas dos nomes das tags e não adiciona tags de invólucro html ou body.

O texto é apresentado com espaços em branco adicionais

Sintoma: .text() retorna cadeias de caracteres repletas de quebras de linha e sequências de espaços.

Causa: .text() mantém os espaços em branco da fonte, incluindo a indentação, e une elementos aninhados, tais como <b> sem separadores.

Solução: normalize-o com .text().replace(/\s+/g, ' ').trim(). Para uma página inteira, selecione primeiro o elemento de conteúdo principal para excluir a navegação e o texto do rodapé.

Erros 403 ou 429

Sintoma: o pedido falha com o código HTTP 403 Forbidden ou 429 Too Many Requests, e o seu analisador nunca é executado.

Causa: estes erros provêm do servidor, não do Cheerio. O Cheerio só vê o HTML depois de a solicitação ser bem-sucedida.

Solução: defina um User-Agent válido, diminua a velocidade, respeite Retry-Aftere respeite o ficheiro robots.txt e os termos do site. Se um site continuar a bloquear pedidos simples em páginas que está autorizado a recolher, encaminhe a recolha através da API do Scraper e mantenha o seu analisador.

Sintoma: .attr('href') devolve percursos como ../index.html ou /author/Albert-Einstein que não funcionam fora da página.

Causa: .attr() retorna o valor exatamente como está escrito na marcação.

Solução: resolver todas as ligações com new URL(href, pageUrl).href, utilizando o endereço da página que obteve como base.

Como evitar que um scraper do Cheerio deixe de funcionar?

Mantém a análise separada da recuperação de dados, guarda uma página real como um fixture e testa o analisador offline com o `node:test`. Dá preferência a ganchos estáveis, como IDs, atributos de dados e `itemprop`, em vez de classes de estilo, e lança um erro quando uma página não apresentar nenhum registo, para que uma reformulação falhe de forma evidente, em vez de guardar ficheiros vazios.

Os scrapers raramente avariam com um erro. Normalmente, o layout muda, todos os seletores deixam silenciosamente de corresponder a nada e deparas-te com uma semana de ficheiros vazios. Torna o analisador numa função pura que possas testar e faz com que ele avise quando não encontrar nada.

Guarde uma cópia de uma página real como um fixture:

mkdir fixtures
curl -s https://books.toscrape.com/catalogue/page-1.html -o fixtures/books-page-1.html

Mova a análise para o seu próprio módulo. Este recebe HTML e um URL e não se importa com a origem do HTML:

// parse-books.mjs: keep parsing separate from fetching so it can be tested offline.
import { load } from 'cheerio';

const RATINGS = { One: 1, Two: 2, Three: 3, Four: 4, Five: 5 };

export function parseBooks(html, pageUrl) {
  const $ = load(html);
  const books = $('article.product_pod')
    .map((_, el) => {
      const card = $(el);
      const link = card.find('h3 a');
      const ratingWord = card.find('p.star-rating').attr('class').replace('star-rating', '').trim();
      return {
        title: link.attr('title'),
        price: Number(card.find('.price_color').text().replace(/[^0-9.]/g, '')),
        rating: RATINGS[ratingWord] ?? null,
        inStock: card.find('.availability').text().includes('In stock'),
        url: new URL(link.attr('href'), pageUrl).href,
      };
    })
    .get();

  // Fail loudly when the layout changes instead of saving an empty file
  if (books.length === 0) throw new Error(`No books found on ${pageUrl}; check the selectors`);
  return books;
}

Depois, teste-o com o executor de testes integrado do Node, sem dependências adicionais:

// Run with: node --test
import { test } from 'node:test';
import assert from 'node:assert/strict';
import { readFile } from 'node:fs/promises';
import { parseBooks } from './parse-books.mjs';

const PAGE_URL = 'https://books.toscrape.com/catalogue/page-1.html';

test('parses every book card on a saved page', async () => {
  const html = await readFile(new URL('./fixtures/books-page-1.html', import.meta.url), 'utf8');
  const books = parseBooks(html, PAGE_URL);

  assert.equal(books.length, 20);
  for (const book of books) {
    assert.ok(book.title.length > 0);
    assert.ok(book.price > 0);
    assert.ok(book.rating >= 1 && book.rating <= 5);
    assert.match(book.url, /^https:\/\/books\.toscrape\.com\/catalogue\//);
  }
});

test('throws when the layout changes', () => {
  assert.throws(() => parseBooks('<html><body><p>Redesigned</p></body></html>', PAGE_URL), /No books found/);
});

Execute node --test, e o resumo termina com:

# tests 2
# pass 2
# fail 0

O primeiro teste verifica se o analisador lê todas as 20 fichas com valores válidos; o segundo, se uma página redesenhada lança uma exceção em vez de devolver um array vazio. Como o fixture fica armazenado no disco, os testes são executados offline. Quando o site for alterado, guarde um novo fixture e atualize os seletores até que os testes sejam aprovados.

Alguns hábitos fazem com que os seletores durem mais tempo:

  • Dê preferência a ids, data-* atributos e itemprop atributos. Estes têm significado e alteram-se com menos frequência do que as classes de estilo.
  • Evite classes utilitárias e nomes de classes gerados automaticamente, que podem mudar a cada implementação.
  • Baseie-se na estrutura em vez de na posição. «O preço dentro de cada ficha de produto» sobrevive a um novo banner; «a terceira div» não.

Se a manutenção da camada de recolha de dados custar mais do que a análise, compare as APIs de web scraping por tarefa e custo.

Perguntas frequentes

O Cheerio é mais rápido do que o Puppeteer?

Normalmente, para páginas estáticas. O Cheerio apenas analisa texto, enquanto o Puppeteer inicia um navegador completo, carrega recursos e executa scripts, pelo que o Cheerio faz muito menos trabalho por página. Avalie com base no seu próprio objetivo, em vez de confiar em benchmarks genéricos. Se os dados precisarem de JavaScript para serem apresentados, o Cheerio, por si só, não consegue aceder a eles a qualquer velocidade.

O Cheerio consegue executar JavaScript ou extrair páginas dinâmicas?

Não. O Cheerio analisa a cadeia de caracteres HTML que lhe fornece e nunca executa scripts. Para páginas dinâmicas, procure primeiro os dados em scripts embutidos ou nos pedidos JSON da página. Se nenhuma destas opções funcionar, obtenha o HTML renderizado a partir de um navegador sem interface gráfica ou de uma API de renderização e passe-o para `cheerio.load()`.

Preciso do Axios para utilizar o Cheerio?

Não. As versões atuais do Node.js incluem um `fetch` global, pelo que pode chamar `await fetch(url)` e passar `await res.text()` para `cheerio.load()`. O método `fromURL()` do Cheerio também pode fazer a recuperação por si. Se o seu projeto já utiliza o Axios, isso também funciona: passe `response.data` para `cheerio.load()` da mesma forma.

O Cheerio suporta XPath?

Não. O Cheerio seleciona elementos com seletores CSS, além de algumas extensões ao estilo do jQuery, como :contains() e :first, e não possui um motor de XPath. A maioria das expressões XPath traduz-se num seletor CSS, juntamente com métodos de percurso como .parent(), .next() ou .filter(). Se depender do XPath, utilize um analisador que o suporte.

O Cheerio funciona com TypeScript?

Sim. O Cheerio inclui as suas próprias definições de tipos, pelo que não é necessário instalar um pacote @types separado para o mesmo. Importe o `load` e o tipo `CheerioAPI`, anote o tipo de retorno do seu analisador e, em seguida, execute o ficheiro com o `tsx`, ou adicione o `@types/node` e compile com o `tsc`. A lógica de análise permanece idêntica à versão em JavaScript.

Porque é que o `cheerio.load` devolve um resultado vazio?

Normalmente, os elementos não se encontram no HTML bruto. Pode ter copiado seletores a partir do DevTools, que mostra a página após a execução dos scripts, ou o servidor pode ter devolvido uma página em branco ou um erro. Registe o código de estado e as primeiras linhas do HTML e, em seguida, verifique o seu seletor comparando-o com a opção «Ver Código-fonte».

Como obtenho texto simples a partir de HTML com o Cheerio?

Chame .text() na seleção e, em seguida, normalize os espaços em branco com .replace(/\s+/g, ' ').trim(). O método .text() une o texto de todos os elementos aninhados, mantendo as quebras de linha e a indentação da fonte. Para uma página inteira, selecione primeiro o elemento de conteúdo principal para excluir o texto de navegação e do rodapé do seu resultado.

O Cheerio consegue analisar XML e feeds RSS?

Sim. Passe { xml: true } como opções: cheerio.load(xml, { xml: true }). No modo HTML predefinido, tags como «link» são tratadas como elementos HTML vazios e perdem o seu texto, o que impede a análise de RSS. O modo XML também mantém as maiúsculas e minúsculas dos nomes das tags e ignora os wrappers «html», «head» e «body».

Como evito ser bloqueado ao fazer scraping com o Cheerio?

O bloqueio ocorre ao nível do pedido, não no Cheerio. Envie um User-Agent válido, adicione um intervalo entre pedidos, tente novamente em caso de respostas 429 e 5xx com um período de espera, respeite o Retry-After e siga o robots.txt e os termos do site. Se as páginas que está autorizado a recolher continuarem a devolver erros 403, altere a camada de recolha e mantenha o seu analisador.

O Cheerio é apenas um analisador, pelo que a legalidade depende do que recolhe e de como o faz. Os dados públicos recolhidos de forma educada e dentro dos termos do site apresentam, geralmente, um risco menor. Os dados pessoais, os conteúdos protegidos por login e o material protegido por direitos de autor implicam obrigações adicionais. As regras variam consoante o país, pelo que deve procurar aconselhamento jurídico para projetos comerciais. Isto não constitui aconselhamento jurídico.

Quando deve delegar a recolha a uma API?

Utilize o Cheerio para aquilo que ele faz melhor, que é transformar HTML em dados limpos. Quando as páginas necessitarem de JavaScript ou continuarem a devolver erros 403, deixe que outra ferramenta as recupere. Os planos da API Scraper começam com um período de teste gratuito de 5 000 pedidos. A renderização em JavaScript e a segmentação geográfica não implicam créditos adicionais, e os pedidos falhados não são faturados. Para fluxos que necessitem de cliques, deslocamento ou tempos de espera, solicite um orçamento da API Browser adaptado à sua carga de trabalho. O seu analisador permanece o mesmo em qualquer dos casos.

Sobre o autor

Raluca Penciuc, Desenvolvedor Full-Stack @ WebScrapingAPI

Raluca Penciuc

Desenvolvedor Full-Stack

Raluca Penciuc é programadora Full Stack na WebScrapingAPI, onde desenvolve scrapers, aperfeiçoa estratégias de evasão e procura formas fiáveis de reduzir a deteção nos sites-alvo.

Web Scraping com AWS Lambda: Guia para Python e Java 2026
Guias

Web Scraping com AWS Lambda: Guia para Python e Java 2026

TL;DR: Resumo: A extração de dados da Web com o AWS Lambda funciona melhor quando cada invocação é curta, delimitada e pode ser repetida de forma independente. Comece com HTTP direto, AWS SAM e S3 e, só depois, adicione SQS, contentores, renderização no navegador, proxies ou uma camada de recuperação gerida, apenas quando a carga de trabalho demonstrar que precisa deles.

Suciu Dan32 min read
Ler artigo
Como utilizar o GoSpider: rastrear, limpar URLs e extrair dados
Guias

Como utilizar o GoSpider: rastrear, limpar URLs e extrair dados

TL;DR: Resumo: O GoSpider é um rastreador de linha de comandos destinado a descobrir URLs, não um extrator completo de dados estruturados. Este guia sobre como utilizar o GoSpider mostra como realizar um rastreio limitado, gerir resultados de forma organizada, fazer a transferência de dados do Colly para CSV e seguir um percurso de diagnóstico para respostas 403 ou páginas que exijam renderização em JavaScript.

Suciu Dan23 min read
Ler artigo
Como fazer o Scrape Redfin: Guia Python para Dados de Propriedade
Guias

Como fazer o Scrape Redfin: Guia Python para Dados de Propriedade

TL;DR: A Redfin expõe pontos de extremidade de API ocultos que retornam JSON estruturado para listagens de propriedades, tornando possível ignorar totalmente a análise HTML frágil. Este guia orienta-o na construção de um scraper Python que extrai dados de aluguer e venda, pesquisa por localização, monitoriza novas listagens através de sitemaps XML e exporta resultados limpos para CSV ou JSON.

Suciu Dan14 min read
Ler artigo

Comece a construir

Pronto para expandir a sua recolha de dados?

Junte-se a mais de 2.000 empresas que utilizam a WebScrapingAPI para extrair dados da Web à escala empresarial, sem quaisquer custos de infraestrutura.
