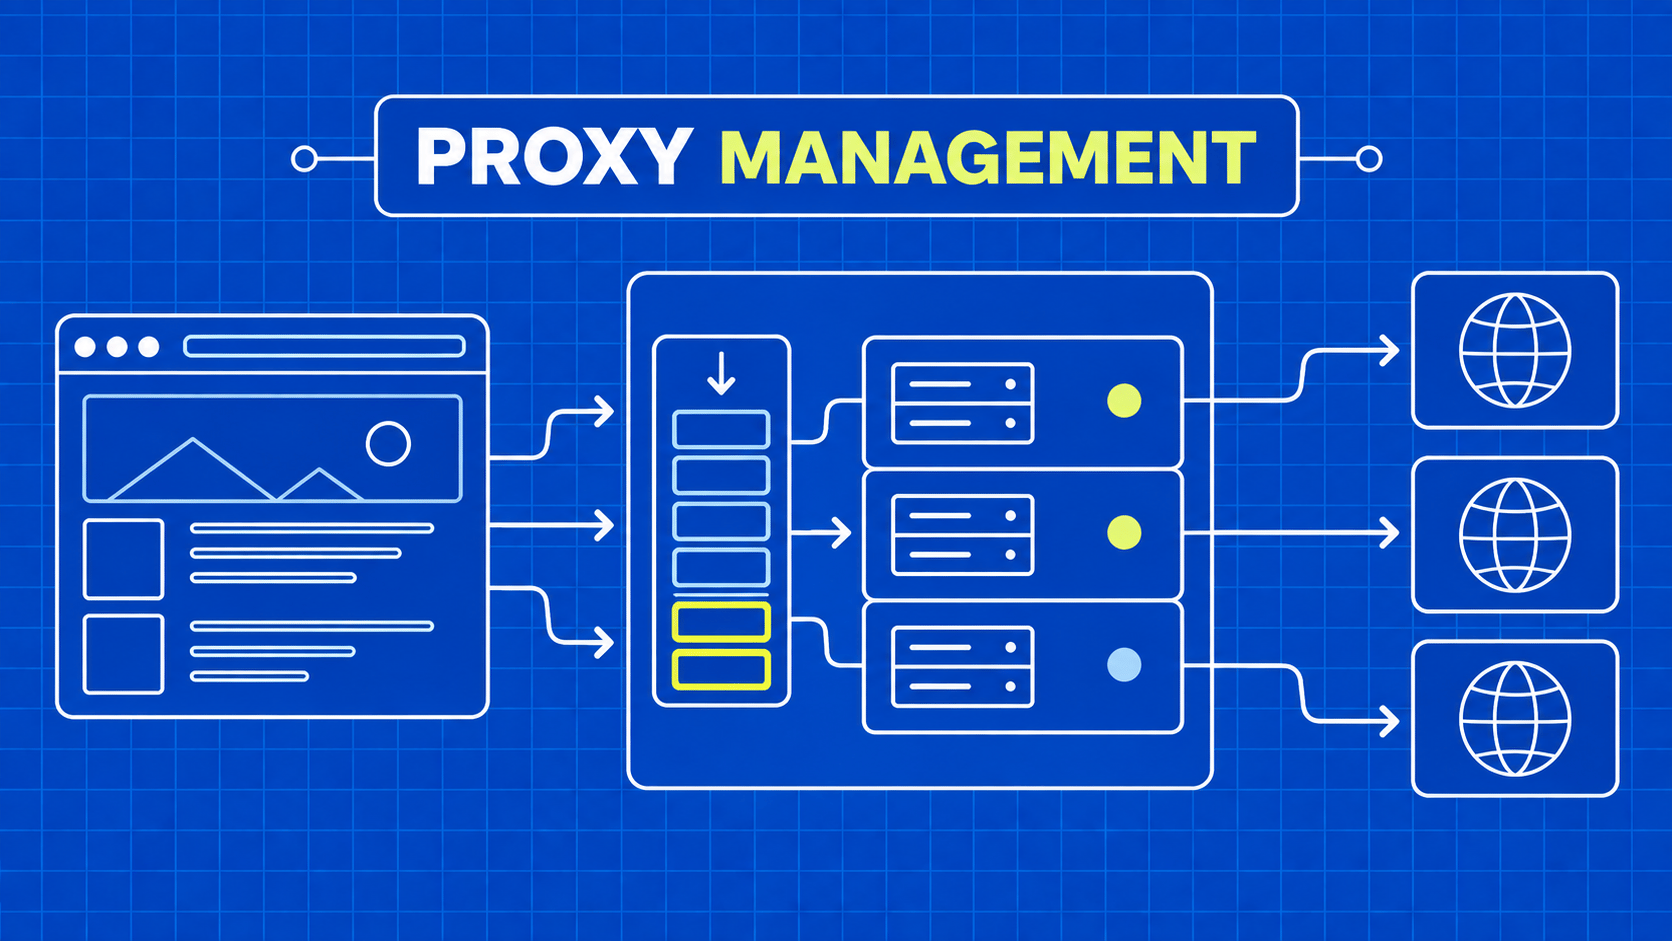
TL;DR: A gestão de proxies para web scraping é a camada de políticas que atribui tarefas autorizadas a rotas de rede adequadas e acompanha o que acontece a seguir. Mantenha separados o estado da sessão, a integridade da rota e os limites de pedidos de origem. Alterne ou retire uma rota por uma razão operacional documentada, e não como resposta automática a todas as páginas com falha.
Um trabalhador recebe uma página de produto vazia e marca o seu proxy como inativo. Outro trabalhador opta imediatamente por uma nova rota e repete a solicitação. Após várias tentativas, o conjunto de proxies parece estar com problemas, mas a falha real é um analisador que espera um elemento que a fonte removeu.
Isso é um problema de gestão antes de ser um problema de rede. O sistema tomou uma decisão de encaminhamento utilizando evidências da camada errada. Adicionar mais endereços tornaria o erro maior, não mais correto.
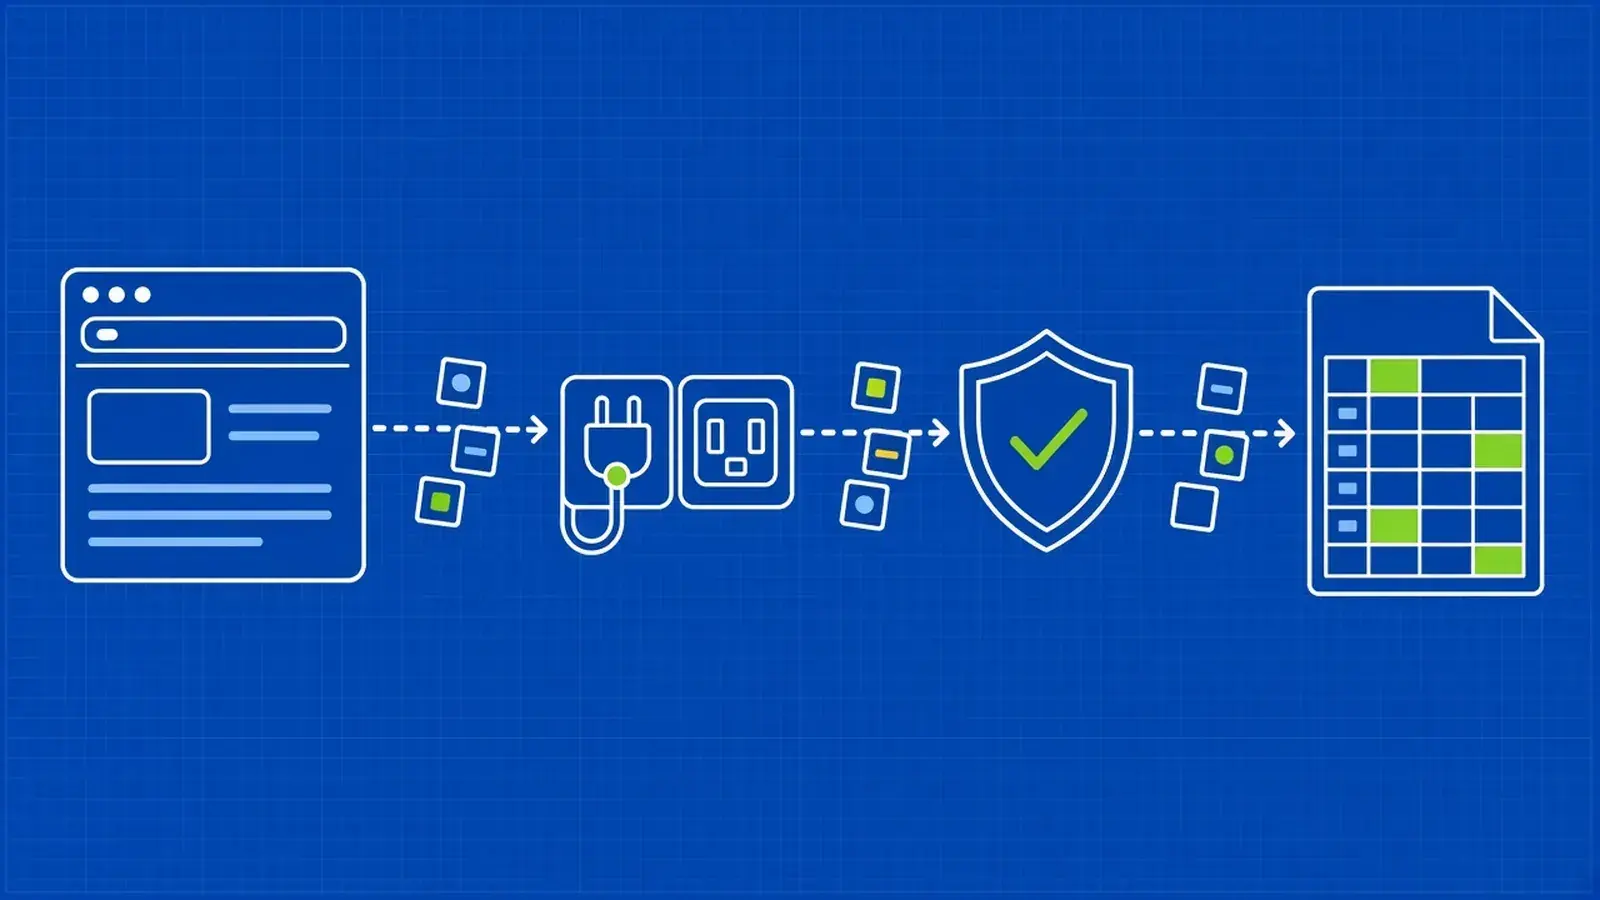
Um gestor de proxies útil faz mais do que apenas escolher o próximo ponto final. Sabe que tarefas exigem continuidade, quais as rotas que cumprem os requisitos de localização aprovados, quanto tráfego a fonte pode receber e quando um operador deve analisar uma falha. O seu sucesso é medido por observações válidas fornecidas no âmbito da política de recolha, e não pela frequência com que altera endereços.
Este guia descreve esse design para programadores que operam coletores autorizados. Os exemplos são recomendações de arquitetura originais, não um ponto de referência de um fornecedor. Pode aplicar os mesmos limites a um pequeno trabalhador baseado em configuração ou a um serviço de recolha partilhado de maior dimensão.