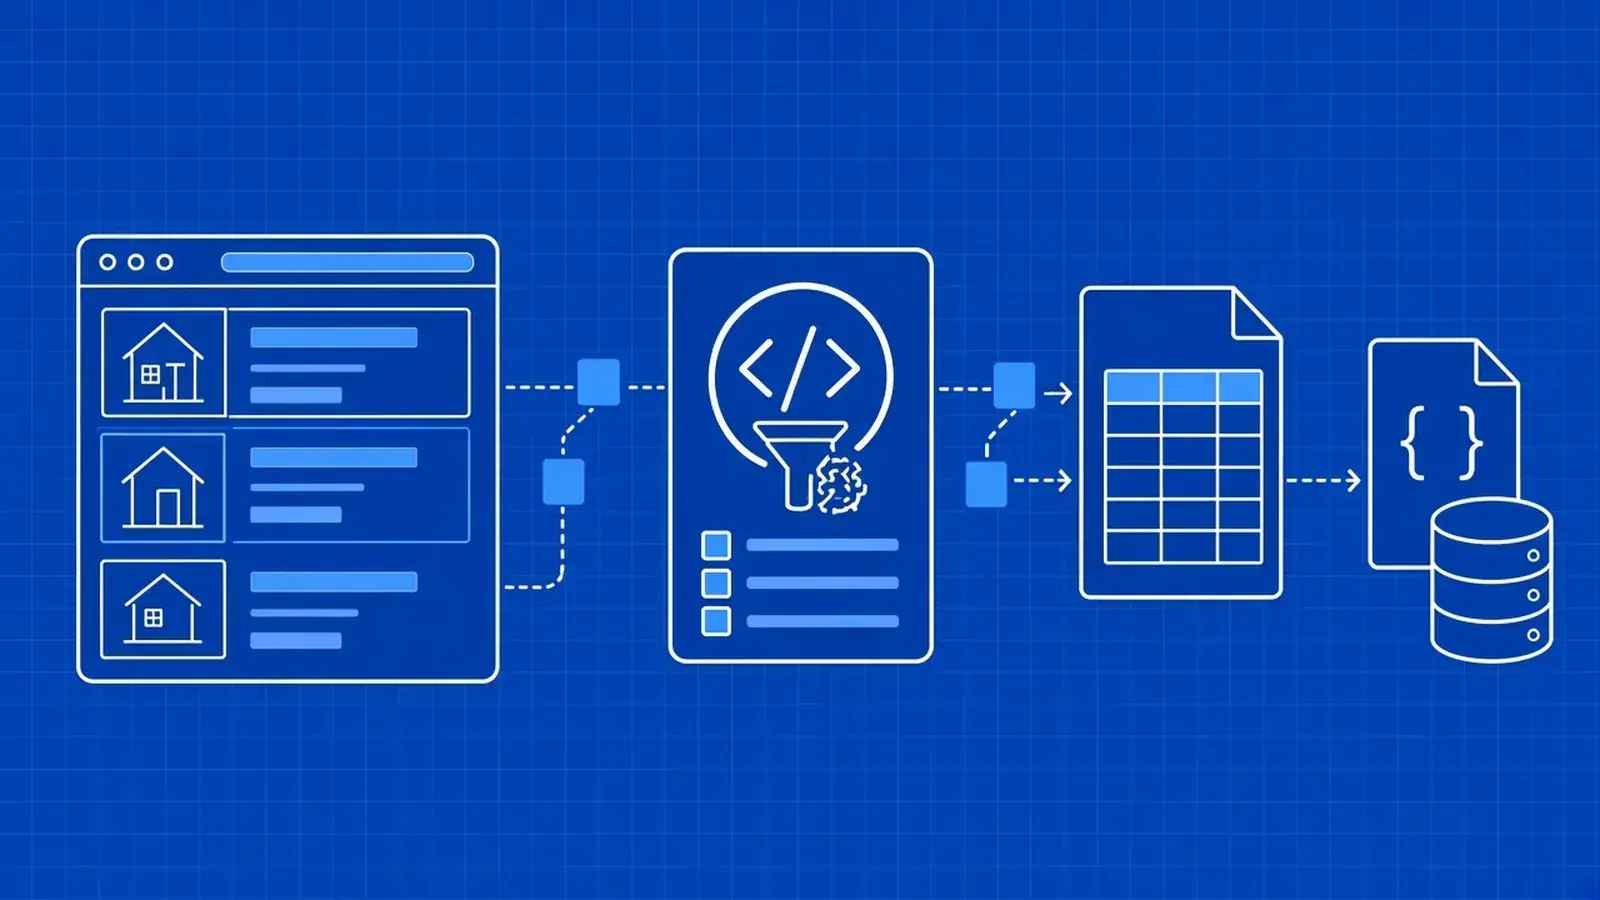
Resumo: o web scraping imobiliário coleta anúncios, preços e detalhes de imóveis em sites e os transforma em dados estruturados. Antes de fazer scraping, verifique se existem dados abertos, um feed de MLS ou uma API de dados, porque Zillow, Realtor.com e Redfin proíbem a coleta automatizada em seus termos de uso. Este guia aborda o modelo de dados, as fontes, os limites legais, o código Python e as verificações de qualidade.
Cedo ou tarde, alguém pede para você "conseguir dados de imóveis" de um mercado: preços pedidos para comparativos, o estoque de anúncios para um relatório ou um feed de novos anúncios. Dados imobiliários estão por toda a web, então o scraping parece a resposta óbvia. Mas dois erros derrubam a maioria desses projetos. O primeiro é fazer scraping de um portal cujos termos proíbem isso. O segundo é tratar o preço pedido como preço de venda e construir a análise sobre o número errado.
Comece pela decisão: quais dados existem, qual fonte serve para cada tarefa e o que os grandes portais permitem. Depois, construa um scraper em Python com requests, BeautifulSoup e pandas em uma página de exemplo que você controla e obtenha preços reais de imóveis a partir de um arquivo gratuito de dados abertos.