
Saltar para o conteúdo
Comece grátis
Voltar ao blogue

Extracção de dados de sites: um fluxo de trabalho prático com o DOM

Raluca PenciucÚltima atualização em 14 min read
Extracção de dados de sites: um fluxo de trabalho prático com o DOM
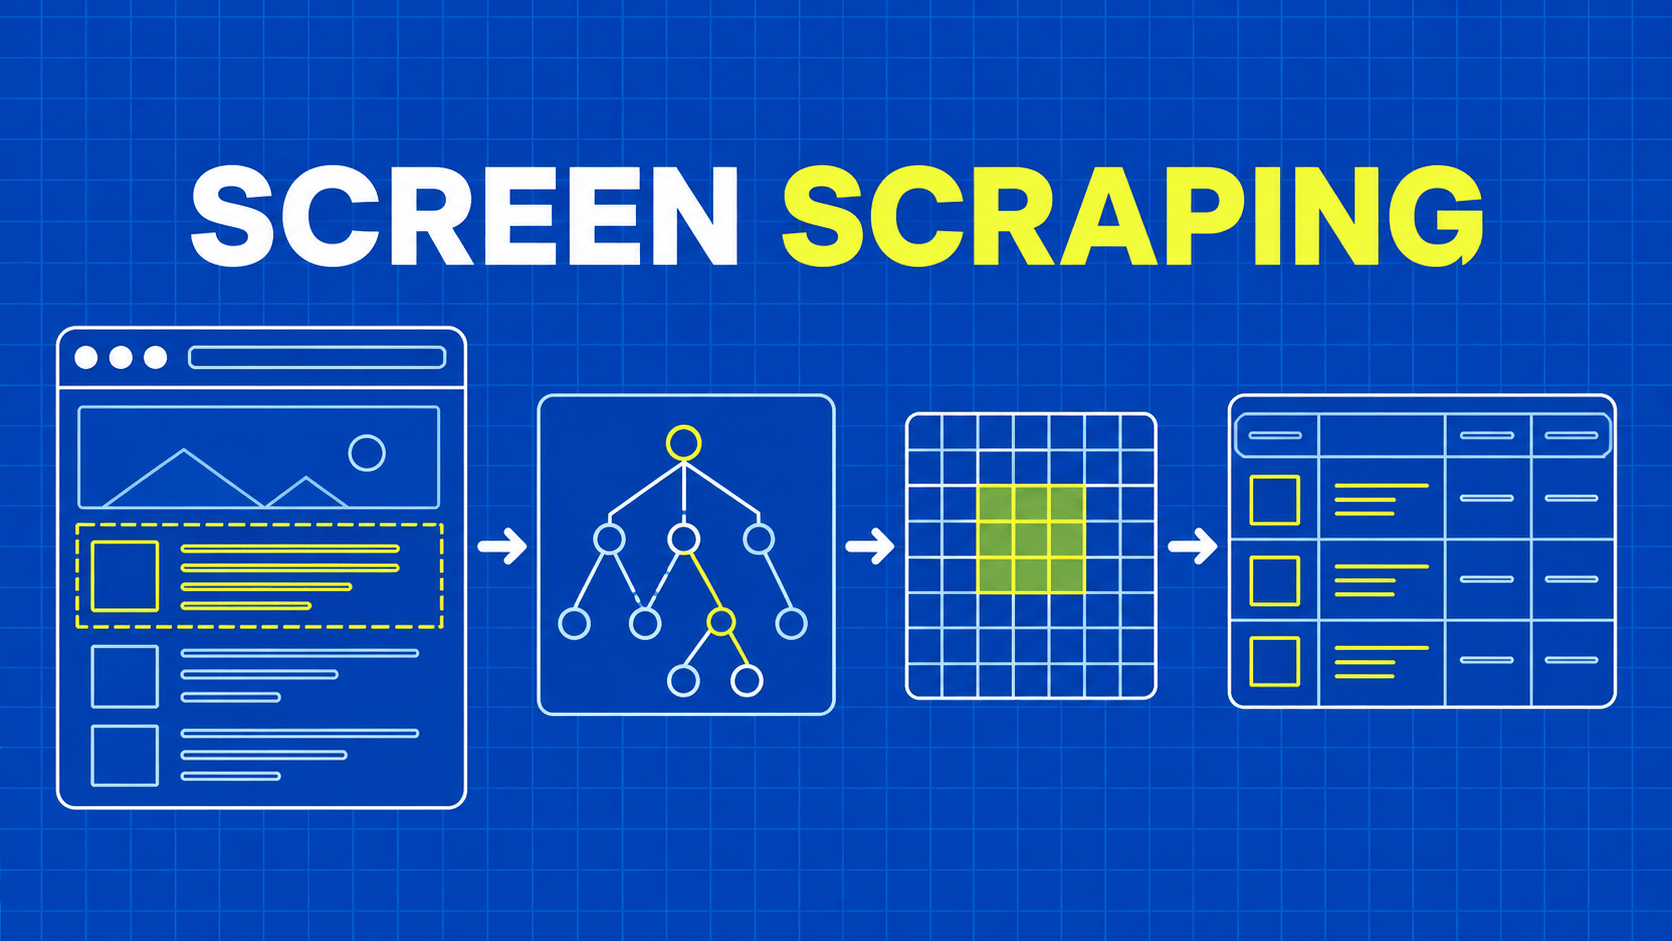
TL;DR: O «screen scraping» de sites consiste na extração de informação da camada de apresentação de um site. No caso de páginas web comuns, leia o DOM renderizado antes de recorrer a capturas de ecrã e OCR; em seguida, valide os registos e comprove que a recolha atingiu um ponto de paragem definido.

Uma ficha de produto apresenta um nome e um preço, mas o HTML que o seu script descarregou contém apenas um contentor vazio. O screen scraping de sites resolve essa lacuna ao recolher dados da página depois de o navegador ter realizado o trabalho necessário para a apresentar. O desafio prático consiste em decidir qual a representação que contém a informação de que necessita e quando essa representação está pronta.

A expressão também pode descrever a leitura de píxeis a partir de capturas de ecrã. Trata-se de problemas de engenharia distintos. Um navegador pode expor elementos estruturados, atributos e texto sem reconhecer qualquer imagem. O OCR parte dos píxeis e estima quais os caracteres que estes contêm, perdendo muitas das relações que o HTML já fornece.

Este guia apresenta um pequeno exercício controlado de extração a partir do navegador e, em seguida, alarga o seu raciocínio a tarefas reais de recolha de dados. Irá definir um registo, escolher localizadores, aguardar um estado significativo, identificar resultados incompletos e preservar provas quando a extração falhar. O exemplo utiliza uma página criada no interior do navegador, pelo que não depende de um site de terceiros nem gera tráfego para nenhum. Aplique o mesmo fluxo de trabalho apenas a páginas e dados que esteja autorizado a recolher.
Escolha a camada certa para a extração de dados de sites

Comece por um único campo obrigatório, como o preço de tabela atual. Verifique onde este se encontra antes de escolher uma ferramenta. Pode estar presente no HTML inicial, inserido no DOM após a execução do JavaScript, pintado numa tela ou incluído numa exportação autorizada. Cada possibilidade altera o método de recolha mais simples e fiável.

Representação disponível

Abordagem útil

Principal limitação a verificar

API documentada ou exportação

Utilize a interface estruturada suportada

Cobertura, âmbito de acesso e periodicidade de atualização

HTML da resposta inicial

Analisar o documento descarregado

Os dados podem só aparecer após a renderização

DOM renderizado

Utilizar um navegador e localizadores com âmbito

Estado de prontidão e alteração da estrutura de apresentação

Texto em canvas ou imagem

Utilize extração de imagens e OCR aprovados

Erros de reconhecimento e relações perdidas

A extração de dados de sites não requer uma captura de ecrã. Se um preço for um nó de texto dentro de uma ficha de produto, a extração desse nó mantém a sua relação com a ficha. Recortar o mesmo preço de uma imagem implica trabalho adicional: escolher um recorte, reconhecer caracteres, associar o resultado ao produto correto e detetar resultados incertos.

Um analisador HTTP continua a ser um bom ponto de partida quando o documento inicial contém os campos necessários. O nosso guia sobre clientes HTTP em Python explica a camada de pedidos que antecede a análise. Um navegador torna-se útil quando a tarefa de recolha depende da execução da página ou de interações permitidas, como selecionar um separador.

Encare a escolha como uma experiência. Recupere um exemplo autorizado através do método mais simples, compare os seus campos com a página visível e documente a diferença. Não recorra à automação do navegador apenas porque um site utiliza JavaScript em algum ponto. Por outro lado, uma resposta HTTP bem-sucedida não prova que a resposta inclua os dados desejados.

Mantenha a representação da fonte nos metadados de saída. Um registo obtido a partir de texto renderizado e um registo inferido a partir de uma imagem podem ter requisitos de revisão diferentes, mesmo quando os seus valores finais parecem idênticos.

Defina os registos antes de escrever ações no navegador

Anote o que cada linha significa. Para uma observação de catálogo, um registo útil pode conter um ID do produto de origem, o nome exibido, o texto do preço bruto, a moeda, o URL da página, a hora da observação e a versão da extração. Decida quais os campos que são obrigatórios e quais podem legitimamente faltar antes de executar o navegador.

A extração de dados de sites torna-se frágil quando os seletores decidem silenciosamente o esquema. Um nó de preço em falta não deve tornar-se automaticamente zero. Um preço rotulado como «a partir de» não deve tornar-se um preço exato sem manter esse qualificador. Um cartão de produto que apareça duas vezes em carrosséis separados não deve criar automaticamente dois produtos diferentes.

Mantenha o texto bruto juntamente com os valores normalizados quando a distinção for importante. Por exemplo, guarde «€1,249,00» como texto observado e deduza o montante numérico apenas com uma regra de localização conhecida. Adivinhar convenções de pontuação pode transformar um preço válido num valor errado em ordens de magnitude. A observação em bruto permite-lhe corrigir a transformação sem ter de voltar à página.

Escolha uma identidade de registo independentemente da ordem visual. É preferível utilizar um ID de origem quando a página o fornece numa representação permitida. Um URL canónico do produto pode funcionar quando as suas regras de identidade são compreendidas. O terceiro cartão na página não constitui uma identidade estável, uma vez que a ordenação, as recomendações e as alterações de inventário podem todos deslocá-lo.

Defina também o contexto de captura. A janela de visualização, o idioma, a conta e os filtros selecionados podem afetar o resultado apresentado. Quando estiver envolvida uma conta autorizada, gerencie explicitamente os cookies HTTP e a propriedade da sessão. Não partilhe uma sessão entre tarefas de clientes não relacionadas simplesmente porque já funciona.

Uma regra de aceitação útil assemelha-se a um teste: cada cartão aceite tem um ID e um nome não vazios, o texto do preço é mantido na íntegra, os IDs duplicados são classificados e a execução regista se foi concluída. Isto proporciona aos sites de «screen scraping» uma condição de sucesso observável para além de «o script terminou sem lançar uma exceção».

Extrair um fixture renderizado com o Playwright

Este exercício cria dois produtos fictícios após um breve atraso assíncrono, marca o catálogo como pronto e extrai registos estruturados. Instale o Playwright num projeto Node.js descartável, instale o seu navegador Chromium e guarde o JavaScript como um módulo ES, tal como collect.mjs. O exemplo não contém nenhuma solicitação de API, credenciais ou destino externo.

import assert from 'node:assert/strict';
import { chromium } from 'playwright';

const browser = await chromium.launch();
try {
  const page = await browser.newPage();
  await page.setContent(`
    <main id="catalog" data-ready="false"></main>
    <script>
      setTimeout(() => {
        document.querySelector('#catalog').innerHTML =
          '<article data-id="p1"><h2>Desk lamp</h2>' +
          '<span class="price">EUR 24.00</span></article>' +
          '<article data-id="p2"><h2>Notebook</h2>' +
          '<span class="price">EUR 6.50</span></article>';
        document.querySelector('#catalog').dataset.ready = 'true';
      }, 30);
    </script>
  `);
  await page.locator('#catalog[data-ready="true"]').waitFor();
  const records = await page.locator('#catalog article').evaluateAll(
    cards => cards.map(card => ({
      id: card.getAttribute('data-id'),
      name: card.querySelector('h2')?.textContent?.trim() ?? '',
      priceText: card.querySelector('.price')?.textContent?.trim() ?? ''
    }))
  );
  assert.deepEqual(records, [
    { id: 'p1', name: 'Desk lamp', priceText: 'EUR 24.00' },
    { id: 'p2', name: 'Notebook', priceText: 'EUR 6.50' }
  ]);
  console.log(JSON.stringify(records, null, 2));
} finally {
  await browser.close();
}

O importante é o contrato de prontidão, não o atraso utilizado para simular o trabalho. O coletor aguarda um atributo que indique que o fixture terminou de inserir os seus registos. Nunca assume que trinta milissegundos serão suficientes num site real. A asserção verifica o resultado completo, incluindo o número de registos e as suas associações.

A API de página do Playwright documenta a definição do conteúdo da página, enquanto a sua API de localização documenta a avaliação de elementos correspondentes. A chamada de retorno é executada no contexto da página e devolve dados simples. Os próprios objetos DOM do navegador não se tornam registos duradouros da aplicação.

Para a extração de dados de sites na prática, substitua o fixture pela navegação para uma página aprovada e substitua o seu marcador de prontidão por evidências específicas dessa página. Mantenha a etapa de validação. Um primeiro teste negativo útil consiste em remover um elemento de preço e verificar se o seu validador de produção rejeita ou coloca em quarentena a linha incompleta, em vez de a publicar como um resultado normal.

O fixture é intencionalmente suficientemente pequeno para ser compreendido. Não inclui agendamento, armazenamento persistente nem um rastreador geral. O nosso guia mais abrangente sobre extração com o Playwright fornece contexto adicional sobre o fluxo de trabalho do navegador quando estiver pronto para ir além de uma única extração.

Torne a prontidão e os seletores explícitos

Uma página pode terminar de carregar o seu documento antes de os dados úteis chegarem. Também pode manter as ligações de rede abertas depois de os dados necessários já estarem disponíveis. A extração de dados de sites requer uma condição ligada à tarefa de recolha, como um título de resultados e um indicador de carregamento concluído, em vez de uma pausa arbitrária.

Para uma ação interativa, localize o controlo através de uma propriedade estável e delimite-o à região relevante. Uma página pode conter vários botões «Seguinte» em galerias de produtos, resultados de pesquisa e conteúdos relacionados. Clicar no primeiro texto correspondente não é prova suficiente de que o coletor avançou na lista pretendida. O Playwright recomenda atributos visíveis ao utilizador e contratos explícitos nas suas orientações de localização.

Distinga a prontidão da ação da integridade do conjunto de dados. O facto de um botão estar visível e clicável não significa que todas as linhas de resultados estejam presentes. Após o clique, verifique se o marcador da página resultante ou o conjunto de registos mudou e se a condição de conclusão específica da página se mantém. Se mantiver a aplicação de origem, adicionar um atributo de prontidão estável torna este contrato testável.

Escolha a extração de texto de forma deliberada. O MDN descreve o `innerText` como sensível à aparência renderizada, enquanto o `textContent` lê o texto do nó sem essa sensibilidade à renderização. Nenhum dos dois constitui uma definição automática do campo de negócio. Extraia a partir de um elemento de preço específico, em vez de ler um cartão na íntegra e esperar separar os rótulos posteriormente.

Por exemplo, um cartão pode conter o preço atual, um preço riscado, texto de entrega e um rótulo de acessibilidade oculto. Uma extração de texto abrangente pode combinar os quatro. Decida se o registo necessita do preço atual exibido, do preço original ou de ambos e, em seguida, utilize campos nomeados e localizadores separados.

Quando um seletor falhar, indique o erro de forma visível. Evite uma cadeia de fallback que se alargue gradualmente até encontrar texto não relacionado. Durante a extração de dados de sites, um erro claro de campo em falta é mais fácil de corrigir do que uma execução bem-sucedida repleta de valores plausíveis, mas incorretos.

Verifique se a paginação e a rolagem estão completas

Dez cartões corretos da primeira página continuam a ser um conjunto de dados incompleto quando a tarefa requer toda a categoria. Defina uma condição de paragem antes de introduzir um ciclo. Para páginas paginadas, isso pode ser um indicador de página final documentado ou um controlo «seguinte» desativado. Para uma interface «carregar mais» aprovada, pode ser um marcador de fim explícito.

A extração de dados de sites com deslocamento infinito requer um cuidado especial, porque algumas listas virtualizam o seu conteúdo. Reutilizam um pequeno grupo de nós DOM à medida que o leitor percorre uma coleção maior. Contar os elementos atualmente no documento pode, portanto, subestimar o número de registos que apareceram, e tirar um instantâneo final do DOM pode deixar de incluir registos anteriores.

Recolha cada lote após a condição de prontidão ser satisfeita, utilizando a identidade da fonte para deduplicar as observações. Acompanhe os IDs já aceites, o último marcador de navegação e o número de tentativas consecutivas que não produziram novos IDs. Trate um limite de ausência de progresso como uma paragem de proteção com um estado incompleto, a menos que a fonte também forneça uma condição de fim fiável.

Utilize trabalho delimitado mesmo quando a interface parecer interminável. Defina um número máximo de páginas, tempo decorrido e número de registos adequados à tarefa. Registe qual o limite que pôs fim à execução. «Interrompido após o limite de páginas configurado» e «atingiu a página final da fonte» têm significados diferentes para os utilizadores a jusante.

Guarde pontos de verificação após os dados aceites terem sido armazenados de forma duradoura. Se um processo falhar entre a recolha e a persistência, retomar a partir de um cursor que tenha sido guardado demasiado cedo pode fazer com que se saltem registos. Reproduzir uma página é mais seguro quando o seu destino deduplica com base numa identidade estável e numa política de observação.

No caso de um catálogo em constante mudança, a completude também é temporal. Os itens podem deslocar-se entre páginas enquanto a execução estiver ativa. Registe a janela de recolha e evite referir-se à saída como um instantâneo exato, a menos que a fonte ofereça essa garantia. Uma tarefa de observação diária pode ser útil sem pretender descrever um estado instantâneo.

Estes limites transformam a extração de dados de sites a partir de uma macro do navegador num processo de recolha cujos limites podem ser explicados e testados.

Utilize capturas de ecrã e OCR apenas quando os píxeis forem relevantes

Uma captura de ecrã é uma prova útil quando a apresentação visual é, ela própria, parte da questão. Pode mostrar um preço em falta, uma caixa de diálogo inesperada ou um layout que já não corresponde ao contrato de extração. O Playwright suporta capturas de páginas e elementos através da sua interface de capturas de ecrã.

O OCR é uma transformação separada aplicada a essa imagem. Considere-o quando a informação autorizada estiver genuinamente disponível apenas na forma de píxeis, como texto desenhado numa tela, e não existir nenhuma representação estruturada adequada. Não o utilize para resolver desafios de acesso ou contornar a recusa de acesso de um site. Interrompa o processo e resolva os problemas de permissão ou acesso através do proprietário.

A captura de ecrãs de sites através de OCR requer uma política de incerteza. Caracteres semelhantes, pontuação decimal, texto cortado e baixo contraste podem alterar o resultado. Uma cadeia de caracteres que passe num analisador numérico básico pode ainda assim representar o preço errado. Mantenha juntos a região relevante da imagem, o texto reconhecido, a versão da transformação e qualquer sinal de confiança disponível.

Analise os campos de alto impacto em relação a uma restrição independente. Um montante monetário reconhecido pode necessitar tanto de um rótulo de moeda conhecido como de um formato coerente. Um identificador de produto pode ter um comprimento fixo ou uma soma de verificação. Estas verificações podem detetar alguns erros, mas não provam que um resultado plausível corresponda à imagem de origem.

No caso de capturas de ecrã utilizadas como artefactos de depuração, recorte a região relevante e limite o período de retenção. O acesso autorizado a uma página não significa que todos os detalhes visíveis da conta devam fazer parte de um arquivo de diagnóstico permanente. Registe o motivo pelo qual a imagem foi capturada, restrinja o acesso e elimine-a quando a investigação já não precisar dela.

O mesmo cuidado aplica-se aos instantâneos HTML: podem existir campos ocultos e conteúdo específico da conta, mesmo quando a captura de ecrã parece inofensiva. Armazene o mínimo de evidência necessária para reproduzir o problema de extração.

Pontos-chave

  • Inspecione a representação de origem antes de selecionar uma ferramenta. O HTML inicial, o DOM renderizado e os píxeis da imagem requerem estratégias diferentes de extração e validação.
  • Certifique-se de que a preparação descreve os dados de que necessita e valide o registo extraído na íntegra, em vez de verificar apenas se uma ação do navegador foi bem-sucedida.
  • Defina a identidade, o fim da paginação, o momento dos pontos de verificação e os estados de execução incompleta antes de expandir um coletor para além de uma página.
  • Preserve as observações em bruto quando a normalização puder alterar o significado. Utilize capturas de ecrã de forma seletiva e aplique regras de revisão explícitas aos resultados do OCR.

Perguntas frequentes

As extensões do navegador podem ser uma ferramenta útil de prototipagem?

Sim. Uma extensão pode ajudar a inspecionar uma página ou a testar uma pequena ideia de extração antes de criar um coletor programado. Avalie o seu acesso aos dados e o comportamento de exportação antes de a instalar num navegador autenticado. Um protótipo manual bem-sucedido ainda necessita de entradas reproduzíveis, validação e responsabilidade operacional antes de se tornar uma tarefa de produção fiável.

O texto extraído deve ser traduzido durante a recolha?

Normalmente, mantenha o idioma original no registo bruto e traduza numa etapa separada. A tradução altera a observação e pode complicar as comparações entre execuções. Armazene o idioma de origem, o resultado traduzido e a versão da transformação separadamente, para que uma correção na tradução não exija outra visita à página de origem.

Como deve uma equipa transferir um coletor existente?

Forneça o contrato de extração, um pequeno fixture aprovado, o resultado esperado e exemplos de falhas classificadas. Indique quem detém o acesso à fonte e quais as tarefas a jusante que consomem o resultado. O próximo responsável pela manutenção deve ser capaz de reproduzir uma extração bem-sucedida e reconhecer uma execução incompleta sem depender do histórico do navegador do autor original.

Crie um coletor com um resultado explicável

O primeiro marco útil na extração de dados de sites é um registo validado com proveniência conhecida. Comece por aí e, só depois, adicione navegação, persistência e agendamento, apenas quando as respetivas condições de sucesso forem igualmente claras. Deve ser capaz de explicar de onde veio cada campo, por que razão a página estava pronta e o que fez com que a execução parasse.

Antes de uma implementação mais ampla, simule um campo em falta, uma página repetida e uma alteração na fonte que não produza novos registos. Confirme se estes cenários conduzem a classificações explícitas, em vez de relatórios de sucesso vazios. Este pequeno conjunto de falhas revela frequentemente se o seu fluxo de trabalho tem um contrato de dados real ou apenas uma sequência de ações do navegador.

Se a infraestrutura do navegador se tornar o fator que limita o seu fluxo de trabalho de recolha autorizado, avalie a API do navegador da WebScrapingAPI para controlo de navegadores alojados. Mantenha o seu esquema de registos, as regras de prontidão e a validação independentes da escolha da infraestrutura, para que continuem a poder ser revistos à medida que o sistema cresce.

Sobre o autor

Raluca Penciuc, Desenvolvedor Full-Stack @ WebScrapingAPI

Raluca Penciuc

Desenvolvedor Full-Stack

Raluca Penciuc é programadora Full Stack na WebScrapingAPI, onde desenvolve scrapers, aperfeiçoa estratégias de evasão e procura formas fiáveis de reduzir a deteção nos sites-alvo.

Web Scraping com AWS Lambda: Guia para Python e Java 2026
Guias

Web Scraping com AWS Lambda: Guia para Python e Java 2026

TL;DR: Resumo: A extração de dados da Web com o AWS Lambda funciona melhor quando cada invocação é curta, delimitada e pode ser repetida de forma independente. Comece com HTTP direto, AWS SAM e S3 e, só depois, adicione SQS, contentores, renderização no navegador, proxies ou uma camada de recuperação gerida, apenas quando a carga de trabalho demonstrar que precisa deles.

Suciu Dan32 min read
Ler artigo
Como utilizar o GoSpider: rastrear, limpar URLs e extrair dados
Guias

Como utilizar o GoSpider: rastrear, limpar URLs e extrair dados

TL;DR: Resumo: O GoSpider é um rastreador de linha de comandos destinado a descobrir URLs, não um extrator completo de dados estruturados. Este guia sobre como utilizar o GoSpider mostra como realizar um rastreio limitado, gerir resultados de forma organizada, fazer a transferência de dados do Colly para CSV e seguir um percurso de diagnóstico para respostas 403 ou páginas que exijam renderização em JavaScript.

Suciu Dan23 min read
Ler artigo
Como fazer o Scrape Redfin: Guia Python para Dados de Propriedade
Guias

Como fazer o Scrape Redfin: Guia Python para Dados de Propriedade

TL;DR: A Redfin expõe pontos de extremidade de API ocultos que retornam JSON estruturado para listagens de propriedades, tornando possível ignorar totalmente a análise HTML frágil. Este guia orienta-o na construção de um scraper Python que extrai dados de aluguer e venda, pesquisa por localização, monitoriza novas listagens através de sitemaps XML e exporta resultados limpos para CSV ou JSON.

Suciu Dan14 min read
Ler artigo

Comece a construir

Pronto para expandir a sua recolha de dados?

Junte-se a mais de 2.000 empresas que utilizam a WebScrapingAPI para extrair dados da Web à escala empresarial, sem quaisquer custos de infraestrutura.
