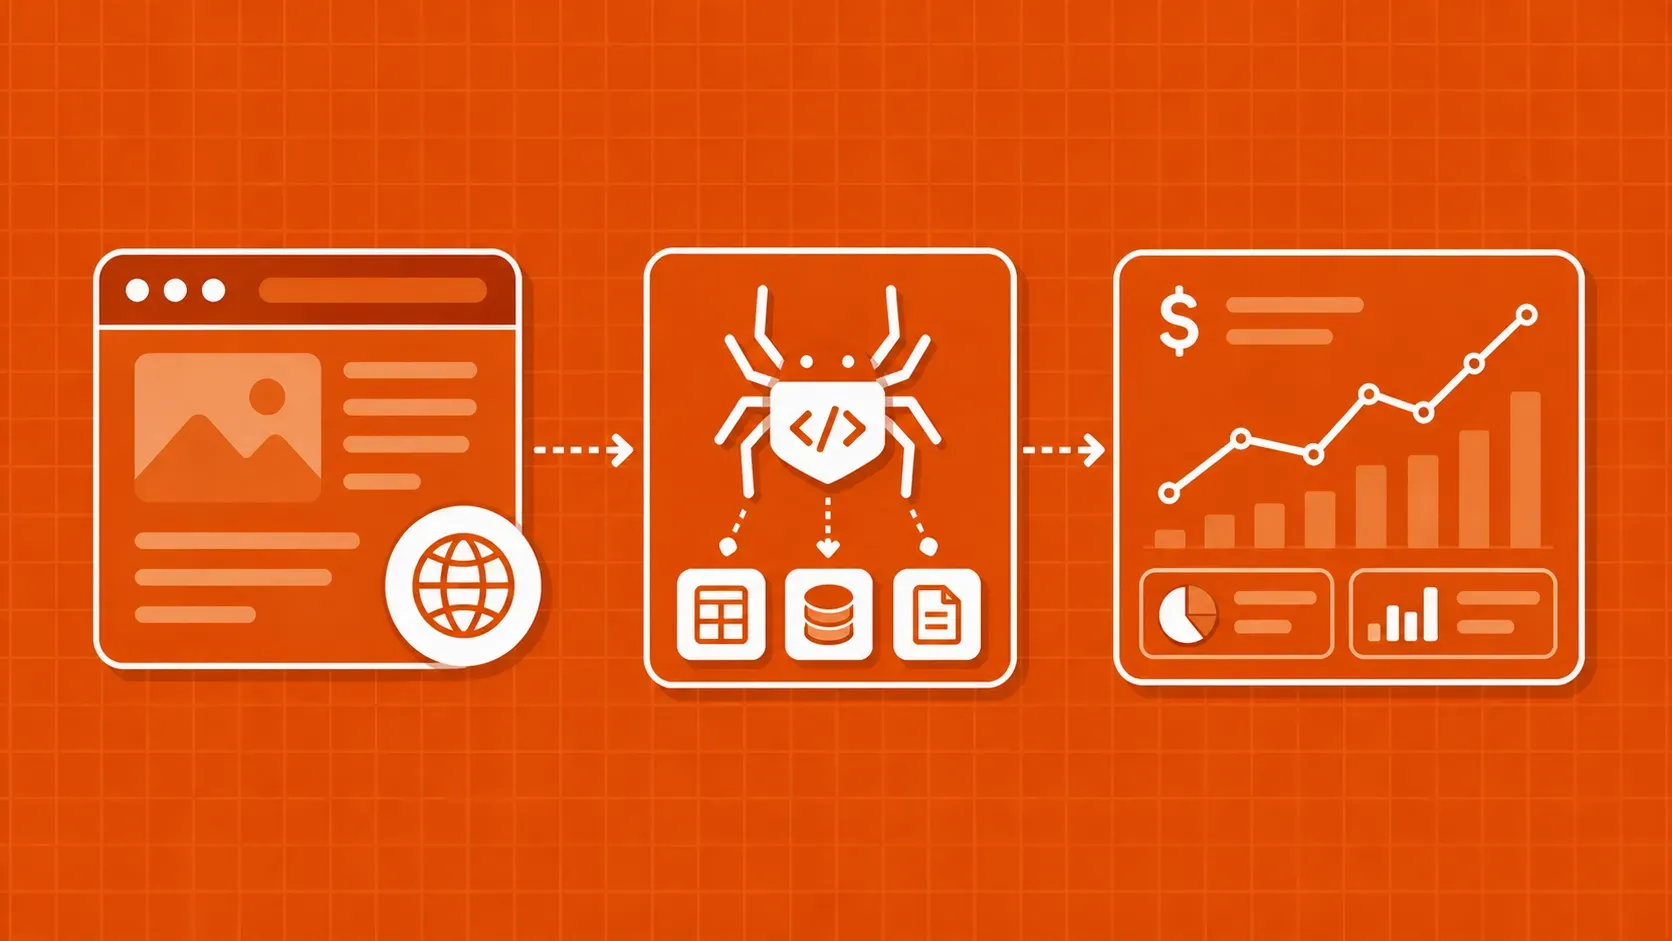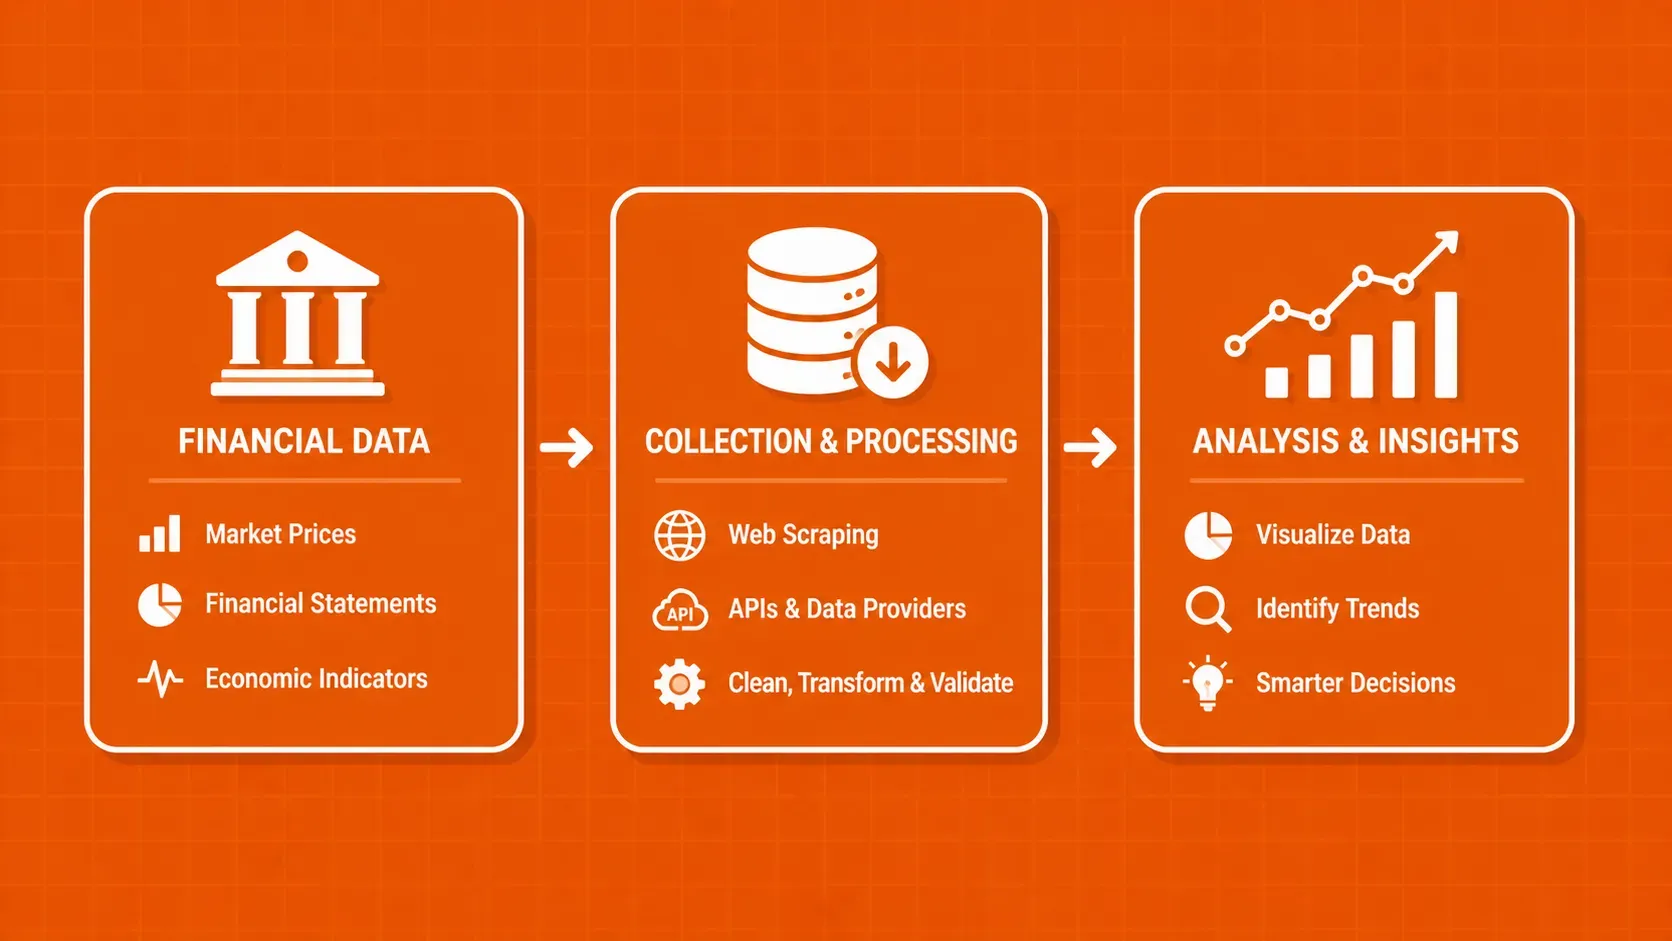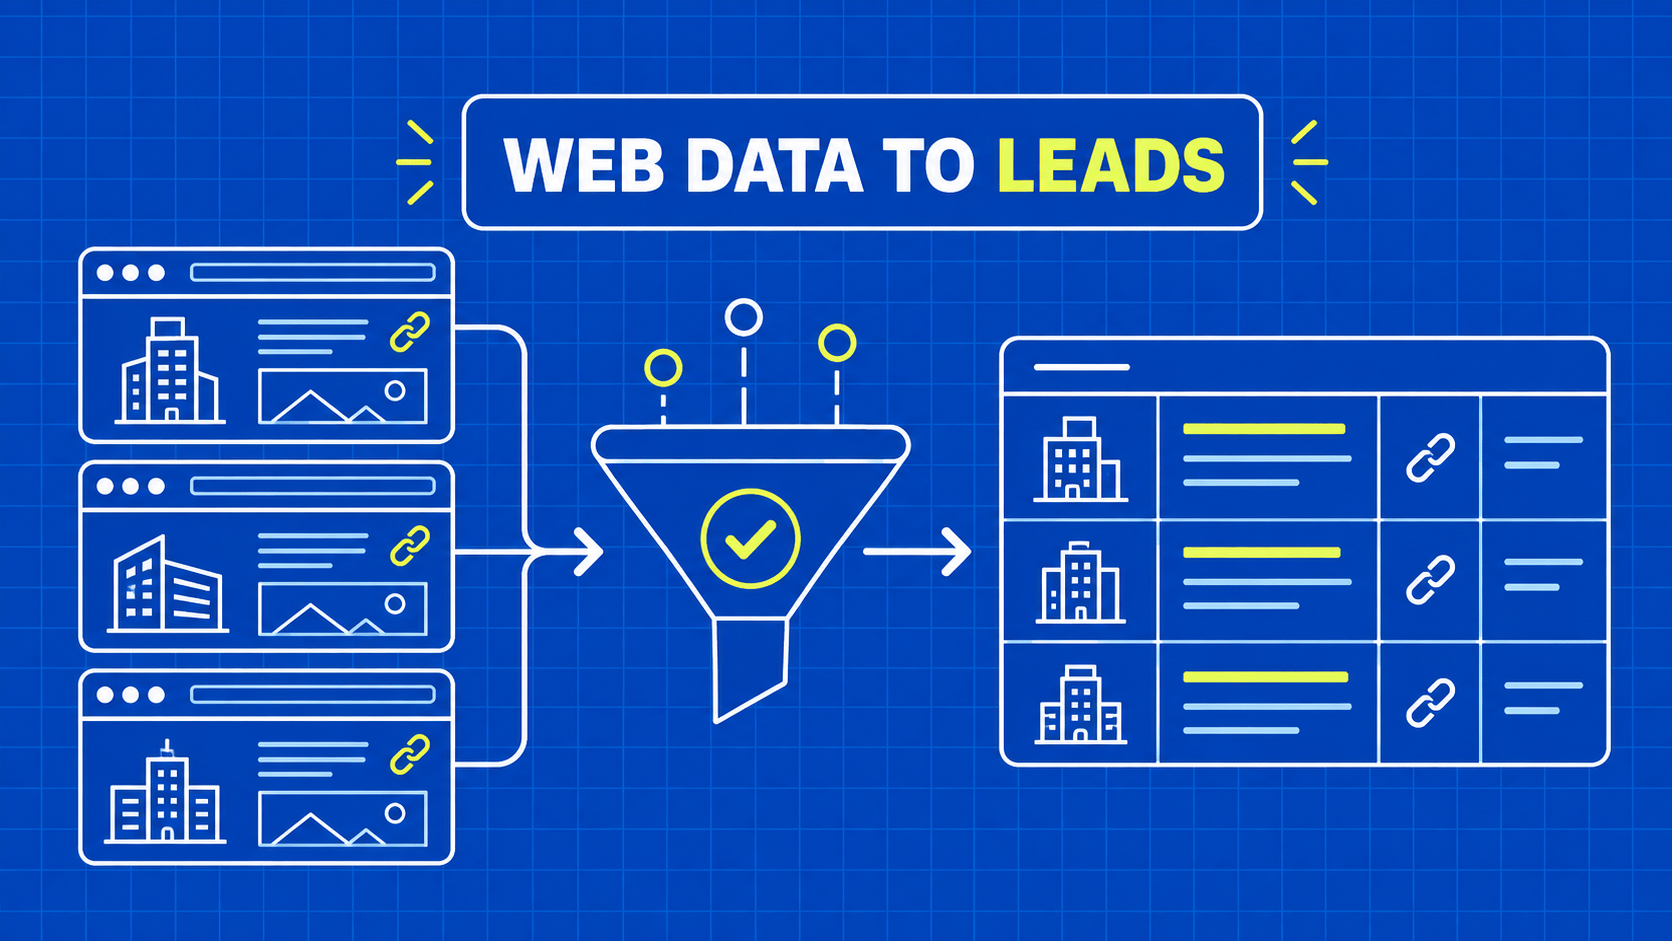
Resumo: o web scraping para geração de leads transforma sites de empresas e diretórios autorizados em dados de contas estruturados. Monte o pipeline em torno da identidade da empresa, das evidências de origem, da atualidade dos dados e da correspondência com o CRM. Trate a permissão para contatar alguém como uma decisão separada da coleta de um registro de empresa.
Web scraping para geração de leads é a coleta automatizada de informações de sites para descobrir e avaliar contas empresariais em potencial. Um resultado útil é um registro de empresa com domínio verificado, atributos de negócio relevantes e evidências que explicam por que ele pertence ao seu pipeline de vendas.
Pesquisa de mercado, análise da concorrência e monitoramento de marca estão, ao lado da geração de leads, entre os casos de uso de web scraping para empresas.
Pense em duas exportações. Uma contém milhares de nomes de empresas e uma coluna chamada “qualificado”. A outra contém menos contas, mas cada linha traz o site oficial, o serviço oferecido, quando esse fato foi observado e a fonte por trás da qualificação. Os desenvolvedores conseguem depurar a segunda exportação. A equipe de Sales Ops consegue revisá-la. Nenhuma das duas equipes precisa confiar em uma pontuação misteriosa.
Este guia busca o segundo resultado. Você vai definir a conta de que precisa, selecionar fontes, extrair um esquema propositalmente enxuto, normalizar identidades e entregar registros revisados a um CRM. Os exemplos se concentram em organizações e nas atividades de negócio que elas publicam, e não na coleta em massa de dados de contato pessoais. A mesma arquitetura funciona quer você comece por um diretório setorial autorizado, quer por uma lista de sites de empresas que já mantém.
As páginas de empresas no LinkedIn são uma dessas fontes, e nosso guia sobre como fazer scraping do LinkedIn com Python mostra quais campos de empresa estão acessíveis sem login.