Saltar para o conteúdo
Comece grátis
Voltar ao blogue

Dicas sobre a API REST para uma recolha de dados fiável

Robert SfichiÚltima atualização em 17 min read
Dicas sobre a API REST para uma recolha de dados fiável
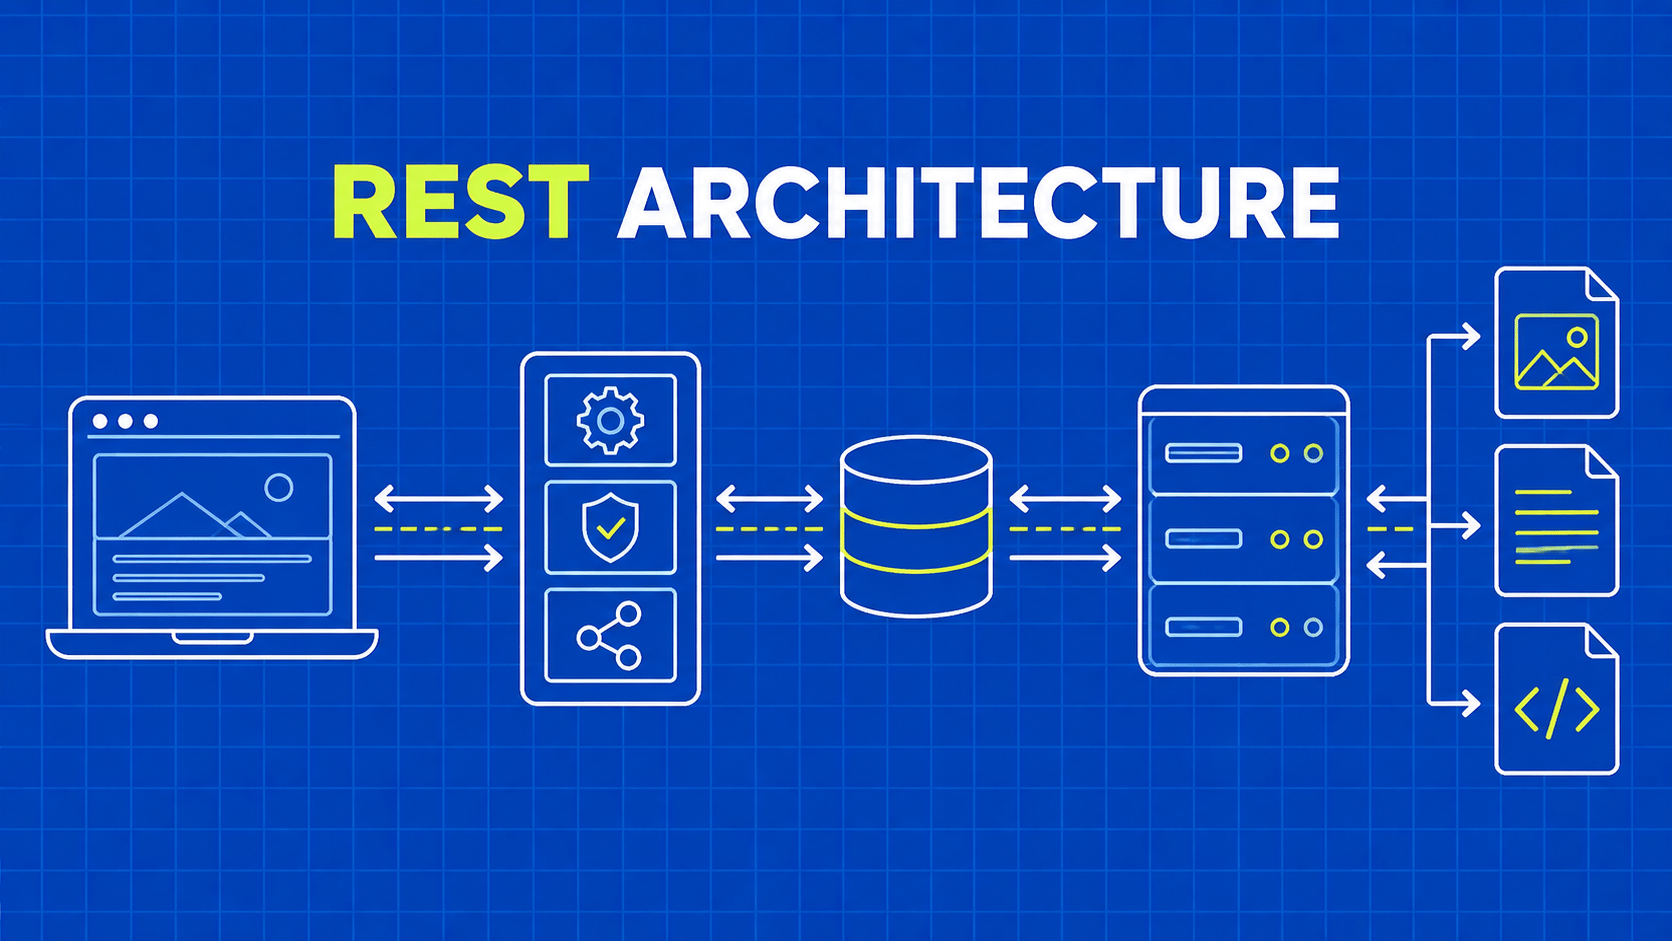
TL;DR: Uma API de recolha útil oferece aos clientes uma forma clara de solicitar dados, continuar uma percussão, recuperar-se de falhas e saber o que foi recolhido. Estas dicas sobre a API REST associam cada contrato do lado do servidor ao comportamento que um consumidor fiável deve implementar.

Um coletor recupera três páginas, entra em timeout na quarta e reinicia na manhã seguinte. O facto de ignorar registos, duplicar o trabalho ou retomar com segurança depende de decisões tomadas muito antes desse timeout. As dicas sobre APIs REST são mais úteis quando abordam essas decisões como contratos concretos entre o produtor e o consumidor.

Este guia centra-se em APIs que expõem dados para recolha recorrente, sincronização ou análise. O objetivo não é resolver todas as discussões arquitetónicas sobre REST. Trata-se de tornar a interface previsível quando os conjuntos de dados mudam, as credenciais expiram, os pedidos falham e os clientes atualizam-se em momentos diferentes.

Para cada escolha de design, considere o que o cliente deve manter e o que pode inferir com segurança. Um campo denominado next não é suficiente se o cursor expirar sem documentação. Uma mensagem de erro não é suficiente se os clientes não conseguirem distinguir uma sobrecarga temporária de uma entrada inválida. Uma resposta bem-sucedida não é suficiente se alterar silenciosamente o significado de um campo de preço.

As sete secções abaixo abordam contratos de recursos, paginação, tratamento de falhas, pedidos condicionais, controlo de acesso, evolução de esquemas e prova operacional. Também fornecem uma lista de verificação para programadores que utilizam uma API que não conceberam: identifique o que a interface garante e, em seguida, torne visível todas as garantias em falta no plano de recolha.
1. Baseie as dicas sobre a API REST num contrato de recursos

Descreva um registo antes de conceber uma grande família de endpoints. Para um item de catálogo, defina o seu identificador estável, o significado do seu preço, a sua moeda, os campos opcionais e o carimbo de data/hora de atualização. Explique se um campo omitido difere de um campo cujo valor é nulo. Estas escolhas determinam a forma como os consumidores armazenam e comparam observações.

Atribua significados igualmente precisos aos filtros. Se updated_after for suportado, especifique o formato do carimbo de data/hora, o fuso horário e se o limite é inclusivo. Explique se o filtro se aplica a alterações comerciais, a qualquer atualização da base de dados ou à hora de publicação. Um cliente não consegue construir um coletor incremental correto quando vários eventos diferentes partilham uma etiqueta ambígua de «atualizado».

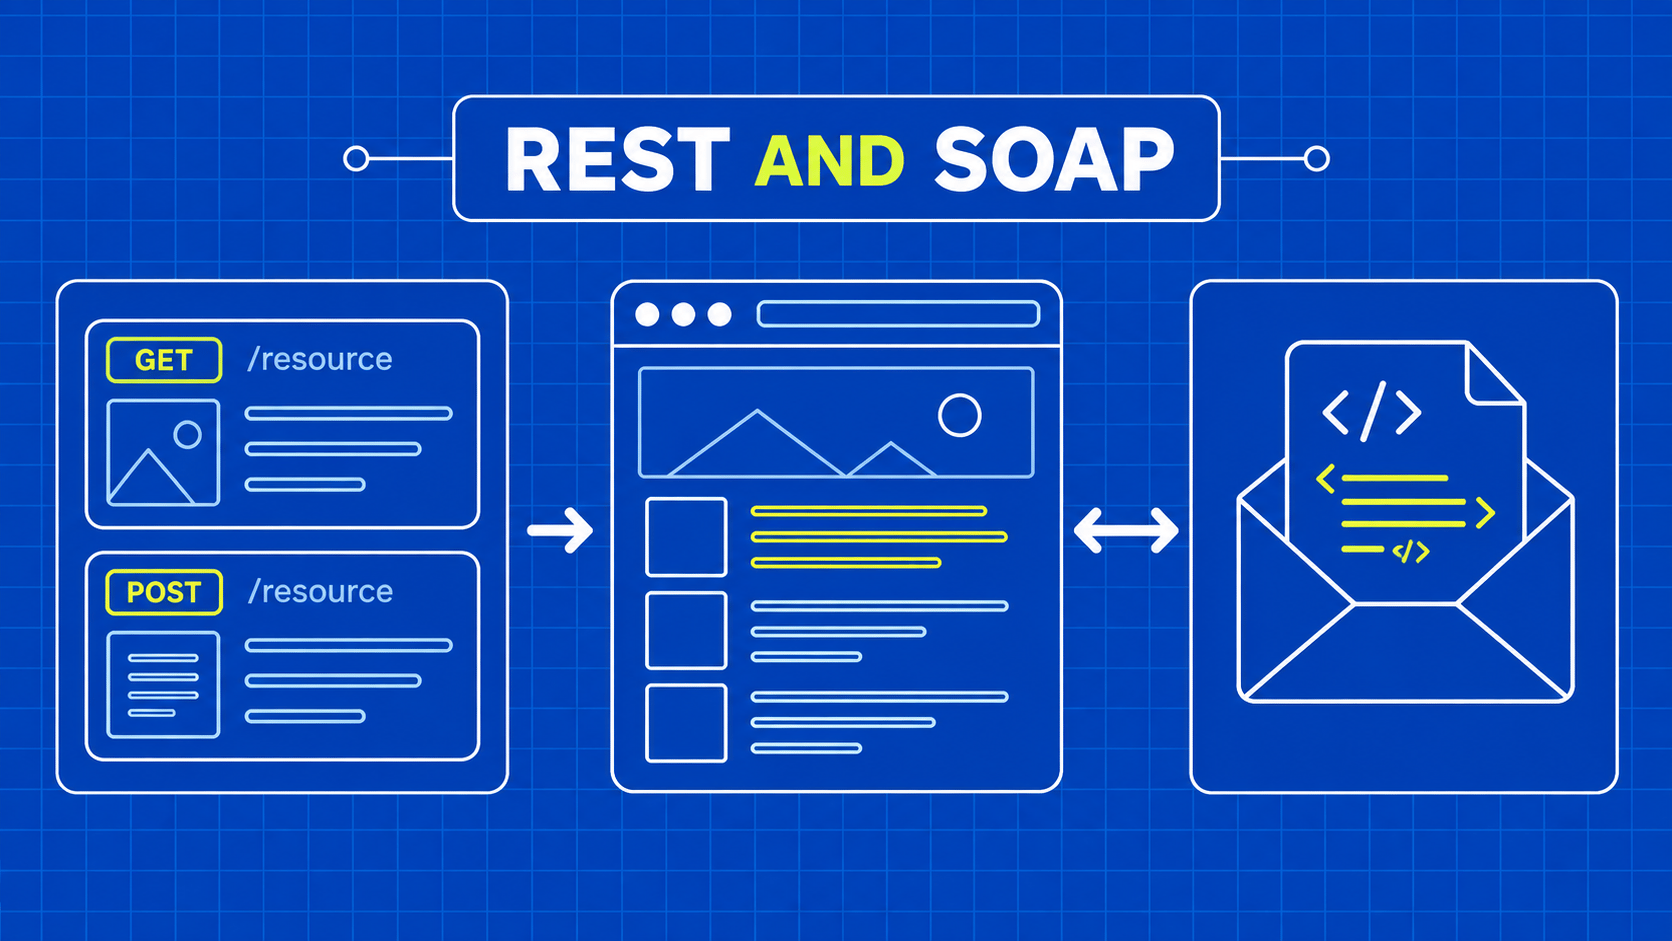
Utilize os métodos HTTP de forma consistente com a sua semântica. Um ponto de extremidade de recuperação não deve criar uma exportação faturável apenas por receber um GET. Se o início de uma tarefa alterar o estado da aplicação, atribua a essa operação um contrato explícito e documente como recuperar o seu resultado. A distinção entre métodos seguros e métodos idempotentes é definida na semântica HTTP.

Estas dicas sobre a API REST também se aplicam às escolhas de representação. Uma resposta de recolha pode utilizar um envelope com registos e metadados de paginação, mas o envelope necessita de um esquema documentado. Evite obrigar os consumidores a inspecionar mensagens legíveis por humanos para descobrir se os dados estão completos. Se uma resposta for parcial, indique esse facto num campo legível por máquina com um significado definido.

Detalhes do contrato

O produtor deve definir

O consumidor deve preservar

Identidade

ID estável e política de reutilização

ID de origem separadamente da posição da linha

Hora

Fuso horário e significado da atualização

Carimbo de data/hora original mais resultado da análise

Valor monetário

Moeda e unidade

Montante e moeda com precisão decimal

Dados em falta

Semântica de «omitido» versus «nulo»

Distinção exigida pelo esquema

Conclusão

Resultado completo versus resultado parcial

Estado da execução e janela de recolha

Quando um cliente implementar esta interface, deve reter respostas em bruto de forma seletiva para fins de diagnóstico e armazenar registos normalizados separadamente. Não transforme automaticamente todos os campos desconhecidos numa coluna de produção. Chegue a um acordo sobre o que o conjunto de dados a jusante promete e, em seguida, mapeie o contrato de origem para o mesmo de forma explícita.

2. Conceba uma paginação que resista a um reinício

Uma referência útil à página seguinte representa a continuação de acordo com regras documentadas. Indique se a API utiliza números de página, deslocamentos, cursores ou ligações geradas pelo servidor. Explique quais os filtros e a ordem de ordenação que devem permanecer inalterados durante a percorrida. Se os cursores expirarem, publique o tempo de vida ou as condições sob as quais se tornam inválidos.

As dicas sobre paginação em APIs REST limitam-se frequentemente à escolha do tamanho da página. A questão mais complexa é como os dados subjacentes podem alterar-se entre pedidos. Um deslocamento pode mudar quando um item é inserido antes da posição atual. Um cursor pode reduzir alguns problemas de percurso, mas não fornece automaticamente um instantâneo imutável. Indique a garantia de consistência separadamente do mecanismo de paginação.

Dê preferência a fornecer aos consumidores a referência de continuação que devem seguir, em vez de exigir que eles criem uma. A paginação REST documentada pelo GitHub utiliza links na resposta para indicar páginas relacionadas; o seu guia de paginação é um exemplo concreto de um cliente que segue o contrato de navegação do servidor. Outras APIs utilizam um token no corpo da resposta, pelo que os consumidores devem consultar a documentação específica.

Documente uma condição de terminação definitiva. A ausência de um cursor seguinte pode significar a conclusão, enquanto uma página curta pode ou não significar o mesmo. Evite exigir que os clientes deduzam o fim a partir da contagem de registos, a menos que esse comportamento faça parte do contrato. Inclua um exemplo de resultado vazio, pois zero registos é um resultado normal do negócio, não necessariamente uma falha.

O consumidor só deve persistir um ponto de verificação depois de a página correspondente ter sido aceite e armazenada. Se o armazenamento do ponto de verificação e o armazenamento dos registos forem separados, garanta a segurança da reprodução através da deduplicação ou da coordenação transacional. Guardar o cursor seguinte antes de guardar os registos atuais cria uma lacuna após uma falha do sistema.

Defina limites de proteção para páginas, tempo e valores de continuação repetidos. Se um servidor devolver o mesmo cursor duas vezes, o cliente deve parar com uma falha de paginação classificada, em vez de entrar num ciclo infinito. Uma paragem de proteção deve permanecer distinguível da conclusão normal.

Para coleções que mudam frequentemente, documente uma estratégia de reconciliação. Um cliente pode combinar a recolha incremental com uma comparação completa periódica, desde que ambas se mantenham dentro da utilização prevista da API. As eliminações também necessitam de um acordo: o desaparecimento de um registo de uma página é uma prova fraca de eliminação se a percorrida estiver incompleta.

3. Torne os erros e as tentativas de repetição uma política comum

Separe as categorias de erros que exigem ações diferentes. Um filtro inválido requer um pedido corrigido. Uma credencial expirada requer o fluxo de autenticação documentado. Uma sobrecarga temporária pode justificar a espera. A resposta do servidor deve expor um código de erro estável, um estado HTTP apropriado e um identificador de pedido que ajude as equipas de suporte a rastrear a falha sem incluir informações confidenciais.

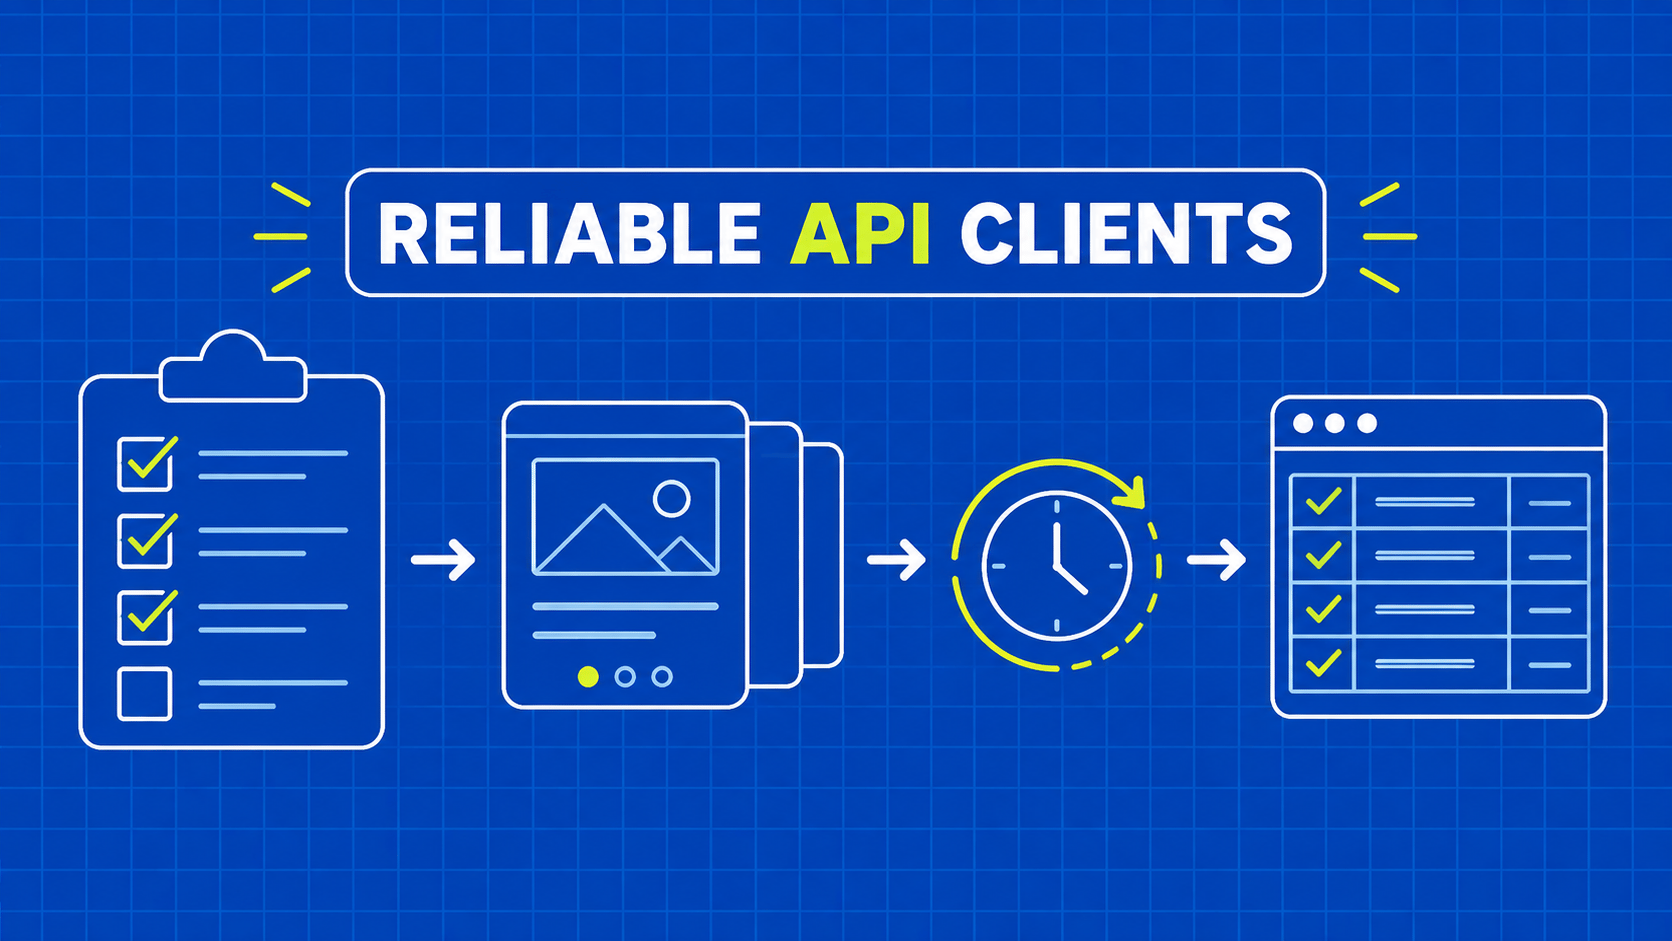
As melhores dicas para APIs REST limitam a recuperação. Os produtores devem descrever quais as respostas que podem ser repetidas e como se aplicam os limites de taxa. Os consumidores devem utilizar um número máximo de tentativas, um tempo total disponível e uma política de atraso, em vez de repetirem indefinidamente todas as exceções. Uma falha repetida deve resultar num trabalho incompleto visível, acompanhado de um diagnóstico útil.

Quando fornecido, deve ser interpretado Retry-After de acordo com o formato definido: pode ser um atraso em segundos ou uma data HTTP. A referência «Retry-After» da MDN documenta ambas as formas. Um cliente cujo tempo restante para a tarefa não consiga acomodar o atraso solicitado deve adiar ou encerrar a tarefa explicitamente, em vez de tentar novamente mais cedo.

Utilize jitter com backoff quando uma política de repetição permitir novas tentativas, para que os trabalhadores não sejam todos ativados no mesmo instante. Coordene os limites de taxa entre os trabalhadores que partilham a mesma conta ou token. Limitar cada processo independentemente pode ainda assim sobrecarregar uma quota ao nível da conta quando muitos processos são executados em simultâneo.

Tenha mais cuidado com operações que criem exportações, subscrições ou outro estado. Um tempo de espera não prova que o servidor não tenha feito nada; pode significar que a resposta se perdeu após a conclusão da operação. Se a API suportar chaves idempotentes, documente o seu âmbito, retenção e comportamento quando a mesma chave acompanhar uma carga útil diferente. Os utilizadores devem reutilizar a chave para a mesma operação lógica, de acordo com esse contrato.

As melhores práticas da API REST do GitHub ilustram por que razão as orientações do fornecedor são importantes: incluem conselhos específicos sobre pedidos sequenciais, erros de limitação de taxa e pedidos condicionais. Não presuma que outro fornecedor tenha quotas idênticas ou um comportamento de repetição de tentativas semelhante.

Para a implementação do cliente, escolha uma biblioteca HTTP com controls explícitos de timeout e gestão de ligações. O nosso guia do cliente HTTP em Python fornece contexto para essa camada. Mantenha a classificação das respostas fora do wrapper de transporte genérico, para que o significado específico do endpoint permaneça visível e testável.

4. Forneça aos clientes validadores e uma estratégia de atualização

Um coletor recorrente não deve ter de descarregar uma representação de grandes dimensões apenas para descobrir que nada mudou. Sempre que apropriado, exponha validadores, tais como ETags, e documente o comportamento das solicitações condicionais. O cliente pode reter o validador e enviar a condição relevante numa solicitação subsequente.

As dicas sobre a API REST relativas ao armazenamento em cache devem distinguir os bytes transferidos da correção dos dados. Um ETag identifica uma representação ao abrigo do contrato do servidor; não é necessariamente um carimbo temporal ou um hash de conteúdo que o cliente deva descodificar. Trate o valor como opaco. Armazene-o juntamente com a identidade da solicitação e a representação em cache que este valida.

Para um GET condicional que receba uma resposta «not-modified», utilize a representação armazenada existente. Não introduza um corpo de resposta vazio no analisador JSON normal nem substitua a coleção em cache por um array vazio. Um consumidor sem o corpo em cache correspondente não pode utilizar essa resposta como se contivesse um conjunto de dados atualizado.

Inclua o contexto relevante da solicitação na chave de cache: ponto de extremidade, parâmetros de consulta, representação selecionada e qualquer partição de identidade exigida pela API. Uma resposta armazenada em cache para uma conta não deve ser servida a outra conta apenas porque a URL coincide. Documente como a autorização e a personalização afetam o armazenamento em cache.

Conceba filtros e validadores incrementais como ferramentas separadas. Um validador de coleção pode indicar que a representação solicitada permanece inalterada; um filtro de atualização solicita registos que cumpram uma condição temporal. Nenhum deles explica automaticamente eliminações, carimbos de data/hora retroativos ou páginas reordenadas. Indique qual o problema que cada mecanismo resolve.

Estas dicas sobre a API REST devem conduzir a um plano de atualização explícito. Por exemplo, um consumidor pode validar representações de recursos acedidos com frequência, consultar um feed de atualizações para novas observações e reconciliar o conjunto de dados completo de acordo com um calendário aprovado. O calendário exato é uma decisão empresarial e de capacidade, não uma garantia HTTP.

Teste o caminho «sem alterações» com o mesmo cuidado que o caminho de resposta completa. É fácil um coletor funcionar na sua primeira execução e falhar apenas quando os validadores começam a suprimir os corpos das respostas. Teste também a perda de cache, para que a recuperação não dependa de dados que já não existem localmente.

5. Mantenha a autenticação restrita e observável

Conceda às integrações o mínimo de acesso necessário para a sua tarefa de recolha. Um cliente de catálogo apenas de leitura não deve necessitar de permissões administrativas de escrita. Documente o esquema de autenticação, os âmbitos necessários, o tempo de vida do token e o procedimento de renovação suportado. Torne as falhas de autorização suficientemente distinguíveis para que um cliente possa parar ou solicitar a intervenção adequada.

As credenciais «bearer» devem ser protegidas, pois a sua posse permite a sua utilização. A especificação do token «bearer» do OAuth descreve a transmissão através do cabeçalho «Authorization» e os requisitos de segurança relativos aos tokens «bearer». Utilize o ponto de extremidade HTTPS documentado pelo fornecedor e não coloque segredos em cadeias de consulta comuns ou em saídas de diagnóstico.

As dicas da API REST relativas às credenciais são também dicas de implementação. Forneça segredos através do mecanismo de gestão de segredos da aplicação, oculte os cabeçalhos nos registos e separe as credenciais de desenvolvimento das credenciais de produção. Registe um identificador de credencial não confidencial caso os operadores precisem de identificar qual a integração que falhou. O token em si não constitui uma prova útil num relatório de incidente.

Valide os destinos de continuação antes de anexar credenciais. Se a API devolver um URL de página seguinte, o consumidor deve garantir que este pertence à origem ou origens permitidas documentadas. O comportamento de redirecionamento também merece um tratamento explícito. Um ciclo genérico de seguimento de URLs não deve reencaminhar um cabeçalho de Autorização para um anfitrião arbitrário.

Para as APIs que conceber, mantenha o estado de autenticação separado do estado de recolha. A renovação de uma credencial não deve exigir que os clientes abandonem os seus dados armazenados desnecessariamente, mas a documentação deve explicar se um cursor está vinculado a uma conta, a um token ou a um conjunto de permissões. Uma alteração de âmbito pode alterar os registos visíveis, mesmo que um cursor continue a ser analisado.

Quando um fluxo de trabalho também utilizar uma sessão de navegador autorizada, compreenda em que medida os cookies HTTP diferem dos cabeçalhos de token da API. Não presuma que a cópia de uma sessão de navegador cria uma integração de API suportada. Utilize o mecanismo de acesso previsto para a interface e mantenha a propriedade explícita entre os trabalhadores.

6. Desenvolva o esquema sem corromper as coleções

Publique exemplos de registos comuns, valores opcionais em falta, coleções vazias e erros. Em seguida, faça com que o esquema formal corresponda a esses exemplos. Uma declaração de tipo que indique que um campo é sempre numérico é enganadora se o serviço, ocasionalmente, emitir uma cadeia de caracteres vazia para valores desconhecidos.

O JSON Schema pode descrever propriedades, campos obrigatórios e o tratamento de propriedades adicionais, conforme documentado na sua referência de objetos. Decida em que casos os consumidores devem ser tolerantes e em que casos devem falhar. Aceitar um novo campo opcional pode ser razoável; aceitar uma cadeia de caracteres quando é exigido um montante monetário pode ocultar uma alteração que quebra a compatibilidade.

As dicas sobre controlo de versões da API REST devem abranger tanto o significado como a forma. Alterar um preço de unidades menores para unidades maiores pode preservar o tipo numérico JSON, mas comprometer todos os cálculos. Renomear um valor de estado ou alterar a interpretação do fuso horário também pode ser uma alteração compatibilidade, mesmo quando um analisador genérico aceita a resposta.

Para os produtores, mantenham uma política de compatibilidade e comuniquem os períodos de descontinuação através dos canais que os vossos clientes realmente utilizam. Para os consumidores, fixem a versão da API suportada nos casos em que o fornecedor ofereça seleção de versão e mantenham exemplos de teste para essa versão. Não descubram uma migração apenas depois de um painel de controlo apresentar valores impossíveis.

Coloque em quarentena os registos inválidos com um motivo classificado e evidência de diagnóstico delimitada. Decida se um registo malformado faz com que a página falhe, se a execução falhe ou se permite a publicação parcial. Essa política depende da utilização a jusante, mas deve ser explícita. Eliminar silenciosamente linhas inválidas faz com que a saída pareça mais completa do que realmente é.

Armazene a versão de extração ou transformação juntamente com os dados aceites. Quando um erro no analisador for corrigido, essa versão ajuda a identificar quais os registos que podem necessitar de reprocessamento. Se as respostas brutas retidas forem aprovadas e suficientes, reprocesse-as antes de gerar pedidos repetidos desnecessários.

Estas dicas sobre a API REST estabelecem uma divisão útil: o produtor é responsável pelo contrato publicado, enquanto o consumidor é responsável pela validação em relação ao contrato e pelo significado do seu conjunto de dados derivado. Nenhuma das partes deve depender da outra para detetar todas as inconsistências.

7. Teste a recuperação como parte da experiência da API

Uma solicitação no «caminho ideal» prova muito pouco sobre um coletor que é executado de hora a hora. Crie fixtures ou um serviço de teste para uma página vazia, cursor repetido, cursor expirado, limite de taxa, JSON malformado, tipo de campo inesperado e interrupção após o armazenamento, mas antes da criação de um ponto de verificação. Defina o resultado esperado para cada caso antes de implementar a recuperação.

Para os produtores, estes cenários são tanto testes de documentação como testes de software. Se a equipa não conseguir indicar o que um cliente deve fazer quando um cursor expira a meio de uma execução, o contrato está incompleto. Resolva a ambiguidade e coloque a resposta junto à documentação do ponto de extremidade, onde os programadores de integração a possam encontrar.

Para os consumidores, acompanhe os resultados úteis: registos aceites, registos rejeitados, páginas concluídas, novas tentativas, idade do ponto de verificação e estado final de conclusão. Registe os IDs dos pedidos e os nomes dos pontos finais sem registar segredos ou dados pessoais desnecessários. Uma percentagem agregada de sucesso não deve ocultar o facto de que todas as grandes coleções terminam na sua página final.

As dicas sobre a API REST tornam-se práticas quando a observabilidade responde a uma questão empresarial. Pode um analista confiar que esta categoria foi totalmente recolhida? Os dados de ontem estão a ser reutilizados porque nada mudou ou porque a execução de hoje falhou? Deve uma tarefa a jusante prosseguir quando uma pequena fração dos registos foi colocada em quarentena? Defina essas decisões antes de automatizar a publicação.

Mantenha os exemplos reproduzíveis. Utilize uma sandbox ou um ambiente de teste local para testes de falha, em vez de sobrecarregar intencionalmente uma API ativa para descobrir os seus limites. Uma resposta de teste documentada é suficiente para verificar a análise e a classificação de novas tentativas; experiências de capacidade requerem planeamento e autorização separados.

Revise a integração após alterações no esquema, na autenticação e na paginação, e não apenas após falhas de transporte. Uma recolha fiável é uma relação entre uma API em evolução e um cliente em evolução. Um pequeno conjunto de testes de contrato torna essa relação visível antes que registos incorretos cheguem aos utilizadores.

Pontos-chave

  • Defina a identidade dos recursos, o significado dos campos e a integridade da recolha antes de selecionar os detalhes dos pontos finais. Os consumidores precisam de semântica que possam preservar ao longo das execuções.
  • Documente a continuação, a expiração e a consistência separadamente. Guarde pontos de verificação depois de os dados se tornarem duráveis e torne a reprodução segura.
  • Defina regras de repetição de tentativas que sejam delimitadas e específicas do fornecedor. Trate resultados ambíguos de gravação de forma diferente das leituras com falha.
  • Associe validadores a representações em cache, particione credenciais e caches corretamente e teste alterações no esquema antes de publicar dados derivados.

Perguntas frequentes

Uma exportação em massa deve ter a mesma interface que uma recolha ativa?

Pode partilhar as mesmas definições de recursos, mas poderá necessitar de um contrato de tarefa separado. Uma exportação de longa duração beneficia de um recurso de estado, de um período de retenção documentado e de uma descrição clara do intervalo de tempo ou do instantâneo representado. Mantenha esses detalhes do ciclo de vida explícitos, em vez de obrigar um cliente a manter um pedido aberto indefinidamente.

Um webhook pode substituir a reconciliação agendada?

Um webhook pode reduzir a frequência de sondagem, mas as suas garantias de entrega e repetição determinam que tipo de recolha adicional é necessária. Documente se os eventos podem ser duplicados, atrasados ou reenviados e como os consumidores podem recuperar um intervalo perdido. Trate os eventos como mais um contrato de entrada e utilize a reconciliação quando a garantia de integridade exigida exceder o comportamento documentado do fluxo de eventos.

A documentação deve incluir todas as linguagens de programação suportadas?

Forneça exemplos suficientes para o público-alvo da integração e mantenha o seu comportamento consistente. A autenticação, a codificação de URLs, a classificação de respostas e a paginação devem ter o mesmo significado em todos os exemplos. Um conjunto mais reduzido de exemplos atualizados é mais útil do que um conjunto extenso cujos trechos apresentem discrepâncias quanto ao contrato do endpoint ou omitam comportamentos importantes em caso de falha.

Transforme o contrato numa integração fiável

Aplique estas dicas de API REST a um fluxo de trabalho de recolha antes de expandir a interface. Escolha um recurso representativo, defina a sua identidade e o significado dos campos e simule um reinício a meio da paginação. Em seguida, repita o exercício para um token expirado, uma resposta «not-modified» e um registo que viole o esquema.

Esses cenários revelam decisões que um catálogo de pontos de extremidade pode deixar de considerar. Também proporcionam aos produtores e consumidores uma linguagem comum para analisar alterações: o que a resposta significa, o que o cliente deve persistir e qual o resultado que conta como completo. Mantenha esse acordo próximo de fixtures executáveis e da documentação publicada, para que sobreviva às mudanças na equipa.

Quando os dados de origem necessários estiverem disponíveis apenas em páginas web autorizadas, em vez de através de uma API adequada, avalie a API Scraper da WebScrapingAPI como entrada para a recolha. Aplique a mesma disciplina ao pipeline resultante: registos explícitos, recuperação limitada, validação e um estado de conclusão honesto.

Sobre o autor

Robert Sfichi, Desenvolvedor Full-Stack @ WebScrapingAPI

Robert Sfichi

Desenvolvedor Full-Stack

Robert Sfichi é membro da equipa da WebScrapingAPI, contribuindo para o produto e ajudando a criar soluções fiáveis que apoiam a plataforma e os seus utilizadores.

Comece a construir

Pronto para expandir a sua recolha de dados?

Junte-se a mais de 2.000 empresas que utilizam a WebScrapingAPI para extrair dados da Web à escala empresarial, sem quaisquer custos de infraestrutura.