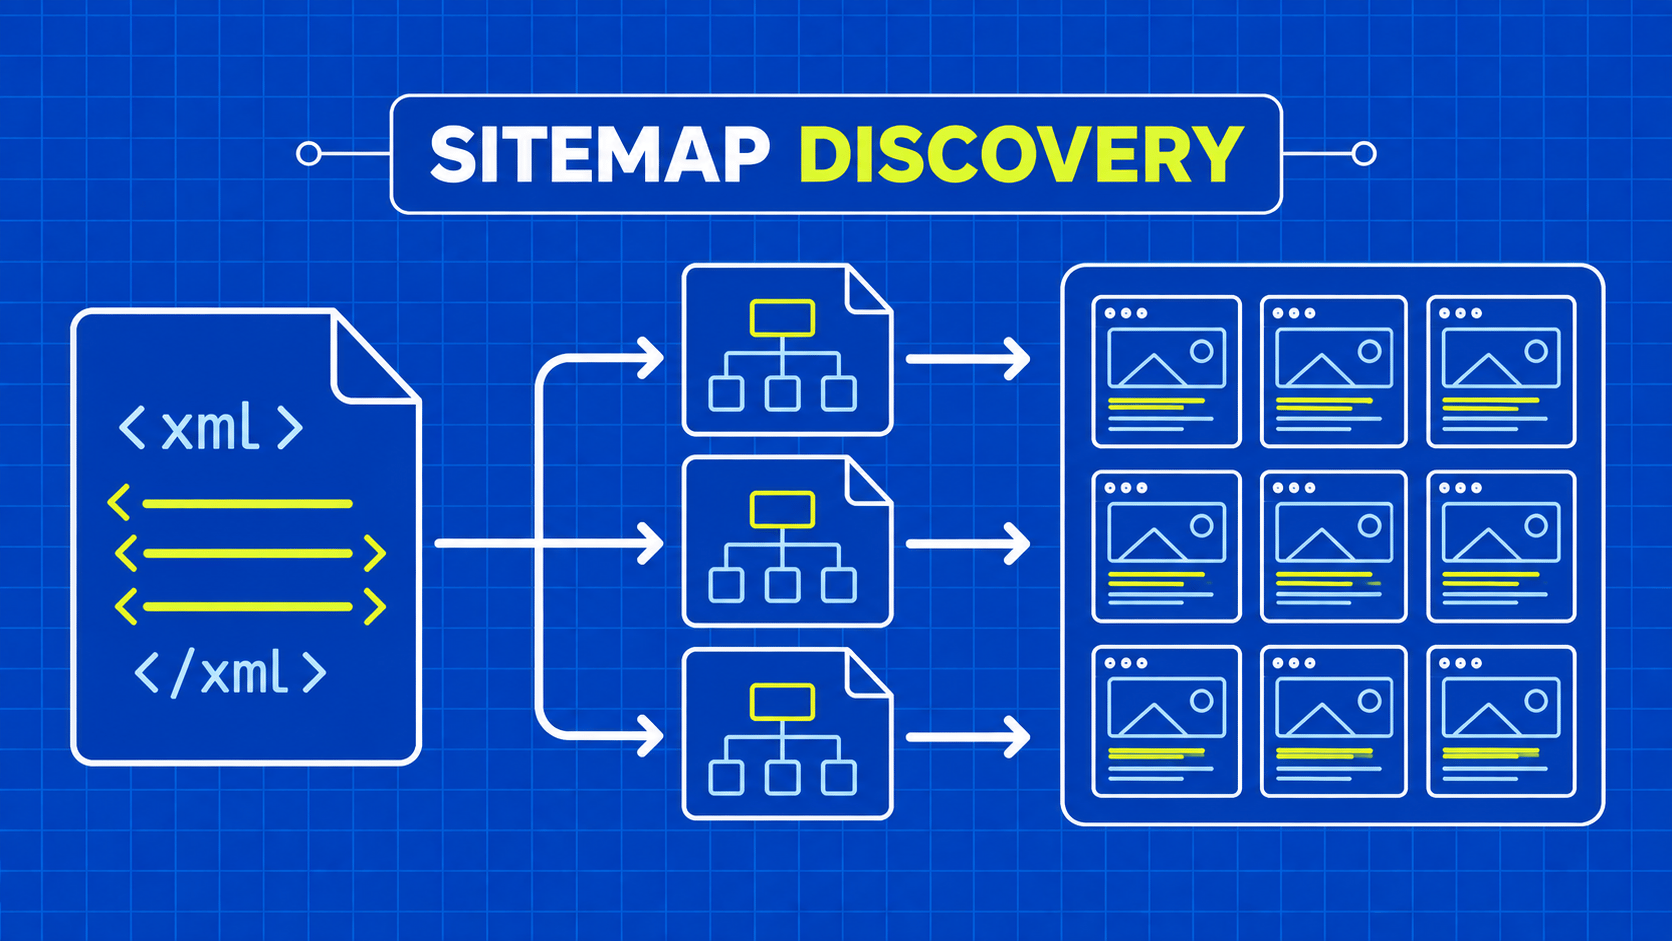
TL;DR: Um mapa do site é um ponto de partida para a descoberta, não um conjunto de dados completo nem uma autorização para obter todas as URLs listadas. Distinga conjuntos de URLs de índices, analisa os espaços de nomes de forma deliberada, trata os metadados de atualização como uma afirmação da fonte e impõe limites de recuperação antes de adicionar alvos a uma fila de recolha.
Uma categoria de produtos apresenta vinte links, mas o seu mapa do site lista milhares de endereços de produtos. A extração de dados de mapas do site pode ajudá-lo a descobrir esse conjunto de candidatos mais vasto sem ter de navegar por todos os menus. A distinção importante é que um mapa do site fornece localizações e metadados limitados; não fornece os próprios registos de produtos nem garante que todas as páginas listadas estejam disponíveis.
A descoberta baseada em mapas do site também altera o limite de confiança. Os ficheiros XML e os URLs neles contidos são entradas externas. Um analisador pode reconhecer um documento com sucesso, embora o endereço resultante esteja fora do âmbito da sua recolha. Um índice pode apontar para muitos documentos, e os ficheiros comprimidos podem expandir-se muito além do seu tamanho de transferência.
Este guia separa a descoberta, a validação e a recolha. Irá inspecionar os dois principais formatos XML, executar um programa local em Python, definir limites de percurso e decidir como utilizar lastmod sem o tratar como prova de alteração. O exercício utiliza documentos fictícios mantidos na memória e não efetua quaisquer pedidos de rede. Aplique o mesmo raciocínio a um site aprovado antes de adicionar as suas páginas descobertas a uma fila de recolha real.