Saltar para o conteúdo
Comece grátis

Blog

Perspetivas e Engenharia

Análises aprofundadas sobre a infraestrutura de dados da Web, técnicas de extração e o futuro dos dados estruturados em grande escala.

Artigos mais recentes

156 artigos

Web scraping em C e C++ com a libcurl e o lexbor
Guias

Web scraping em C e C++ com a libcurl e o lexbor

TL;DR: Extrair dados de sites em C e C++ com a libcurl e o lexbor: criar um rastreador C++20 «educado» com o CMake e o vcpkg, exportar ficheiros CSV e JSON organizados, lidar com páginas em JavaScript de três formas diferentes e executar o mesmo extrator em C puro.

Raluca Penciuc29 min read
Ler artigo
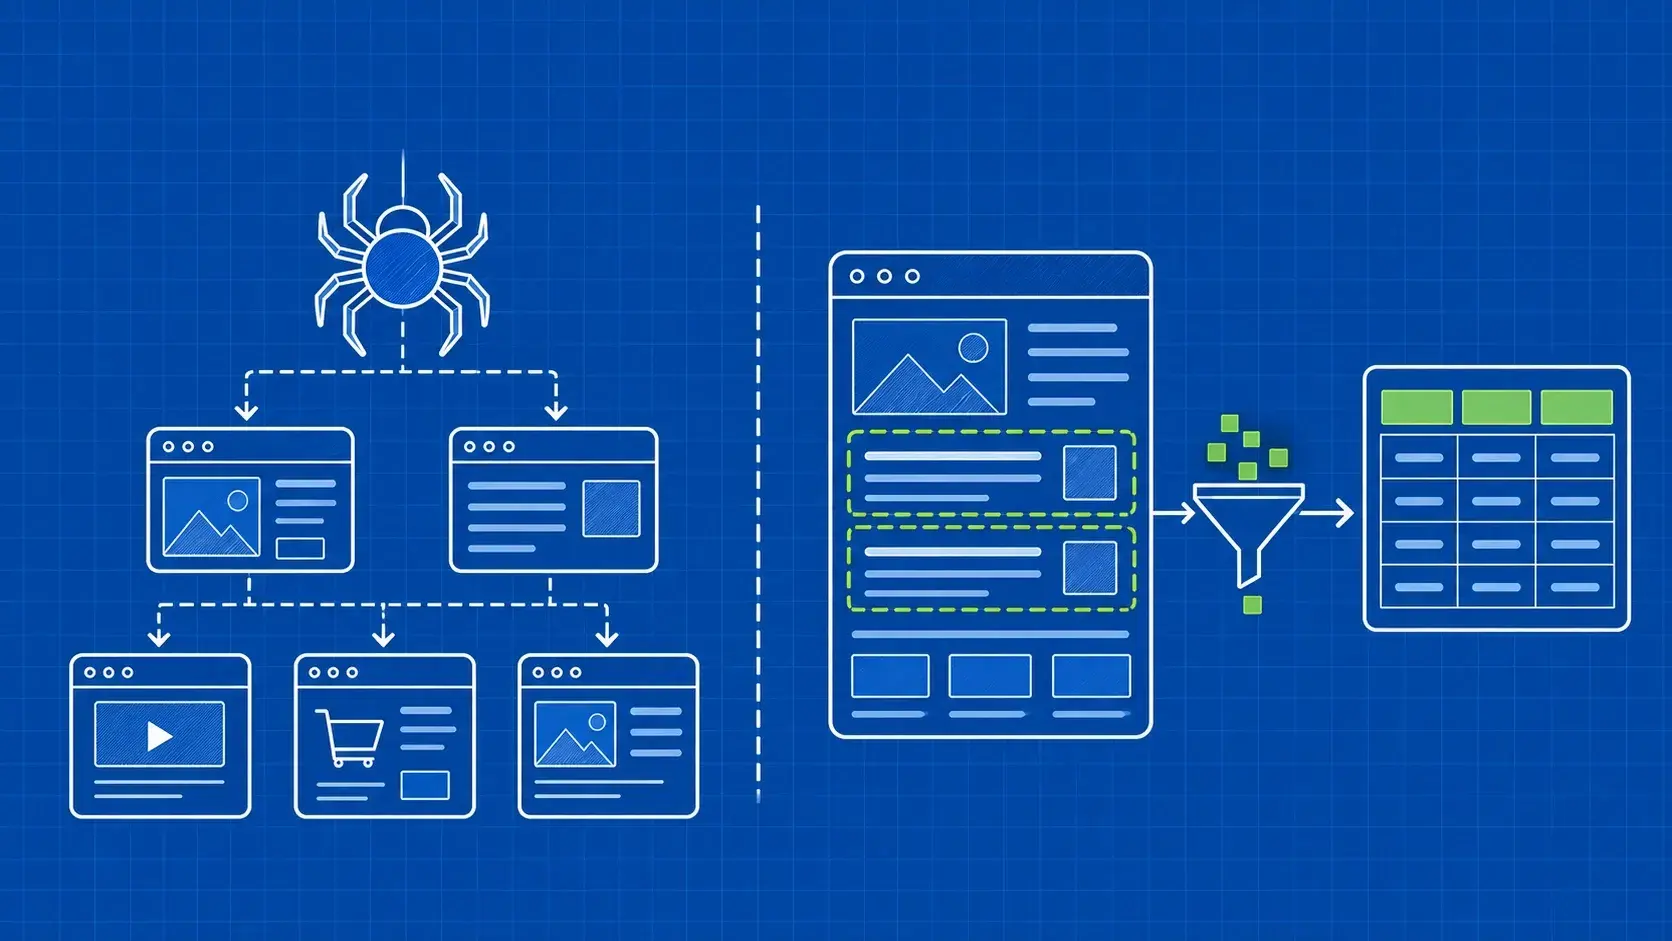
Web Scraping vs. Web Crawling: Guia para Principiantes
A ciência da extração de dados da Web

Web Scraping vs. Web Crawling: Guia para Principiantes

TL;DR: Saiba como os rastreadores encontram páginas e como os extratores de dados recolhem informações úteis. Siga o exemplo de uma livraria, compare os resultados obtidos e escolha o fluxo de trabalho adequado para o seu primeiro projeto.

Anda Miuțescu13 min read
Ler artigo
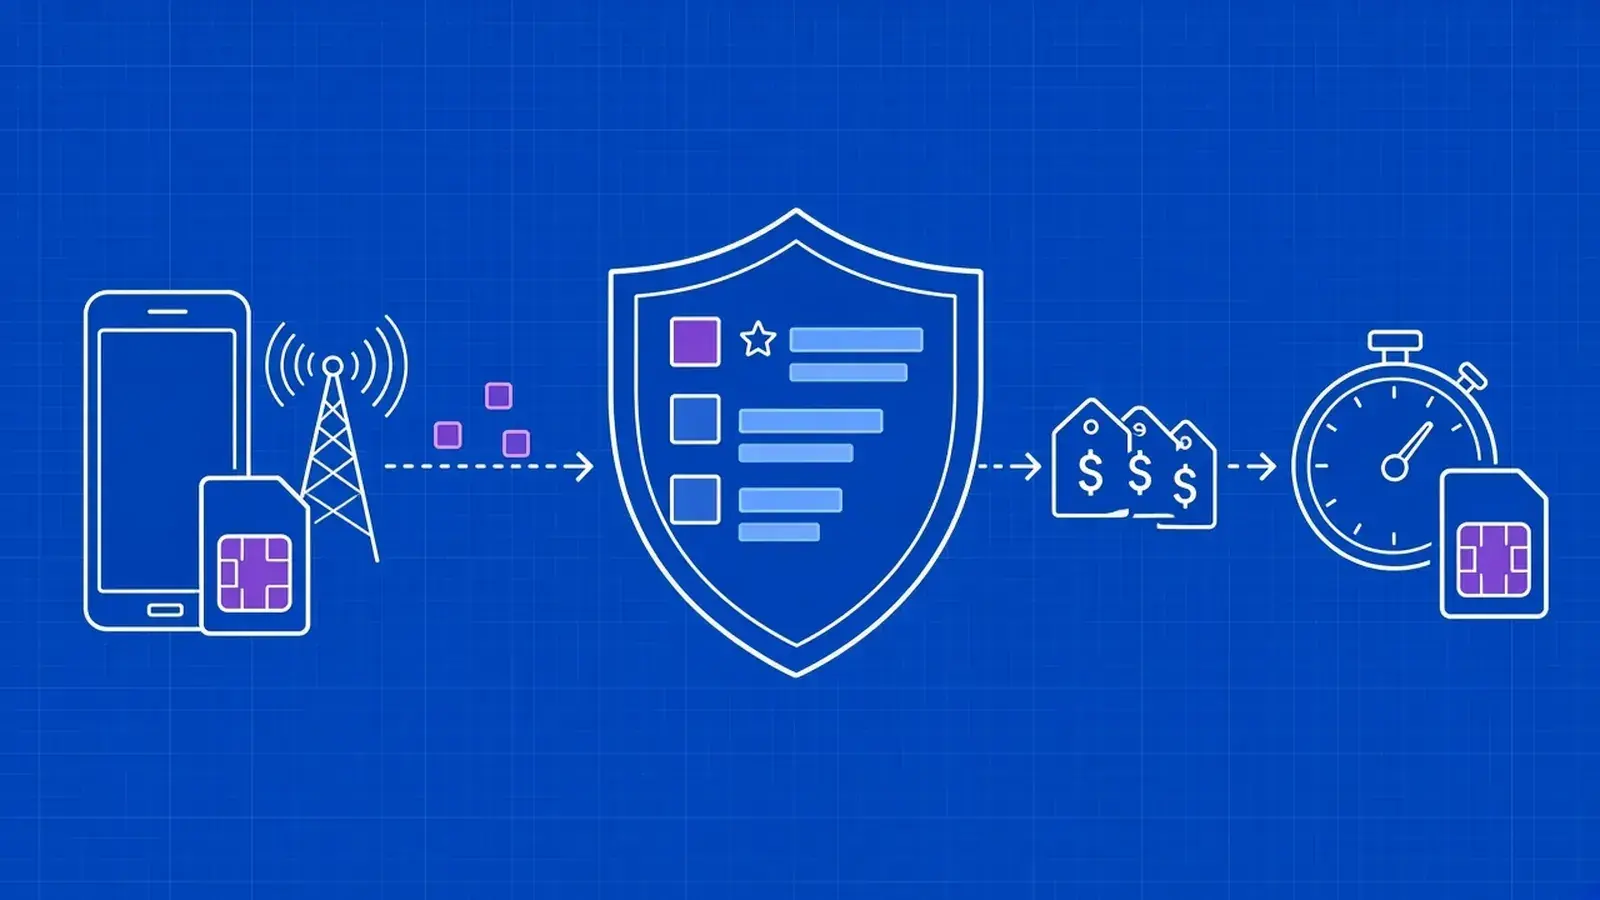
Melhores proxies móveis para web scraping em 2026: 9 provedores ranqueados
A ciência da extração de dados da Web

Melhores proxies móveis para web scraping em 2026: 9 provedores ranqueados

TL;DR: Compare 9 provedores de proxies móveis para scraping por preço por GB ou por porta, segmentação por operadora e ASN, 5G, sessões fixas e testes, em outubro de 2026.

Sergiu Inizian26 min read
Ler artigo
Melhores práticas de web scraping: um guia do ciclo de vida com dicas e código funcional
A ciência da extração de dados da Web

Melhores práticas de web scraping: um guia do ciclo de vida com dicas e código funcional

TL;DR: Melhores práticas de web scraping para cada fase do ciclo de vida de um scraper: planear os dados, respeitar o ficheiro robots.txt tal como definido pela RFC 9309, controlar o ritmo de cada host e respeitar o cabeçalho Retry-After, analisar de forma defensiva, validar cada registo, monitorizar as execuções, verificar o progresso e acompanhar o custo por registo válido. Cada fase inclui um pequeno fragmento de código Python funcional.

Anda Miuțescu33 min read
Ler artigo
Web scraping para SEO: criar uma auditoria baseada em dados concretos
Casos de utilização

Web scraping para SEO: criar uma auditoria baseada em dados concretos

TL;DR: Elabore uma auditoria de SEO autorizada que distinga os dados observados nas páginas dos resultados dos motores de busca. Compare a renderização, os sinais canónicos, as diretivas e as falhas nos modelos.

Gabriel Cioci15 min read
Ler artigo
Dicas sobre a API REST para uma recolha de dados fiável
Engenharia

Dicas sobre a API REST para uma recolha de dados fiável

TL;DR: Criar APIs que os coletores possam utilizar de forma fiável. Definir a paginação, as tentativas de repetição, os validadores, a autenticação, a evolução do esquema e a recuperação como contratos explícitos.

Robert Sfichi17 min read
Ler artigo

Comece a construir

Pronto para expandir a sua recolha de dados?

Junte-se a mais de 2.000 empresas que utilizam a WebScrapingAPI para extrair dados da Web à escala empresarial, sem quaisquer custos de infraestrutura.