Saltar para o conteúdo
Comece grátis

Blog

Perspetivas e Engenharia

Análises aprofundadas sobre a infraestrutura de dados da Web, técnicas de extração e o futuro dos dados estruturados em grande escala.

Artigos mais recentes

156 artigos

Web scraping com Ruby: Faraday, Nokogiri, Selenium
Guias

Web scraping com Ruby: Faraday, Nokogiri, Selenium

TL;DR: A extração de dados da Web com Ruby consiste no processo de solicitar conteúdo da Web, localizar valores úteis em HTML ou num documento apresentado pelo navegador e converter esses valores em registos estruturados através de código Ruby. A abordagem mais fácil de manter consiste em utilizar a combinação de ferramentas mais leve que consiga aceder aos dados de forma fiável.

Raluca Penciuc19 min read
Ler artigo
Web scraping com PHP em 2026: bibliotecas e código
Guias

Web scraping com PHP em 2026: bibliotecas e código

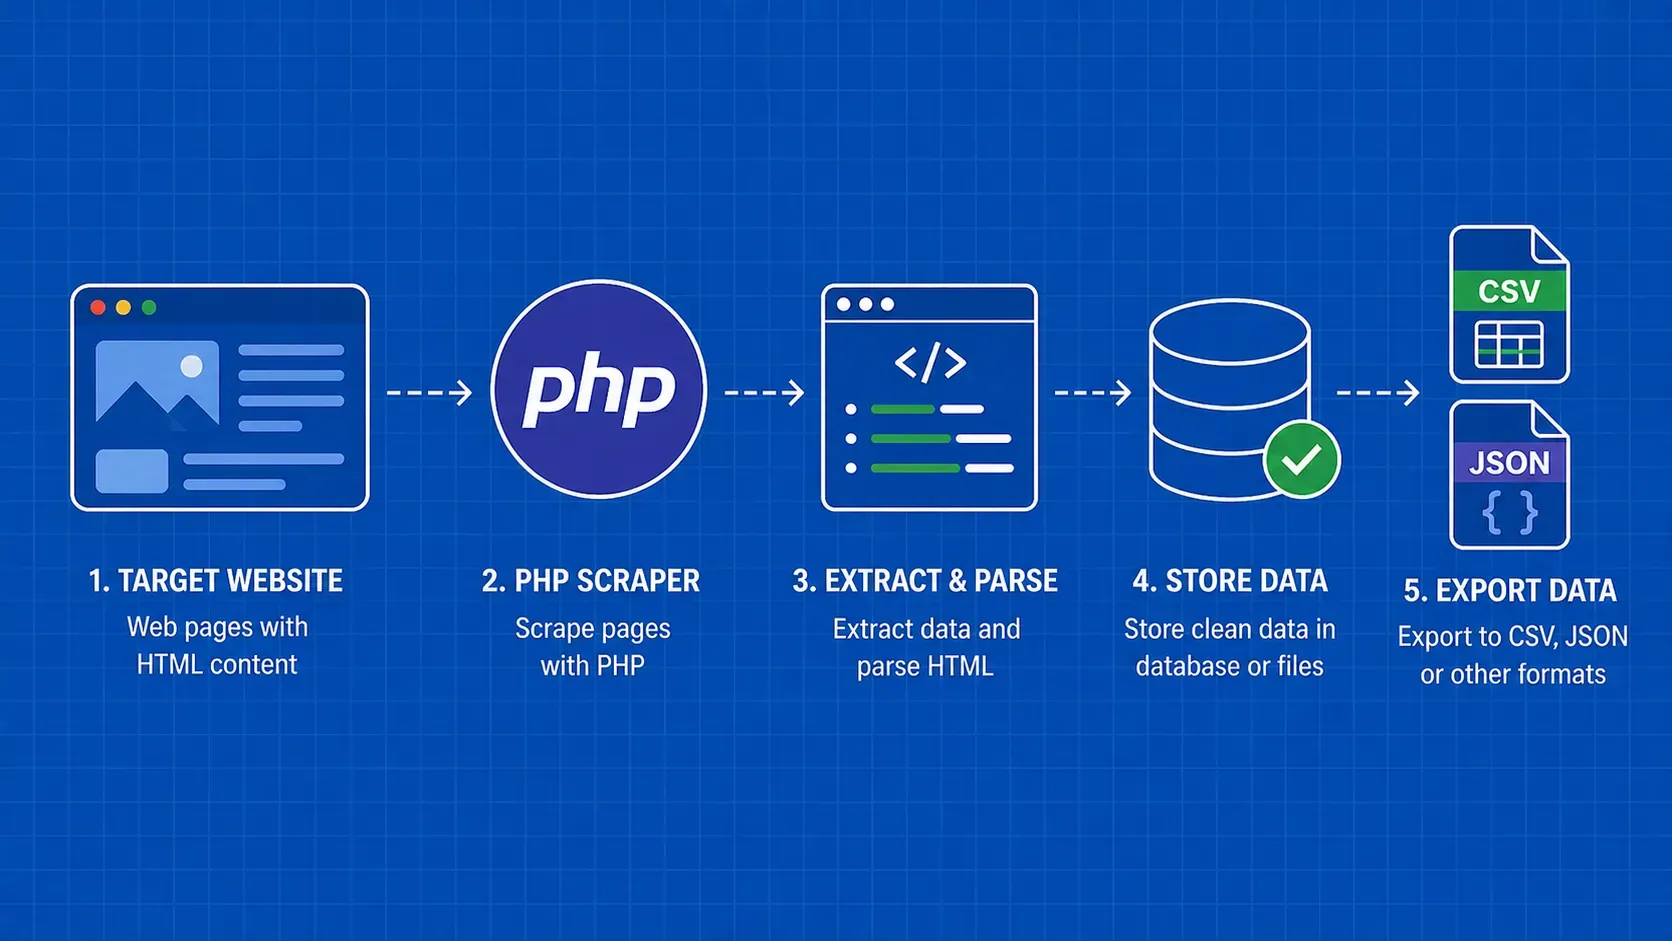
TL;DR: O PHP é uma linguagem perfeitamente capaz de fazer scraping da web, graças às extensões embutidas como cURL e DOMDocument, além de um rico ecossistema Composer que inclui Guzzle, Symfony DomCrawler e Symfony Panther para navegação sem cabeça. Este guia o orienta por todo o fluxo de trabalho: buscar páginas, analisar HTML, armazenar resultados em CSV/JSON/MySQL, tratar erros e evitar bloqueios.

Sorin-Gabriel Marica19 min read
Ler artigo
O que são proxies rotativos? Guia de rotação de IP para Web Scraping
A ciência da extração de dados da Web

O que são proxies rotativos? Guia de rotação de IP para Web Scraping

TL;DR: Então, o que são proxies rotativos, em uma linha? Servidores proxy que atribuem um IP diferente a cada solicitação de um pool gerenciado, que é como os scrapers passam pelos limites de taxa por IP, CAPTCHAs e filtros geográficos. Este guia aborda como a rotação funciona, os quatro tipos de pool, o código de configuração em três idiomas e como escolher um provedor.

Raluca Penciuc12 min read
Ler artigo
Folha de dicas de XPath para Web Scraping: Sintaxe, eixos e código real
Guias

Folha de dicas de XPath para Web Scraping: Sintaxe, eixos e código real

TL;DR: Esta folha de dicas de XPath cobre a sintaxe, predicados, eixos e funções que você realmente precisa para raspagem da web, além de uma tabela de tradução CSS-para-XPath e exemplos executáveis de Puppeteer e Scrapy. Use-a como referência na próxima vez que um seletor CSS quebrar silenciosamente em um site do qual você depende.

Mihai Maxim15 min read
Ler artigo
Como construir um rastreador da Web em Python: Do início à escala
A ciência da extração de dados da Web

Como construir um rastreador da Web em Python: Do início à escala

TL;DR: Um web crawler python automatiza o trabalho tedioso de seguir links em um site para descobrir e coletar conteúdo. Este guia orienta-o na construção de um de raiz com pedidos e BeautifulSoup, passando depois para Scrapy para rastreio concorrente, pipelines de itens e exportações de dados estruturados. Você também aprenderá como rastrear de forma responsável, girar proxies para evitar bloqueios e lidar com páginas renderizadas em JavaScript.

Suciu Dan31 min read
Ler artigo
Lista de proxies premium de 2026: classificação dos 9 serviços de proxy pagos
A ciência da extração de dados da Web

Lista de proxies premium de 2026: classificação dos 9 serviços de proxy pagos

TL;DR: Resumo: Para a maioria das equipas de scraping, a Oxylabs e a Decodo são os serviços de proxy premium mais fortes e versáteis, a Bright Data adequa-se a orçamentos empresariais e a Webshare é a forma mais barata de começar com uma lista estática. Escolha uma lista estática quando quer IPs que continuam seus durante o período de aluguer, e um gateway rotativo quando cada pedido ou sessão deve sair por um IP diferente.

Gabriel Cioci27 min read
Ler artigo

Comece a construir

Pronto para expandir a sua recolha de dados?

Junte-se a mais de 2.000 empresas que utilizam a WebScrapingAPI para extrair dados da Web à escala empresarial, sem quaisquer custos de infraestrutura.